
MySQL 分组查询的优化方法
在数据库实战开发的过程中,我们经常会遇到一些这样那样的问题,然后要卡好半天,等问题解决了才发现原来一些细节知识点还是没有掌握好。今天golang学习网就整理分享《MySQL 分组查询的优化方法》,聊聊优化、MySQL分组查询,希望可以帮助到正在努力赚钱的你。
MySQL 在处理 GROUP BY 和 DISTINCT 查询的方式在大多数情况下类似,事实上,在优化过程中有时候会把在这两种方式中转换。两类查询都能够从索引中受益,通常,这也是优化这两种查询最为重要的方式。
在无法使用索引时,MySQL 对于 GROUP BY 查询有两种策略:使用临时表或者 filesort 执行分组。对于给定的查询,两种方式都没法更高效。我们可以通过配置 SQL_BIG_RESULT 和 SQL_SMALL_RESULT 来指定优化器选择其中一个方式。
通常,对查询表的id 进行分组比使用值进行分组效率更高,例如下面的查询效率就比较低:
SELECT actor.first_name, actor.last_name, COUNT(*)
FROM sakila.file_actor
INNER JOIN sakila.actor USING(actor_id)
GROUP BY actor.first_name, actor.last_name;
而下面的查询方式则更有效:
SELECT actor.first_name, actor.last_name, COUNT(*)
FROM sakila.file_actor
INNER JOIN sakila.actor USING(actor_id)
GROUP BY film_actor.actor_id;
而使用 actor.actor_id 进行分组会比 film_actor.actor_id更高效。
这个查询能够发挥其优势的依据是演员(actor)的姓名是依赖于 actor_id 的,因此会返回相同的结果,但是如果返回的结果不同的话就不能这么做了。甚至有些时候服务端通过 SQL_MODE 配置禁用了 GROUP BY。此时如果不关心获取的值,而且用于分组的列的值是唯一的,这可以使用 MIN和 MAX 来解决这个问题。
SELECT MIN(actor.first_name), MAX(actor.last_name), ...;
对于完美主义者,他们会认为你的分组是错误的,他们也是对的。一个虚拟的 MIN 或 MAX 的结果是查询并不会正确地组装。然而,有时候你只是为了让 MySQL 更快地执行查询。完美主义者对于下面的查询会满意:
SELECT actor.fisrt_name, actor.last_name, c.cnt
FROM sakila.actor
	INNER JOIN (
    SELECT actor_id, COUNT(*) AS cnt
    FROM sakila.film_actor
    GROUP BY actor_id
  ) AS c USING(actor_id);
然而,子查询中创建和填充临时表的代价可能比理论上看起来的死办法更高。需要记住的是,子查询构建的临时表是没有索引的,这会导致性能上的下降。
通常在分组查询中,选择没有分组的列是一个糟糕的主意。这是因为查询结果是不确定的,一旦改变了索引或优化器使用了不同的策略都会导致结果被改变。事实上,我们建议将服务端的 SQL_MODE 设置为 ONLY_FULL_GROUP_BY,这时写了一个糟糕的分组查询时,系统会产生一个错误而不是直接执行。开启 ONLY_FULL_GROUP_BY 后,SELECT 的字段只能是 GROUP BY 指定的字段,此时可以通过构建分步查询或子查询的方式,先分组查出分组的列,再做二次查询。
MySQL 会根据 GROUP BY 指定的列次序自动分组,除非是使用了 ORDER BY 指定排序规则。如果不在乎次序并且发现了这导致了一个 filesort,这时候可以使用 ORDER BY NULL 来跳过自动排序。也可以通过在 GROUP BY 后面增加 DESC 或 ASC 来指定结果按指定的方向排序。
有时候可以在分组查询时要求 MySQL 在结果中做一次超级聚合。这可以通过在 GROUP BY 后面增加WITH ROLLUP 子句完成,但是这不一定能够达到优化的预期。可以通过 EXPLAIN 检查执行的方法,注意分组有没有通过 filesort 或临时表完成。然后在对相同的查询移除 WITH ROLLUP 后进行对比。通过对比也许可以找到优化的办法。
有些时候通过增加聚合查询会使得效率更高,虽然这种方式会返回更多的行。也可以通过在 FROM 后面嵌套子查询来保持中间查询结果,然后再使用 UNION 获取最终结果。
但是注意的是,在应用程序中最好是移除 WITH ROLLUP,而通过优化来完成分组查询。
结语:使用 GROUP BY 进行分组查询时最好是使用索引列分组,若无需指定次序可以使用 ORDER BY NULL 进行优化。倘若不按索引列分组的时候,则需要考虑变通的办法,并且考虑是否要使用子查询或使用 WITH ROLLUP 检查性能后再做优化。同时,为了防止分组查询出现不可预料的错误,最好是开启 ONLY_FULL_GROUP_BY。
文中关于mysql的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《MySQL 分组查询的优化方法》文章吧,也可关注golang学习网公众号了解相关技术文章。
 MySQL 分页查询的优化技巧
- 上一篇
- MySQL 分页查询的优化技巧

- 下一篇
- JDBC连接的六步实例代码(与mysql连接)
-
- 开放的铃铛
- 真优秀,一直没懂这个问题,但其实工作中常常有遇到...不过今天到这,帮助很大,总算是懂了,感谢大佬分享文章!
- 2023-03-12 10:15:52
-
- 激情的芒果
- 这篇文章太及时了,很详细,很好,码住,关注博主了!希望博主能多写数据库相关的文章。
- 2023-03-04 07:34:09
-
- 甜美的小甜瓜
- 太全面了,收藏了,感谢博主的这篇文章内容,我会继续支持!
- 2023-02-16 11:37:23
-
- 单纯的高山
- 这篇技术贴太及时了,作者大大加油!
- 2023-01-29 16:39:22
-
- 优雅的乌龟
- 太给力了,一直没懂这个问题,但其实工作中常常有遇到...不过今天到这,帮助很大,总算是懂了,感谢up主分享技术文章!
- 2023-01-21 16:41:22
-
- 追寻的老鼠
- 这篇博文真是及时雨啊,太全面了,很棒,码起来,关注楼主了!希望楼主能多写数据库相关的文章。
- 2023-01-19 15:05:39
-
- 英俊的小笼包
- 太全面了,码起来,感谢大佬的这篇技术贴,我会继续支持!
- 2023-01-19 02:09:46
-
- 数据库 · MySQL | 5小时前 |
- MySQL histogram 怎样用直方图解释选择性估算
- 122浏览 收藏
-
- 数据库 · MySQL | 5小时前 | MySQL · 正则表达式 · mysql regexp_replace 正则替换 pos occurrence match_type
- MySQL REGEXP_REPLACE 怎样只替换指定次数的文本
- 426浏览 收藏
-
- 数据库 · MySQL | 5小时前 |
- MySQL JSON_TABLE 结合 JSON_KEYS 读取动态对象键名
- 368浏览 收藏
-
- 数据库 · MySQL | 5小时前 |
- MySQL multi-valued index 怎样为 JSON 数组建立多值索引
- 139浏览 收藏
-
- 数据库 · MySQL | 6小时前 |
- MySQL named window 怎样复用多个查询的窗口定义
- 226浏览 收藏
-
- 数据库 · MySQL | 6小时前 | MySQL · JSON · 数据库运维 · mysql JSON_MERGE_PATCH JSON null JSON_REMOVE JSON合并
- MySQL JSON_MERGE_PATCH 怎样让 JSON null 删除对象成员
- 287浏览 收藏
-
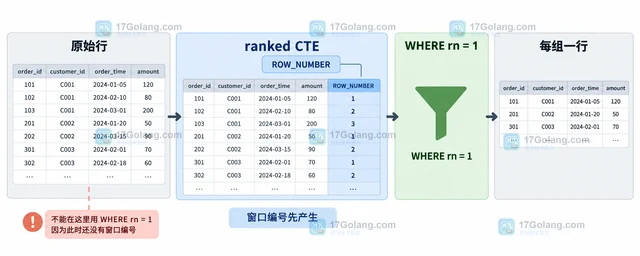
- 数据库 · MySQL | 6小时前 | MySQL · 窗口函数 ROW_NUMBER PARTITION BY 每组最新记录 MySQL window function
- MySQL window function 怎样用 ROW_NUMBER 取每组最新记录
- 123浏览 收藏
-
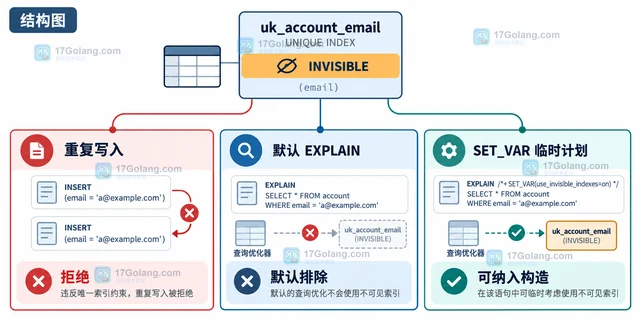
- 数据库 · MySQL | 6小时前 |
- MySQL invisible index 唯一索引设为不可见后约束还生效吗
- 335浏览 收藏
-
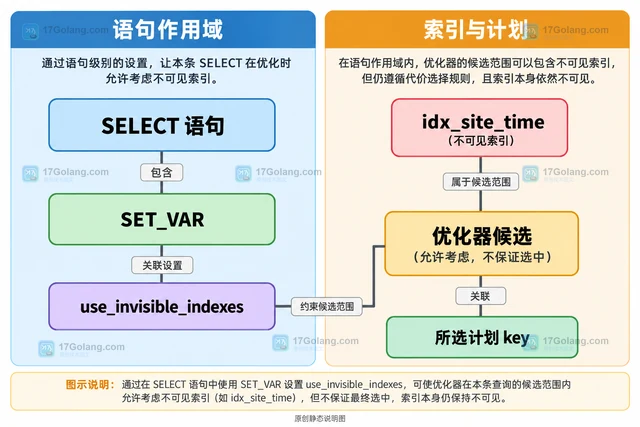
- 数据库 · MySQL | 6小时前 |
- MySQL invisible index 怎样临时让优化器使用不可见索引
- 345浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 669次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 686次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 733次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 701次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 536次使用
-
- 分析Go错误处理优化go recover机制缺陷
- 2023-01-01 483浏览
-
- gozero微服务高在请求量下如何优化
- 2023-01-01 268浏览
-
- Go 内联优化让程序员爱不释手
- 2023-01-07 177浏览
-
- Golang中重复错误处理的优化方法
- 2023-01-07 287浏览
-
- go time.After优化后性能提升34%内存减少67%
- 2023-02-25 352浏览


