
如何给MySQL添加自定义语法的方法示例
亲爱的编程学习爱好者,如果你点开了这篇文章,说明你对《如何给MySQL添加自定义语法的方法示例》很感兴趣。本篇文章就来给大家详细解析一下,主要介绍一下MySQL自定义语法,希望所有认真读完的童鞋们,都有实质性的提高。
1 背景
MySQL语法解析器用的bison(即yacc)来实现的,而词法解析是自己来实现的,涉及到的token都在文件lex.h里面,然后通过Lex_input_stream 里面相关的函数,解析client的sql字节流(其中会通过提前构造好的hash表帮助快速找到对应symbol,相关代码在sql_lex_hash.cc里面),转换为token,交给bison进行语法解析。
为了给MySQL添加一个新的语法,我们必须添加新的token(如果有新增),以及增加新的语法(sql_yacc.yy)里面。本文以给create table增加一个新的options为例,来演示如何给MySQL新增一个语法。最终的效果如下:
create table t1 (
  id int primary key,
  name varchar(100)
) global_partition by hash(id) partitions 10; //global_partition by为新增语法,global_partition为新增token
涉及到的修改文件如下:
sql/lex.h //token
sql/parse_tree_nodes.cc
sql/parse_tree_nodes.h
sql/parse_tree_partitions.cc
sql/parse_tree_partitions.h
sql/parser_yystype.h
sql/sql_yacc.yy
2 新增关键词(token)
文件:sql/lex.h
static const SYMBOL symbols[] = {
    /*
     Insert new SQL keywords after that commentary (by alphabetical order):
    */
    //省略部分代码
    {SYM("GLOBAL_PARTITION", GLOBAL_PARTITION_SYM)}, //注意按照字典序进行添加。
    //省略部分代码
};
按照上面的格式添加即可
3 新增语法
文件:sql/sql_yacc.yy
该文件为bison的语法,关于bison语法可以查看这里。下面凡是注释标有###为新增部分,没有标的注释是为了方便理解
%tokenGLOBAL_PARTITION_SYM 1309 /* seancheer */ //### 声明上一步添加的token,声明了才可以使用,编号1309选择一个未使用的就行 %type global_partition_clause //### 声明新增加的数据结构,后面会介绍 create_table_stmt: CREATE opt_temporary TABLE_SYM opt_if_not_exists table_ident '(' table_element_list ')' opt_create_table_options_etc //最后一个标记在YYSTYPE中对应的是create_table_tail, 后面会介绍 { $$= NEW_PTN PT_create_table_stmt(YYMEM_ROOT, $1, $2, $4, $5, $7, $9.opt_create_table_options, $9.opt_partitioning, $9.opt_global_partitioning, //### 赋值给对应参数,该构造函数需要新增,后面会介绍 $9.on_duplicate, $9.opt_query_expression); } | CREATE opt_temporary TABLE_SYM opt_if_not_exists table_ident opt_create_table_options_etc { $$= NEW_PTN PT_create_table_stmt(YYMEM_ROOT, $1, $2, $4, $5, NULL, $6.opt_create_table_options, $6.opt_partitioning, $6.opt_global_partitioning, //### 赋值给对应参数,该构造函数需要新增,后面会介绍 $6.on_duplicate, $6.opt_query_expression); //partition相关的语法 opt_create_partitioning_etc: partition_clause opt_duplicate_as_qe //这里是原生的partition表语法 { $$= $2; $$.opt_partitioning= $1; } | global_partition_clause opt_duplicate_as_qe //### 此处是新增的global_partition语法, { $$= $2; $$.opt_global_partitioning= $1; } | opt_duplicate_as_qe ; //### 下面为重点,新增的global_partition语法,可以看到,用到了新增的token global_partition_clause: GLOBAL_PARTITION_SYM BY part_type_def opt_num_parts { $$= NEW_PTN PT_global_partition($3, @4, $4); } ;
4 类似于PT_partition添加对应的数据结构global_partition_clause
文件:parser_yystype.h:该文件是bison(yacc)运行的一环,代替bison内置的YYSTYPE的,当bison对相关语法解析后,需要构造相关的数据结构,通过对YYSTYPE的自定义,就可以实现构造自定义数据结构的目的了。添加我们自定义的数据结构代码如下:
union YYSTYPE {
PT_sub_partition *opt_sub_part;
PT_part_type_def *part_type_def;
PT_partition *partition_clause;
PT_global_partition *global_partition_clause; //新加数据结构
struct {
Mem_root_array *opt_create_table_options;
PT_partition *opt_partitioning;
PT_global_partition *opt_global_partitioning; //同时注意添加到create_table_tail里面,因为create table语法会有该操作
On_duplicate on_duplicate;
PT_query_primary *opt_query_expression;
} create_table_tail;
};
static_assert(sizeof(YYSTYPE)
下面内容介绍PT_global_partition数据结构,为了保持和MySQL习惯一致,新增加的数据结构放在了
sql/parse_tree_nodes.cc sql/parse_tree_nodes.h sql/parse_tree_partitions.cc sql/parse_tree_partitions.h
四个文件里,理论上可以放在任何地方。可根据自身需求添加对应数据结构:
文件:sql/parse_tree_partitions.h sql/parse_tree_partitions.cc
/**
新增数据结构
*/
class PT_global_partition : public Parse_tree_node {
typedef Parse_tree_node super;
PT_part_type_def *const part_type_def;
const POS part_defs_pos;
uint num_parts;
public:
partition_info part_info;
public:
PT_global_partition(PT_part_type_def *part_type_def, const POS &part_defs_pos,
uint opt_num_parts)
: part_type_def(part_type_def),
part_defs_pos(part_defs_pos),
num_parts(opt_num_parts) {}
bool contextualize(Parse_context *pc) override;
};
//模仿其原生的实现方式即可
bool PT_global_partition::contextualize(Parse_context *pc) {
if (super::contextualize(pc)) return true;
Partition_parse_context part_pc(pc->thd, &part_info, false);
if (part_type_def->contextualize(&part_pc)) return true;
if (part_info.part_type != partition_type::HASH) {
//only support hash partition for shard key
my_error(ER_PARTITIONS_MUST_BE_DEFINED_ERROR, MYF(0), "NOT HASH");
return true;
}
uint count_curr_parts = part_info.partitions.elements;
if (part_info.num_parts != 0) {
if (part_info.num_parts != count_curr_parts) {
error(&part_pc, part_defs_pos,
ER_THD(pc->thd, ER_PARTITION_WRONG_NO_PART_ERROR));
return true;
}
} else if (count_curr_parts > 0)
part_info.num_parts = count_curr_parts;
return false;
}
文件:sql/parse_tree_nodes.cc sql/parse_tree_nodes.h
接下来修改create table对应的数据结构,将新增的PT_global_partition添加到create table里面
class PT_create_table_stmt final : public PT_table_ddl_stmt_base {
PT_partition *opt_partitioning;
PT_global_partition *opt_global_partitioning; //添加成员变量
PT_create_table_stmt(
MEM_ROOT *mem_root, PT_hint_list *opt_hints, bool is_temporary,
bool only_if_not_exists, Table_ident *table_name,
const Mem_root_array *opt_table_element_list,
const Mem_root_array *opt_create_table_options,
PT_partition *opt_partitioning,
PT_global_partition *opt_global_partitioning, On_duplicate on_duplicate,
PT_query_primary *opt_query_expression)
: PT_table_ddl_stmt_base(mem_root),
m_opt_hints(opt_hints),
is_temporary(is_temporary),
only_if_not_exists(only_if_not_exists),
table_name(table_name),
opt_table_element_list(opt_table_element_list),
opt_create_table_options(opt_create_table_options),
opt_partitioning(opt_partitioning),
opt_global_partitioning(opt_global_partitioning), //添加构造函数,主要是为了增加对PT_global_partition的赋值操作
on_duplicate(on_duplicate),
opt_query_expression(opt_query_expression),
opt_like_clause(nullptr) {}
//在其对应的函数中增加相关逻辑,调用对应的初始化函数contextualize
Sql_cmd *PT_create_table_stmt::make_cmd(THD *thd) {
if (opt_global_partitioning){
if (opt_global_partitioning->contextualize(&pc)) return nullptr;
lex->part_info = &opt_global_partitioning->part_info;
}
}
到此这篇关于如何给MySQL添加自定义语法的方法示例的文章就介绍到这了,更多相关MySQL添加自定义语法内容请搜索golang学习网以前的文章或继续浏览下面的相关文章希望大家以后多多支持golang学习网!
到这里,我们也就讲完了《如何给MySQL添加自定义语法的方法示例》的内容了。个人认为,基础知识的学习和巩固,是为了更好的将其运用到项目中,欢迎关注golang学习网公众号,带你了解更多关于mysql的知识点!
 MySQL查询性能优化武器之链路追踪
- 上一篇
- MySQL查询性能优化武器之链路追踪
- 下一篇
- MySQL中几种常见的嵌套查询详解
-
- 合适的树叶
- 这篇技术文章真是及时雨啊,好细啊,很好,码起来,关注师傅了!希望师傅能多写数据库相关的文章。
- 2023-04-23 04:27:48
-
- 结实的乌冬面
- 这篇文章内容真是及时雨啊,很详细,很好,收藏了,关注老哥了!希望老哥能多写数据库相关的文章。
- 2023-02-11 05:06:15
-
- 可爱的飞鸟
- 太全面了,收藏了,感谢作者的这篇文章,我会继续支持!
- 2023-01-28 13:00:18
-
- 欣喜的服饰
- 这篇文章内容真及时,太细致了,写的不错,已加入收藏夹了,关注楼主了!希望楼主能多写数据库相关的文章。
- 2023-01-27 17:26:12
-
- 安详的花瓣
- 写的不错,一直没懂这个问题,但其实工作中常常有遇到...不过今天到这,帮助很大,总算是懂了,感谢老哥分享技术文章!
- 2023-01-24 18:52:37
-
- 虚心的蜗牛
- 很棒,一直没懂这个问题,但其实工作中常常有遇到...不过今天到这,帮助很大,总算是懂了,感谢博主分享文章内容!
- 2023-01-24 12:31:49
-
- 顺心的裙子
- 细节满满,码起来,感谢师傅的这篇技术贴,我会继续支持!
- 2023-01-24 08:02:14
-
- 深情的酒窝
- 赞 ??,一直没懂这个问题,但其实工作中常常有遇到...不过今天到这,看完之后很有帮助,总算是懂了,感谢作者分享文章内容!
- 2023-01-19 02:19:43
-
- 害怕的花瓣
- 这篇文章出现的刚刚好,很详细,真优秀,码起来,关注师傅了!希望师傅能多写数据库相关的文章。
- 2023-01-18 00:55:24
-
- 数据库 · MySQL | 15小时前 | MySQL · 执行计划 · 慢查询 · EXPLAIN ANALYZE · 性能诊断 · MySQL EXPLAIN ANALYZE MySQL估算行数实际行数 MySQL执行计划耗时 MySQL慢查询诊断 MySQL TREE执行计划
- MySQL EXPLAIN ANALYZE对比估算行数与实际耗时的实现方法
- 262浏览 收藏
-
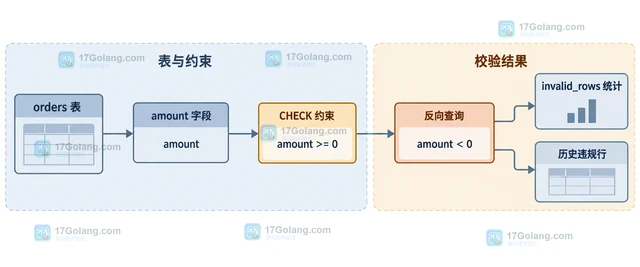
- 数据库 · MySQL | 17小时前 |
- MySQL CHECK 约束上线前清理不符合约束的旧数据的实现方法
- 475浏览 收藏
-
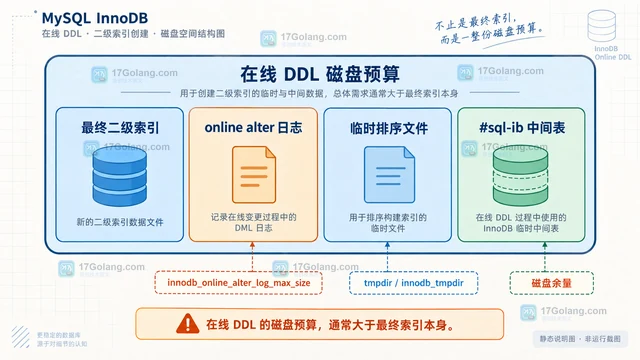
- 数据库 · MySQL | 18小时前 |
- MySQL 在线 DDL评估加索引时的锁与空间的实现方法
- 202浏览 收藏
-
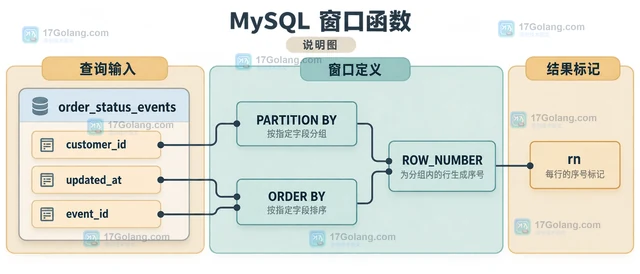
- 数据库 · MySQL | 19小时前 | MySQL · SQL查询 · 窗口函数 · ROW_NUMBER · 数据分组 · ROW_NUMBER PARTITION BY MySQL 窗口函数 每组最新记录 分组取最新
- MySQL 窗口函数按分组取每组最新记录的实现方法
- 185浏览 收藏
-
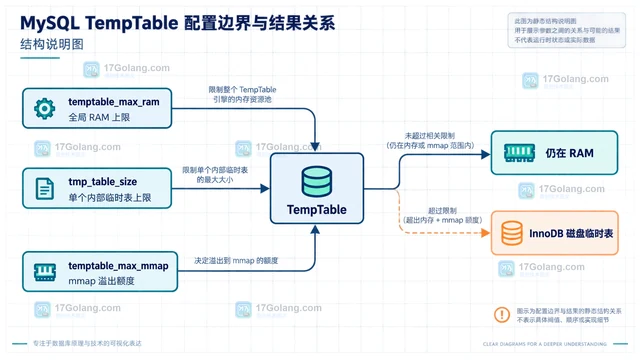
- 数据库 · MySQL | 22小时前 | MySQL · 数据库性能 · mysql 临时表 Performance Schema temptable_max_ram tmp_table_size
- MySQL temptable_max_ram 观察临时表内存阈值如何设置
- 409浏览 收藏
-
- 数据库 · MySQL | 1天前 | MySQL · 索引优化 · mysql Invisible Index 索引可见性
- MySQL invisible index 试验结束后如何恢复可见
- 118浏览 收藏
-
- 数据库 · MySQL | 1天前 |
- MySQL 角色继承权限后 SHOW GRANTS 如何解读
- 101浏览 收藏
-
- 数据库 · MySQL | 1天前 |
- MySQL 复制状态中 Retrieved_Gtid_Set 如何辅助定位缺口
- 221浏览 收藏
-
- 数据库 · MySQL | 1天前 | MySQL · 性能分析 · Performance Schema · SQL耗时 · mysql Performance Schema events_statements 平均耗时
- MySQL Performance Schema events_statements 如何找平均耗时
- 125浏览 收藏
-
- 数据库 · MySQL | 1天前 |
- MySQL LOAD DATA 导入 TSV 时如何处理字段内制表符
- 253浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 49次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 147次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 81次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 51次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 36次使用
-
- MySQL JSON_TABLE 展开数组时如何保留缺失字段
- 2026-09-10 501浏览
-
- MySQL 分区表怎么处理跨分区唯一键:分区列约束与建表取舍
- 2026-08-30 501浏览
-
- MySQL权限管理设置全攻略
- 2026-03-29 501浏览
-
- MySQL分片实现方法及常见方案解析
- 2025-06-24 501浏览
-
- MySQL表空间碎片怎么清理?超详细优化教程
- 2025-06-13 501浏览


