
能否在 golang 中实现数据流式传输?
来源:stackoverflow
2024-02-26 23:33:24
0浏览
收藏
积累知识,胜过积蓄金银!毕竟在Golang开发的过程中,会遇到各种各样的问题,往往都是一些细节知识点还没有掌握好而导致的,因此基础知识点的积累是很重要的。下面本文《能否在 golang 中实现数据流式传输?》,就带大家讲解一下知识点,若是你对本文感兴趣,或者是想搞懂其中某个知识点,就请你继续往下看吧~
问题内容
我想要处理一些内容不适合我的工作人员内存的文件。到目前为止我找到的解决方案涉及将处理结果保存到 /tmp 目录,然后将其上传到 s3。
import (
    "bufio"
    "bytes"
    "context"
    "fmt"
    "log"
    "os"
    "runtime"
    "strings"
    "sync"

    "github.com/aws/aws-sdk-go-v2/service/s3"
    "github.com/korovkin/limiter"
    "github.com/xitongsys/parquet-go/parquet"
    "github.com/xitongsys/parquet-go/writer"
)

func DownloadWarc(
    ctx context.Context,
    s3Client *s3.Client,
    warcs []*types.Warc,
    path string,
) error {
    key := fmt.Sprintf("parsed_warc/%s.parquet", path)

    filename := fmt.Sprintf("/tmp/%s", path)
    file, err := os.Create(filename)
    if err != nil {
        return fmt.Errorf("error creating file: %s", err)
    }
    defer file.Close()

    bytesWriter := bufio.NewWriter(file)
    pw, err := writer.NewParquetWriterFromWriter(bytesWriter, new(Page), 4)
    if err != nil {
        return fmt.Errorf("Can't create parquet writer: %s", err)
    }

    pw.RowGroupSize = 128 * 1024 * 1024 //128M
    pw.CompressionType = parquet.CompressionCodec_SNAPPY

    mutex := sync.Mutex{}
    numWorkers := runtime.NumCPU() * 2
    fmt.Printf("Using %d workers\n", numWorkers)
    limit := limiter.NewConcurrencyLimiter(numWorkers)

    for i, warc := range warcs {
        limit.Execute(func() {
            log.Printf("%d: %+v", i, warc)
            body, err := GetWarc(ctx, s3Client, warc)
            if err != nil {
                fmt.Printf("error getting warc: %s", err)
                return
            }

            page, err := Parse(body)
            if err != nil {
                key := fmt.Sprintf("unparsed_warc/%s.warc", path)
                s3Client.PutObject(
                    ctx,
                    &s3.PutObjectInput{
                        Body:   bytes.NewReader(body),
                        Bucket: &s3Record.Bucket.Name,
                        Key:    &key,
                    },
                )
                fmt.Printf("error getting page %s: %s", key, err)
                return
            }

            mutex.Lock()
            err = pw.Write(page)
            pw.Flush(true)
            mutex.Unlock()
            if err != nil {
                fmt.Printf("error writing page: %s", err)
                return
            }
        })
    }

    limit.WaitAndClose()
    err = pw.WriteStop()
    if err != nil {
        return fmt.Errorf("error writing stop: %s", err)
    }
    bytesWriter.Flush()

    file.Seek(0, 0)
    _, err = s3Client.PutObject(
        ctx,
        &s3.PutObjectInput{
            Body:   file,
            Bucket: &s3Record.Bucket.Name,
            Key:    &key,
        },
    )
    if err != nil {
        return fmt.Errorf("error uploading warc: %s", err)
    }

    return nil
}
有没有办法避免将内容保存到临时文件中,并在编写器和上传函数之间仅使用有限大小的字节缓冲区?
换句话说,我可以开始将数据流式传输到读取器,同时仍然写入同一缓冲区吗?
正确答案
是的,有一种方法可以将相同的内容写入多个作者。使用 io.MultiWriter 可能允许您不使用临时文件。但是,使用临时文件可能仍然不错。
我经常使用 io.MultiWriter 写入校验和(sha256...)计算器列表。实际上,上次我阅读 S3 客户端代码时,我注意到它在幕后执行此操作来计算校验和。 MultiWriter 对于在云位置之间传输大文件非常有用。
此外,如果您最终使用临时文件。您可能想要使用 os.CreateTemp 创建临时文件。否则,如果您的代码在两个进程中运行或者您的文件具有相同的名称,则可能会遇到创建的文件名问题。
请随时澄清您的问题。我可以尝试再次回答:)
终于介绍完啦!小伙伴们,这篇关于《能否在 golang 中实现数据流式传输?》的介绍应该让你收获多多了吧!欢迎大家收藏或分享给更多需要学习的朋友吧~golang学习网公众号也会发布Golang相关知识,快来关注吧!
版本声明
本文转载于:stackoverflow 如有侵犯,请联系study_golang@163.com删除
 i/o 超时问题和 https 内存泄漏在 SQS 中的表现
- 上一篇
- i/o 超时问题和 https 内存泄漏在 SQS 中的表现
- 下一篇
- 苹果决定放弃折叠屏幕项目,将专注于iPad或MacBook大屏幕设备的开发
查看更多
最新文章
-
- Golang · Go问答 | 13小时前 |
- Go ColumnTypes 推断动态查询字段的安全用法
- 319浏览 收藏
-
- Golang · Go问答 | 13小时前 | Go问答 · Go 错误检查 database/sql Rows.Err
- Go Rows.Err 在迭代结束后的错误检查
- 266浏览 收藏
-
- Golang · Go问答 | 14小时前 |
- Go sql.Scan NULL 到字符串失败的字段适配
- 388浏览 收藏
-
- Golang · Go问答 | 14小时前 |
- Go Tx.Stmt 复用预处理语句的生命周期
- 154浏览 收藏
-
- Golang · Go问答 | 14小时前 |
- Go 事务隔离级别设置未生效的驱动边界
- 165浏览 收藏
-
- Golang · Go问答 | 15小时前 |
- Go DB PingContext 启动探活的超时配置
- 438浏览 收藏
-
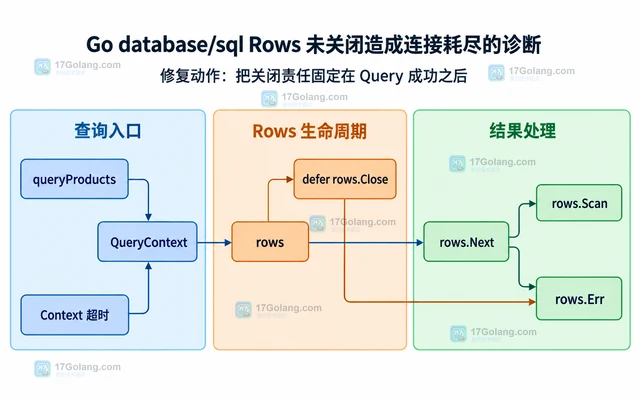
- Golang · Go问答 | 15小时前 |
- Go database/sql Rows 未关闭造成连接耗尽的诊断
- 354浏览 收藏
-
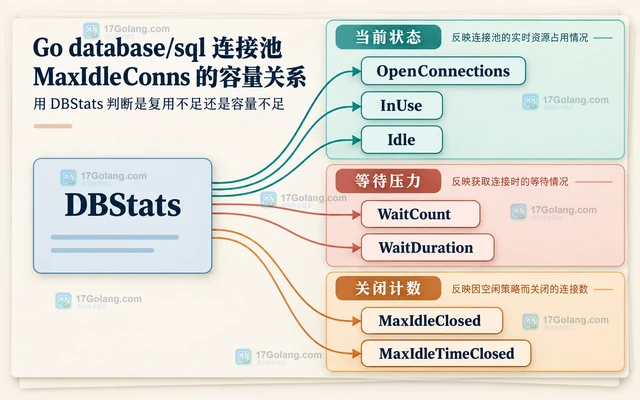
- Golang · Go问答 | 16小时前 |
- Go database/sql 连接池 MaxIdleConns 的容量关系
- 478浏览 收藏
-
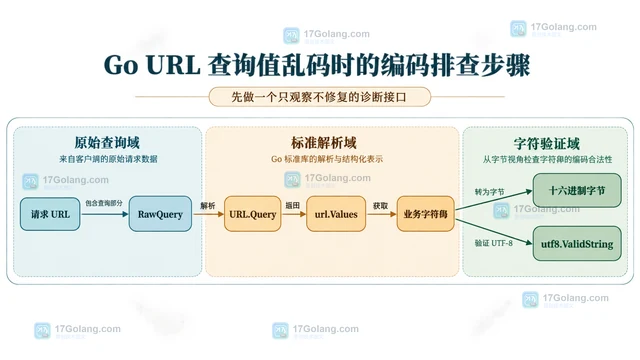
- Golang · Go问答 | 16小时前 |
- Go URL 查询值乱码时的编码排查步骤
- 285浏览 收藏
-
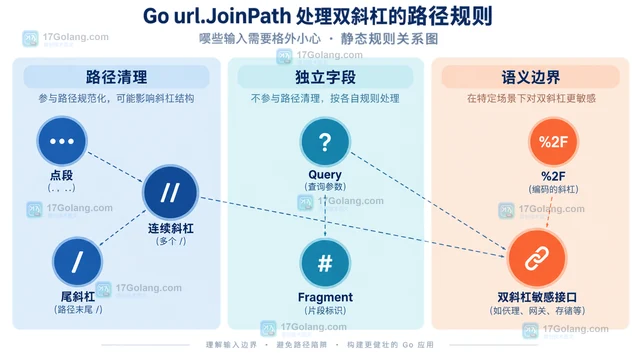
- Golang · Go问答 | 17小时前 | Go问答 · Go URL路径 url.JoinPath PathEscape 双斜杠
- Go url.JoinPath 处理双斜杠的路径规则
- 446浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 263次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 312次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 293次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 269次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 87次使用
查看更多
相关文章
-
- 用Nginx反向代理部署go写的网站。
- 2023-01-17 502浏览
-
- GoLand调式动态执行代码
- 2023-01-13 502浏览
-
- Go tls.GetCertificate 为什么收不到空 ServerName 请求
- 2026-09-27 501浏览
-
- Go sql.Tx提交成功前读取结果导致事务边界混乱的修复方法
- 2026-09-20 501浏览
-
- Go select 用 time.After 做超时有什么资源代价
- 2026-09-10 501浏览