详细介绍
V-JEPA:Meta推出的视频自监督学习新方法
V-JEPA(Video Joint-Embedding Predictive Architecture)是Meta的研究人员推出的一种创新型视频自监督学习方法。它通过预测视频帧之间的特征表示来学习视频的视觉表示,无需依赖外部监督。
主要特点:
- 自监督学习:V-JEPA不依赖于预训练的图像编码器、文本、负例、像素级重构或其他形式的外部监督,完全通过自监督学习来训练模型。
- 特征预测目标:模型的核心目标是通过预测视频帧之间的特征表示,提升视频理解能力。
- 联合嵌入架构:采用特殊的网络架构,包括一个编码器和一个预测器,实现高效的特征学习。
- 多块掩蔽策略:在训练过程中,V-JEPA使用多块掩蔽策略来处理视频帧,增强模型的学习效果。
- 高效的预训练数据集:模型在大规模数据集上进行预训练,确保其在多种任务中的表现。
- 无需模型参数调整:训练出的模型在多种下游任务上表现出色,无需进行参数调整。
主要功能:
- 视频预处理:将视频帧转换为模型可以处理的格式,确保数据的有效输入。
- 编码器:通过视觉Transformer编码器将视频帧转换为特征表示,捕捉视频内容的关键信息。
- 掩蔽:随机选择视频帧区域进行掩蔽,作为模型预测的目标,增强模型的预测能力。
- 预测器:基于编码器输出的特征表示,预测被掩蔽区域的特征,实现精确的特征预测。
- 损失函数:使用L1损失计算预测特征和目标特征之间的误差,优化模型的预测精度。
使用示例:
- 动作识别:利用V-JEPA模型对视频内容进行精确的动作识别,应用于智能监控、体育分析等领域。
- 运动分类:对视频中的运动模式进行分类,广泛应用于健身、舞蹈等运动分析场景。
- 图像任务:将V-JEPA模型应用于ImageNet图像分类等图像任务,展示其在图像领域的强大能力。
总结:
V-JEPA作为一种创新的自监督学习模型,通过预测视频帧的特征表示来学习视频的视觉表示。这种方法不仅能高效处理视频内容,还能在图像任务上表现出色,具有广泛的应用潜力。
查看更多
最新文章
Go bytes.Clone 后修改原切片为什么不再影响副本
解释 Go bytes.Clone 为什么能让副本与原切片隔离,覆盖切片头、底层数组、长度容量以及 ni
tuozi工具箱有哪些文件与文本工具?JSON编辑器、剪贴板和批量重命名说明
tuozi工具箱产品站的插件区域展示JSON编辑器、剪贴板、文件批量重命名等入口,本文按公开页面说明这些
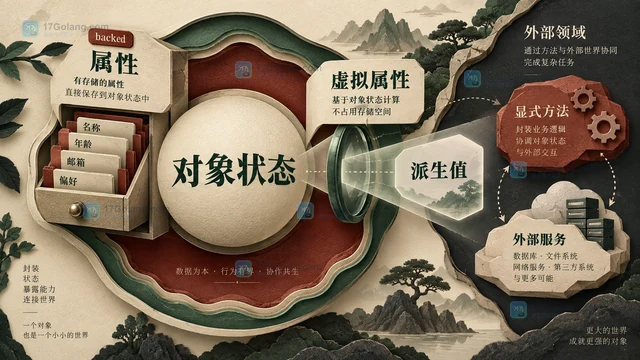
PHP 属性钩子怎么集中处理读写逻辑
PHP 8.4 属性钩子可以在属性边界集中处理校验、标准化和派生值,减少重复 getter/setter
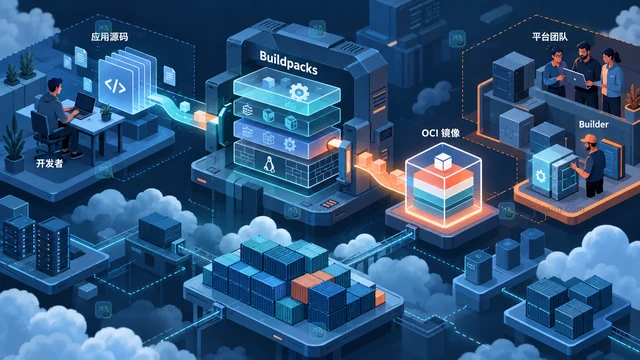
Cloud Native Buildpacks 毕业后应用构建生态会怎么变
Cloud Native Buildpacks 成为 CNCF 毕业项目,核心意义不是突然增加某个命令,
动漫岛有哪些内容分类?治愈系、热血燃与搞笑萌入口说明
动漫岛产品站首页提供看番与读漫画入口,并按治愈系、热血燃、甜宠恋、搞笑萌等兴趣方向展示内容分类。本文说明
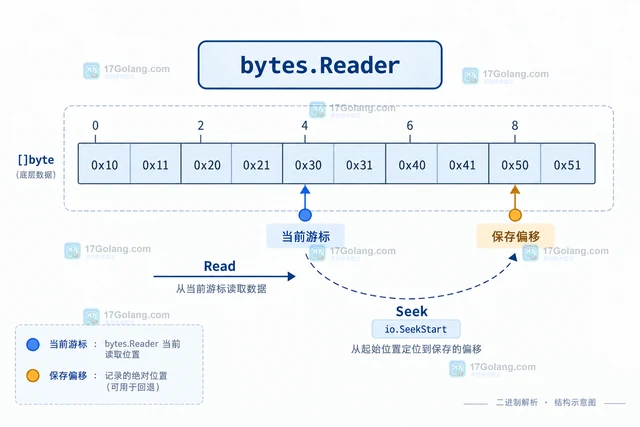
Go bytes.Reader 怎么实现可回退的二进制解析
用 Go bytes.Reader 保存绝对偏移、回退试读分支,并区分 Seek 越界、负位置、EOF