详细介绍

CogVLM2-LLaMA3-Caption:视频理解与描述生成的革新
CogVLM2-LLaMA3-Caption 是一个基于CogVLM2架构的视频描述生成模型,旨在通过理解视频内容,自动生成描述性文本标题或字幕,提升视频内容的可理解性和可访问性。
核心特点:
- 视频理解:通过先进的视觉分析技术,模型能够深入理解视频中的场景、对象和动作。
- 文本生成:基于视频内容生成自然流畅的文本描述,提升视频的文字化表达。
- 多模态处理:结合视觉和语言处理能力,实现更准确的视频理解和描述。
- 上下文感知:生成的描述与视频情境高度匹配,增强描述的相关性和准确性。
- 实时处理:支持实时视频描述生成,适用于直播和实时监控场景。
- 定制化描述:用户可以根据需求定制描述的长度、风格等,满足多样化的应用场景。
主要功能:
- 视频理解:深入分析视频内容,理解其中的视觉元素。
- 文本生成:自动生成视频描述或字幕,提升视频的可访问性。
- 多模态处理:处理视频图像和文本数据,实现跨模态的理解和生成。
- 上下文感知:理解视频的上下文,生成与情境相符的描述。
- 实时处理:适用于需要实时生成描述的场景,如直播或监控系统。
- 定制化描述:根据不同应用需求,提供定制化的描述服务。
技术原理:
- 视频理解与表示:利用卷积神经网络(CNN)提取视频的视觉特征,结合循环神经网络(RNN)或Transformer捕捉视频的时序信息。
- 注意力机制:通过注意力机制,模型能够关注视频中最相关的部分,生成更准确的描述。
- 序列学习:通过学习视频特征到文本信息的映射关系,实现从视觉到文本的转换。
项目地址:
- 可以在HuggingFace模型库中找到该模型,方便用户获取和使用。
应用场景:
- 视频字幕生成:自动生成字幕,帮助听障人士更好地理解视频内容。
- 视频内容分析:用于视频内容的索引和检索,提升视频内容的可搜索性。
- 教育和培训:作为学习材料的一部分,提供视频内容的文字描述,增强学习效果。
- 视频摘要:生成视频的文字摘要,帮助用户快速了解视频内容。
- 多语言支持:支持中英文描述,适用于多语言环境的视频应用。
总结:
CogVLM2-LLaMA3-Caption 通过其先进的多模态处理和上下文感知能力,为用户提供了一种快速理解和描述视频内容的强大工具。其实时处理和定制化描述功能,使其在视频字幕生成、内容分析、教育培训等多种场景中都展现出极高的应用价值。
查看更多
最新文章
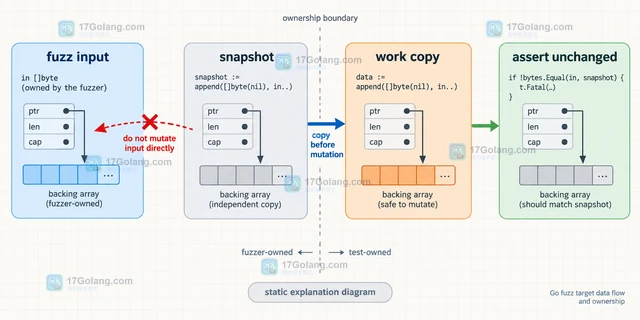
Go fuzz测试修改输入切片后影响后续用例的隔离方法
Go fuzz 测试遇到 []byte 被修改、后续用例结果漂移时,关键是建立输入所有权:保留原始快照,
照妖镜隐私权限怎么查看?相册、相机与网络权限核对说明
本文按公开产品资料页核对照妖镜工具箱的产品定位、权限项目与隐私检查方法,帮助安卓用户在安装和首次启动前明
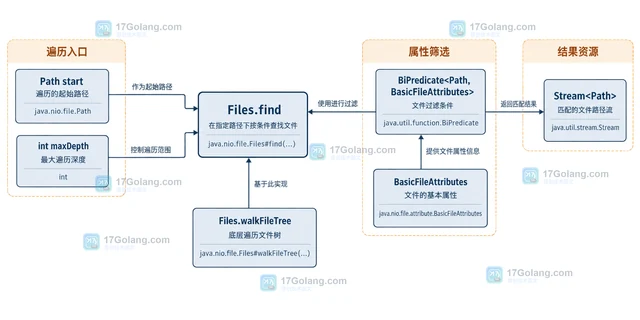
Java Files.find组合文件类型与大小条件的遍历方法
用 Java Files.find 组合普通文件、扩展名、大小和修改时间条件,掌握 maxDepth、B
photocolors在线版怎么用?无需下载的色盘与记忆卡片流程说明
photocolors提供浏览器在线入口,可从照片提取主色和HEX代码,并在色盘模式、记忆卡片模式之间选
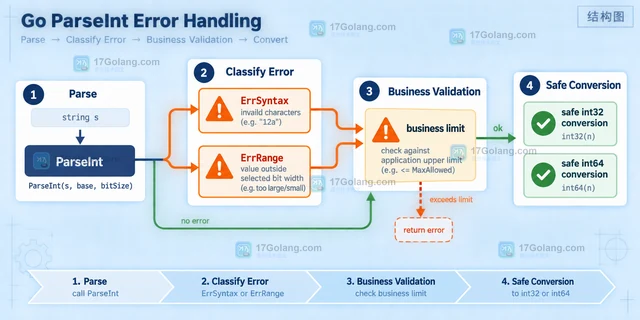
Go strconv.ParseInt处理边界数值和位宽的实现方式
用 Go strconv.ParseInt 按进制和位宽检查字符串整数,区分 ErrSyntax 与 E
永雏小菲语音盒音乐区有哪些功能?音效分类、播放与循环设置说明
永雏小菲语音盒公开产品资料页展示了变声模式、音效区和音乐区,本文按页面可见内容说明分类、播放控制、延迟、