详细介绍
Whisper:OpenAI开源的多语言自动语音识别系统
Whisper是由OpenAI开发并开源的神经网络,专注于英语语音识别,并在多语言处理上表现出色。它通过从网络收集的680,000小时的多语言和多任务监督数据进行训练,旨在提供接近人类的鲁棒性和准确性。
核心优势:
- 多语言支持:Whisper能够处理多种语言的语音识别和翻译,提升了跨语言沟通的便利性。
- 鲁棒性强:其训练数据集包含各种口音、背景噪音和技术术语,确保在复杂环境下的高识别准确性。
- 端到端架构:采用编码器-解码器Transformer模型,简化了处理流程,提高了效率。
- 零样本学习能力:即使在没有针对特定数据集进行微调的情况下,Whisper也能展现出优异的零样本性能。
主要功能:
- 语言识别:自动识别音频中的语言,为后续处理提供基础。
- 转录和翻译:不仅能转录原始语言的语音,还能将非英语音频翻译成英语,满足多语言需求。
- 特殊标记处理:通过特殊标记,Whisper能够执行语言识别、短语级时间戳、多语言语音转录和英语语音翻译等多项任务。
应用场景:
假设您有一段包含多种语言的音频文件,您可以使用Whisper:
- 将音频分割成30秒的片段。
- 将每个片段转换为对数Mel频谱图。
- 使用Whisper模型进行语音识别,得到文本转录。
- 如果需要,还可以将文本从原始语言翻译成英语。
总结:
Whisper作为一个开源的多语言自动语音识别系统,通过大规模和多样化的数据集训练,显著提升了在复杂环境下的语音识别能力。其开源特性为开发者和研究人员提供了丰富的应用和研究基础,Whisper的鲁棒性和多语言处理能力使其在语音识别领域具有广阔的应用前景。
查看更多
最新文章
Go database/sql Rows 没有关闭为什么连接耗尽怎样构造最小复现
database/sql 查询提前返回时,如果 Rows 没有关闭,连接可能持续处于使用中。本文用 Ma
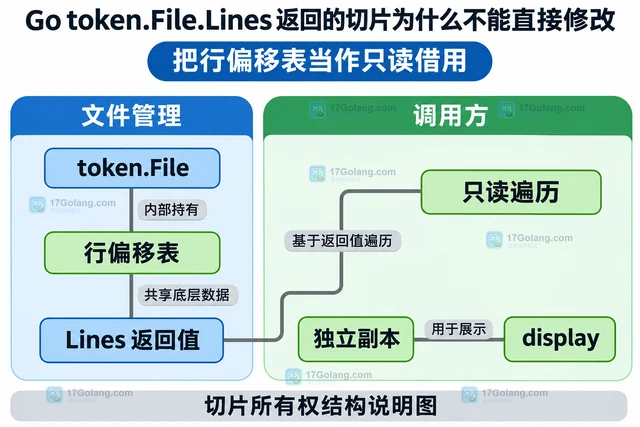
Go token.File.Lines 返回的切片为什么不能直接修改
Go token.File.Lines 的返回切片应按只读数据使用。本文解释切片赋值与独立复制的区别,给
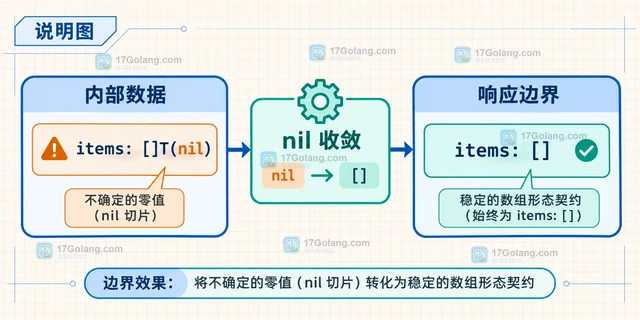
Go encoding/json omitempty 区分 nil 切片和空切片输出的处理方法
解释 Go encoding/json 中 nil 切片、空切片与 omitempty 的 JSON 输
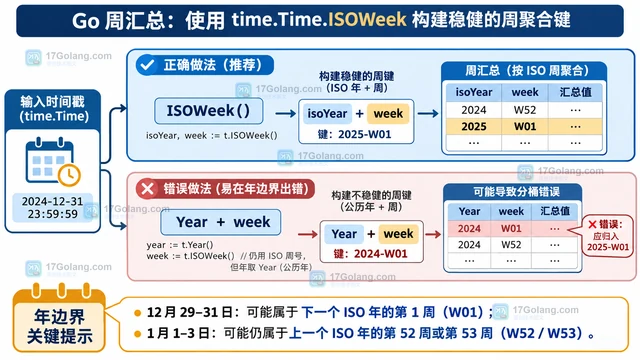
Go Time.ISOWeek 返回的年份为什么与 Year 不同
time.Time.Year 返回公历年,而 ISOWeek 返回 ISO 8601 的周所属年与周号。
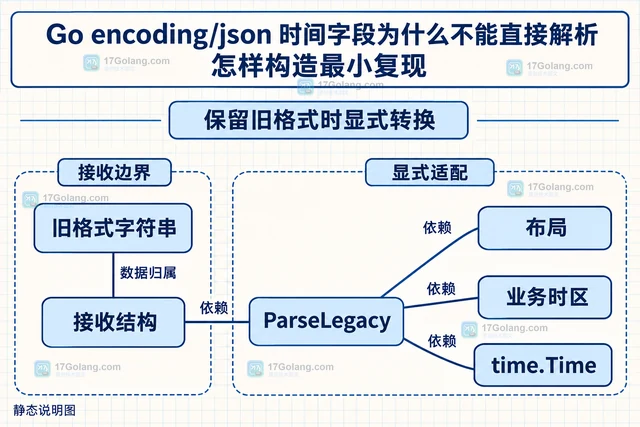
Go encoding/json 时间字段为什么不能直接解析怎样构造最小复现
Go JSON 时间字段解析失败常源于输入表示与 time.Time 的 RFC3339 契约不符。本文
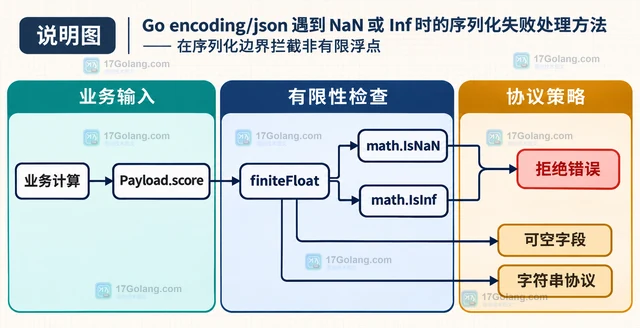
Go encoding/json 遇到 NaN 或 Inf 时的序列化失败处理方法
Go encoding/json 遇到 NaN、+Inf 或 -Inf 时会返回 Unsupported