详细介绍
Voicebox:Meta的尖端语音生成模型,开启语音合成新时代
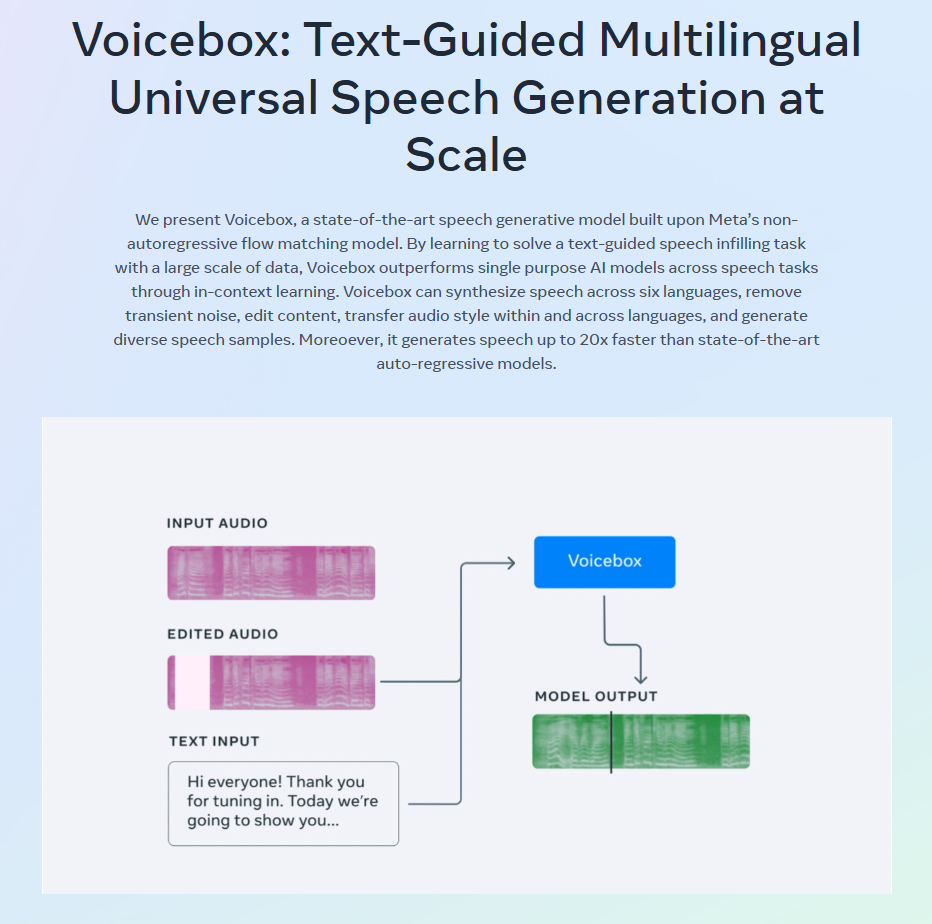
Voicebox是由Meta公司开发的一款革命性的语音生成模型,采用非自回归流匹配技术,能够通过大规模数据学习进行文本引导的语音填充任务。Voicebox不仅支持多语言合成,还能去除瞬态噪声、编辑内容、转换音频风格,并生成多样化的语音样本,其速度比现有自回归模型快20倍。
核心优势:
- 多语言支持:支持英语、法语、德语、西班牙语、波兰语和葡萄牙语,覆盖广泛的语言需求。
- 高效生成:比现有最先进的自回归模型快20倍,极大提升了语音生成效率。
- 上下文学习:通过上下文学习,执行未明确训练的任务,灵活性极强。
- 未来上下文利用:与传统自回归模型不同,Voicebox可以利用未来上下文,实现更精确的语音处理。
强大功能:
- 瞬态噪声去除:有效去除录音中的瞬态噪声,如门铃声或狗叫声,提升音质。
- 内容编辑:无需重新录音即可纠正误读的单词,简化编辑流程。
- 零样本文本到语音合成:通过上下文学习,合成具有任何音频风格的语音,满足多样化需求。
- 跨语言风格转换:跨语言转换音频风格,如使用法语提示生成英语语音,增强创作自由度。
- 多样化语音生成:通过采样技术,创造独特且富有表现力的音频风格,满足创意需求。
应用场景:
- 瞬态噪声去除:使用Voicebox重新生成被噪声污染的语音,提升录音质量。
- 内容编辑:对误读的文本进行编辑,Voicebox会相应调整语音输出,提高编辑效率。
- 零样本文本到语音合成:输入想要风格的参考音频和文本,Voicebox将合成听起来与参考一致的语音,满足个性化需求。
- 跨语言风格转换:使用非英语的音频提示生成英语语音,或将配音语音转换为原说话者的声音,增强跨语言交流。
- 多样化语音生成:Voicebox可以创建独特的音频风格,无需任何音频条件,激发创意灵感。
总结:
Voicebox作为Meta公司开发的多语言语音生成模型,凭借其上下文学习能力和高效生成速度,在语音合成、编辑和风格转换方面展现出了强大的潜力。尽管Voicebox具有巨大的应用前景,但Meta公司也意识到技术滥用的风险,并采取了相应措施,如建立有效的分类器来区分真实语音和由Voicebox生成的音频,以确保技术的负责任使用。目前,Voicebox模型和代码尚未公开提供,以确保其安全性和合规性。
查看更多
最新文章
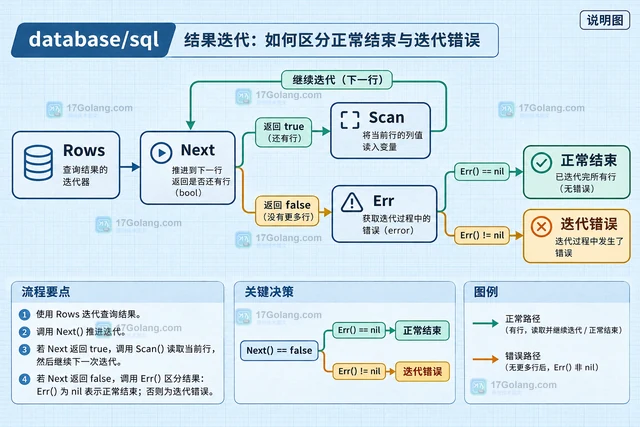
Go database/sql rows.Next 结束后怎样用 rows.Err 捕获迭代错误
Go database/sql 的 rows.Next 返回 false 只表示遍历结束,不能直接当作成
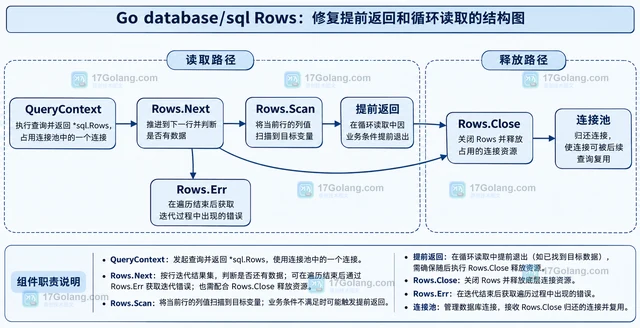
Go database/sql Rows 没有关闭为什么连接耗尽怎样构造最小复现
database/sql 查询提前返回时,如果 Rows 没有关闭,连接可能持续处于使用中。本文用 Ma
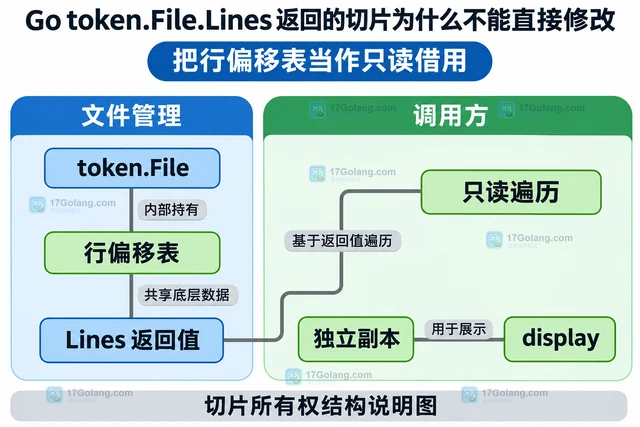
Go token.File.Lines 返回的切片为什么不能直接修改
Go token.File.Lines 的返回切片应按只读数据使用。本文解释切片赋值与独立复制的区别,给
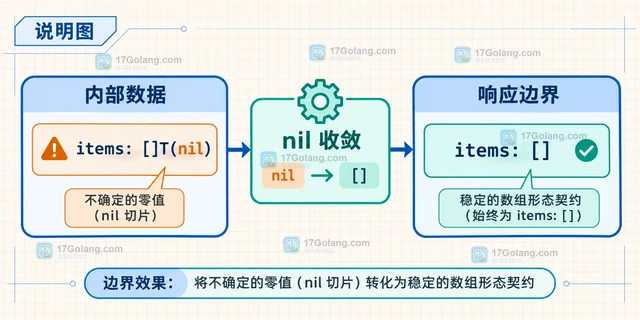
Go encoding/json omitempty 区分 nil 切片和空切片输出的处理方法
解释 Go encoding/json 中 nil 切片、空切片与 omitempty 的 JSON 输
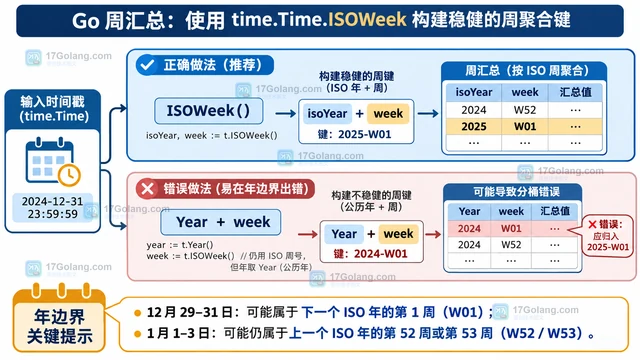
Go Time.ISOWeek 返回的年份为什么与 Year 不同
time.Time.Year 返回公历年,而 ISOWeek 返回 ISO 8601 的周所属年与周号。
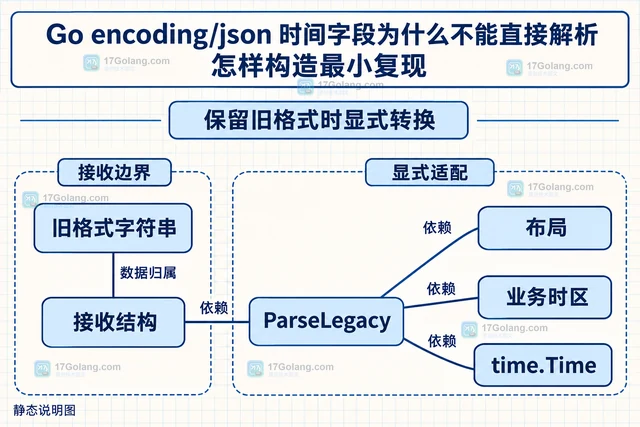
Go encoding/json 时间字段为什么不能直接解析怎样构造最小复现
Go JSON 时间字段解析失败常源于输入表示与 time.Time 的 RFC3339 契约不符。本文