FishSpeech:开源多语言文本到语音合成新标杆
FishSpeech,由FishAudio团队倾力打造,是一个开源且先进的多语言文本到语音(TTS)合成项目。通过融合大语言模型(LLM)技术,FishSpeech为用户带来高质量、多语言的语音合成体验。无论您是开发者还是最终用户,FishSpeech都将成为您在语音助手、语言学习工具和内容创作领域的得力助手。
核心功能
零样本与少样本 TTS
只需提供10到30秒的语音样本,FishSpeech即可生成高质量的TTS输出,满足您个性化的语音需求。多语言与跨语言支持
支持英语、日语、韩语、中文、法语、德语、阿拉伯语和西班牙语等多种语言,无缝切换,适用于全球用户。无需音素依赖
创新的无音素依赖模型,让FishSpeech能够处理任何语言脚本的文本,突破语言障碍。高精度与快速合成
在5分钟的英文文本中,字符错误率(CER)和词错误率(WER)仅为2%,并在Nvidia RTX 4060和RTX 4090上实现了1:5和1:15的实时率,满足实时应用需求。WebUI 和 GUI 推理
提供基于Gradio的WebUI推理界面,兼容Chrome、Firefox、Edge等主流浏览器;同时支持PyQt6图形界面,适用于Linux、Windows和macOS系统,让您轻松上手。易于部署
在Linux、Windows和macOS上快速搭建推理服务器,减少速度损失,提升效率。端到端集成
自动集成自动语音识别(ASR)和TTS部分,无需额外插件,实现真正的端到端语音合成。音色与情感控制
通过参考音频精准控制语音音色,并能够生成带有强烈情感的语音输出,提升语音的自然度和表现力。
主要特点
高精度与低延迟
在多语言文本合成中表现出极高的精度和快速的推理速度,适用于实时应用场景。强大的语言通用性
不依赖音素,能够处理多种语言脚本,无需额外的语言模型支持,实现真正的多语言合成。灵活的音色与情感控制
用户可以通过参考音频调整语音的音色和情感表达,提升语音合成的自然度和表现力。多平台支持
提供WebUI和GUI推理界面,支持主流操作系统,方便用户根据需求选择使用方式。开源与开放性
项目开源,支持社区贡献和二次开发,适合开发者进行定制化扩展。端到端集成
真正的端到端语音合成,无需额外插件,简化了使用流程,提升了用户体验。
FishSpeech不仅为用户提供了高效、精准的多语言TTS解决方案,还通过其开源特性,为开发者和社区提供了广阔的合作与创新空间。无论您是在寻找高质量的语音合成工具,还是希望参与到开源项目的开发中,FishSpeech都是您的不二之选。
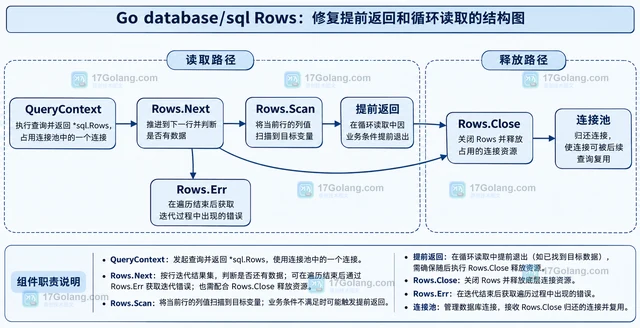
Go database/sql Rows 没有关闭为什么连接耗尽怎样构造最小复现
database/sql 查询提前返回时,如果 Rows 没有关闭,连接可能持续处于使用中。本文用 Ma
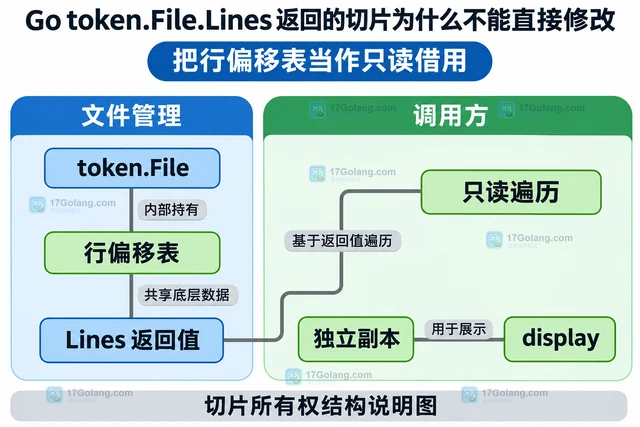
Go token.File.Lines 返回的切片为什么不能直接修改
Go token.File.Lines 的返回切片应按只读数据使用。本文解释切片赋值与独立复制的区别,给
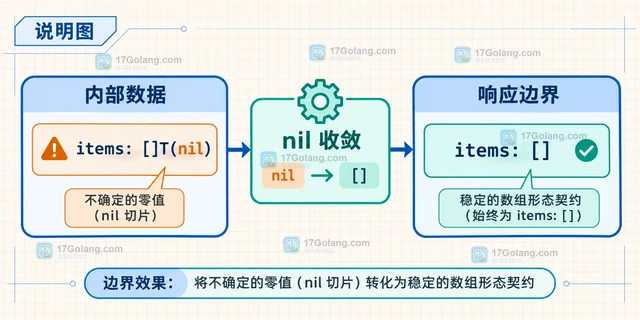
Go encoding/json omitempty 区分 nil 切片和空切片输出的处理方法
解释 Go encoding/json 中 nil 切片、空切片与 omitempty 的 JSON 输
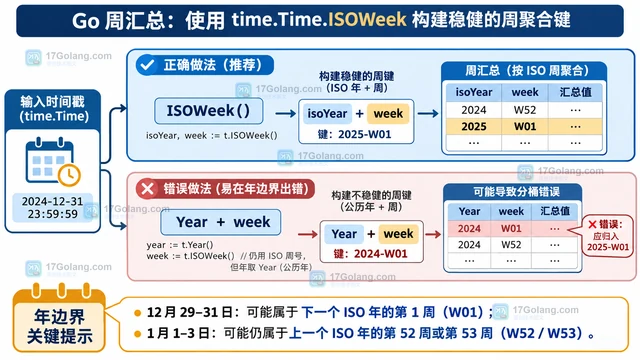
Go Time.ISOWeek 返回的年份为什么与 Year 不同
time.Time.Year 返回公历年,而 ISOWeek 返回 ISO 8601 的周所属年与周号。
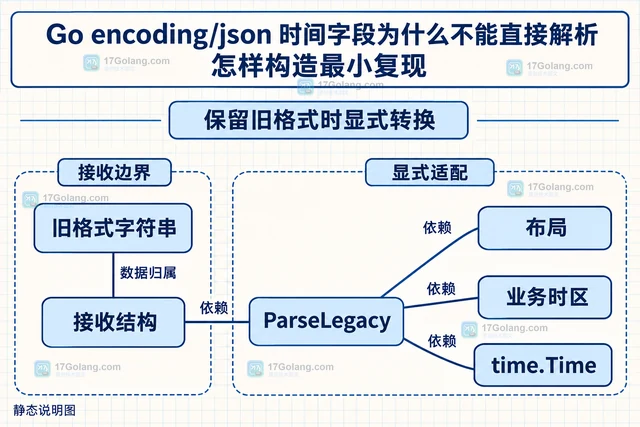
Go encoding/json 时间字段为什么不能直接解析怎样构造最小复现
Go JSON 时间字段解析失败常源于输入表示与 time.Time 的 RFC3339 契约不符。本文
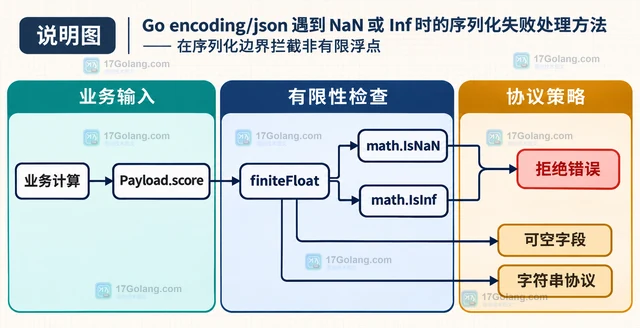
Go encoding/json 遇到 NaN 或 Inf 时的序列化失败处理方法
Go encoding/json 遇到 NaN、+Inf 或 -Inf 时会返回 Unsupported