新的介绍内容:

MLlib (Apache Spark):高效机器学习库,支持多语言和快速迭代计算
使用方便
MLlib是Apache Spark的一部分,支持多种编程语言,包括Java、Scala、Python和R。通过与Spark的API无缝集成,MLlib能够与Python(从Spark 0.9开始)和R库(从Spark 1.5开始)中的NumPy进行互操作。无论您使用的是HDFS、HBase还是本地文件,MLlib都可以轻松插入您的Hadoop工作流中,简化数据处理和分析过程。
表现
MLlib的设计目标之一是高效运行机器学习算法,其性能比传统的MapReduce快100倍。得益于Spark的迭代计算能力,MLlib能够快速执行复杂的机器学习任务。MLlib包含经过优化的高质量算法,这些算法不仅速度快,还能产生比单遍近似更准确的结果,帮助您在数据分析和机器学习任务中取得更好的效果。
无处不在
无论您是在Hadoop、Apache Mesos、Kubernetes上运行Spark,还是在云端针对不同的数据源进行处理,MLlib都能适应您的需求。您可以使用Spark的独立集群模式,在EC2、Hadoop YARN、Mesos或Kubernetes上运行Spark,轻松访问HDFS、Apache Cassandra、Apache HBase、Apache Hive以及数百个其他数据源中的数据,实现灵活高效的数据处理和机器学习应用。
总结
MLlib (Apache Spark) 是一款功能强大、易于使用的机器学习库,适用于多种编程语言和数据源。其高效的算法和快速的迭代计算能力,使其成为数据科学家和工程师的理想选择。无论您是在本地环境还是云端进行数据处理和机器学习,MLlib都能为您提供卓越的性能和灵活性。
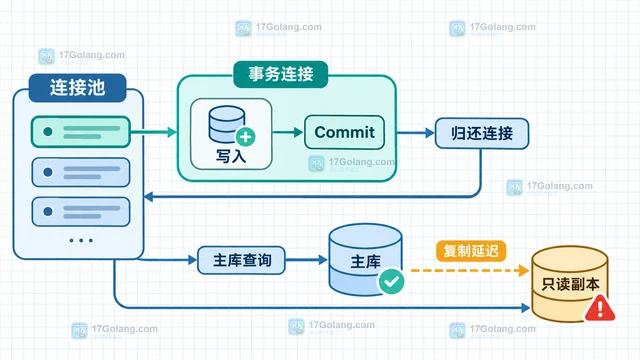
Go database/sql 事务提交后查询为什么看不到数据怎样构造最小复现
Go database/sql 事务提交后查询不到数据,通常不是 database/sql 缓存了旧结果
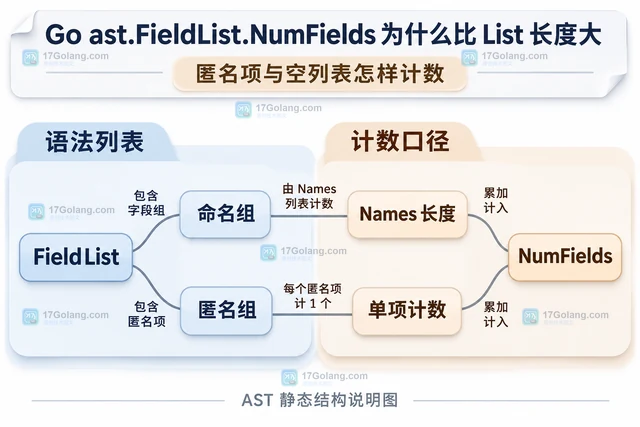
Go ast.FieldList.NumFields 为什么比 List 长度大
Go ast.FieldList.NumFields 统计参数或字段数量,List 长度统计声明组节点。
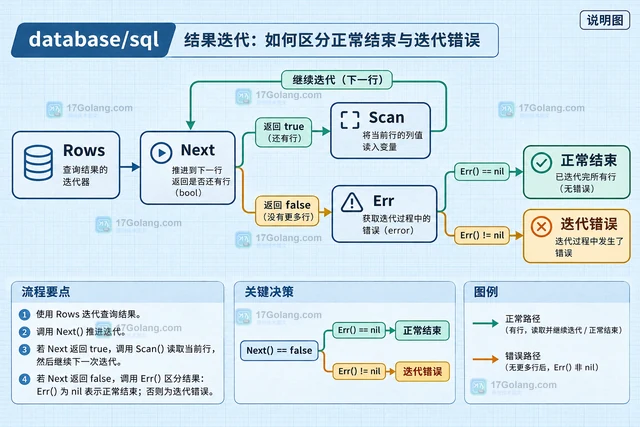
Go database/sql rows.Next 结束后怎样用 rows.Err 捕获迭代错误
Go database/sql 的 rows.Next 返回 false 只表示遍历结束,不能直接当作成
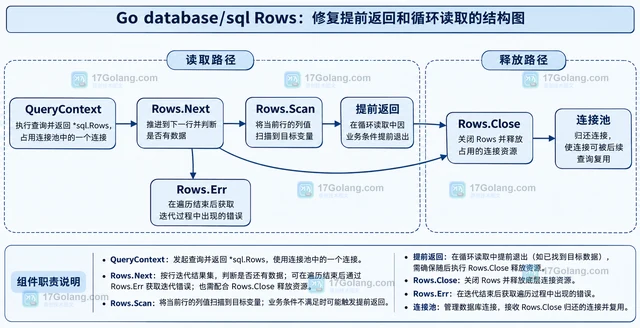
Go database/sql Rows 没有关闭为什么连接耗尽怎样构造最小复现
database/sql 查询提前返回时,如果 Rows 没有关闭,连接可能持续处于使用中。本文用 Ma
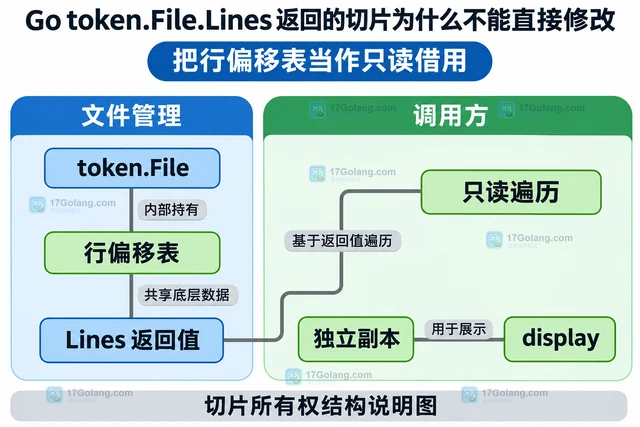
Go token.File.Lines 返回的切片为什么不能直接修改
Go token.File.Lines 的返回切片应按只读数据使用。本文解释切片赋值与独立复制的区别,给
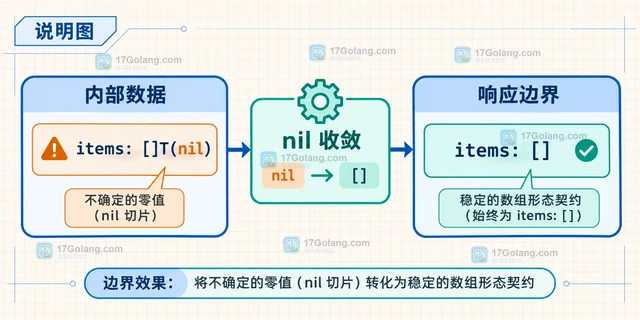
Go encoding/json omitempty 区分 nil 切片和空切片输出的处理方法
解释 Go encoding/json 中 nil 切片、空切片与 omitempty 的 JSON 输