
智能模型利用Transformer技术从庞大数据中学习物理现象,并成功应用于视频生成
有志者,事竟成!如果你在学习科技周边,那么本文《智能模型利用Transformer技术从庞大数据中学习物理现象,并成功应用于视频生成》,就很适合你!文章讲解的知识点主要包括,若是你对本文感兴趣,或者是想搞懂其中某个知识点,就请你继续往下看吧~
建立会做视频的世界模型,也能通过Transformer来实现了!
来自清华和极佳科技的研究人员联手,推出了全新的视频生成通用世界模型——WorldDreamer。
它可以完成多种视频生成任务,包括自然场景和自动驾驶场景,如文生视频、图生视频、视频编辑、动作序列生视频等。
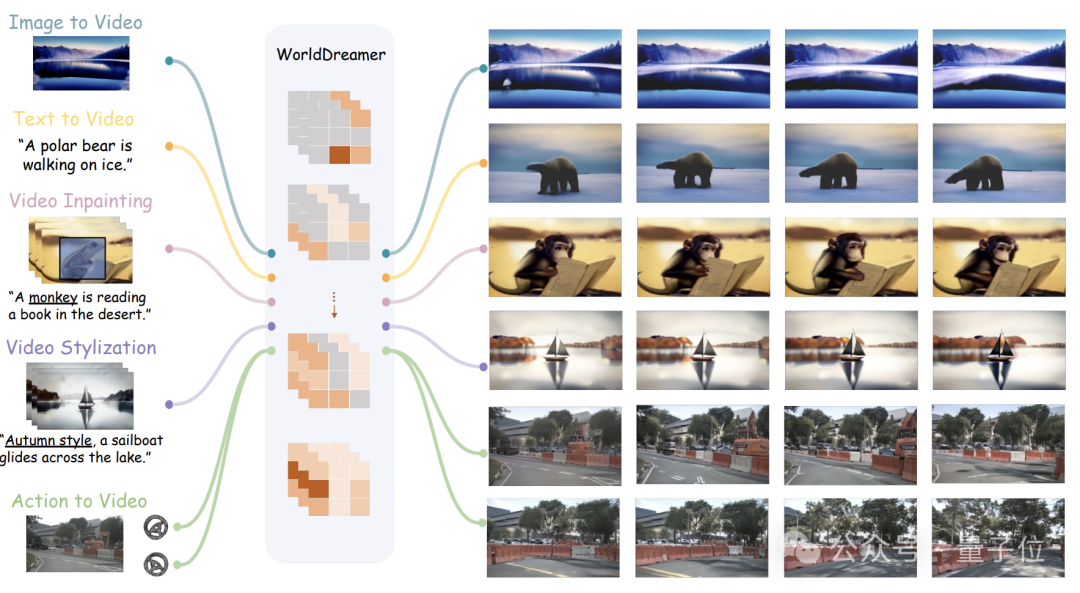
据团队介绍,通过预测Token的方式来建立通用场景世界模型,WorldDreamer是业界首个。
它把视频生成转换为一个序列预测任务,可以对物理世界的变化和运动规律进行充分地学习。
可视化实验已经证明,WorldDreamer已经深刻理解了通用世界的动态变化规律。
那么,它都能完成哪些视频任务,效果如何呢?
支持多种视频任务
图像生成视频(Image to Video)
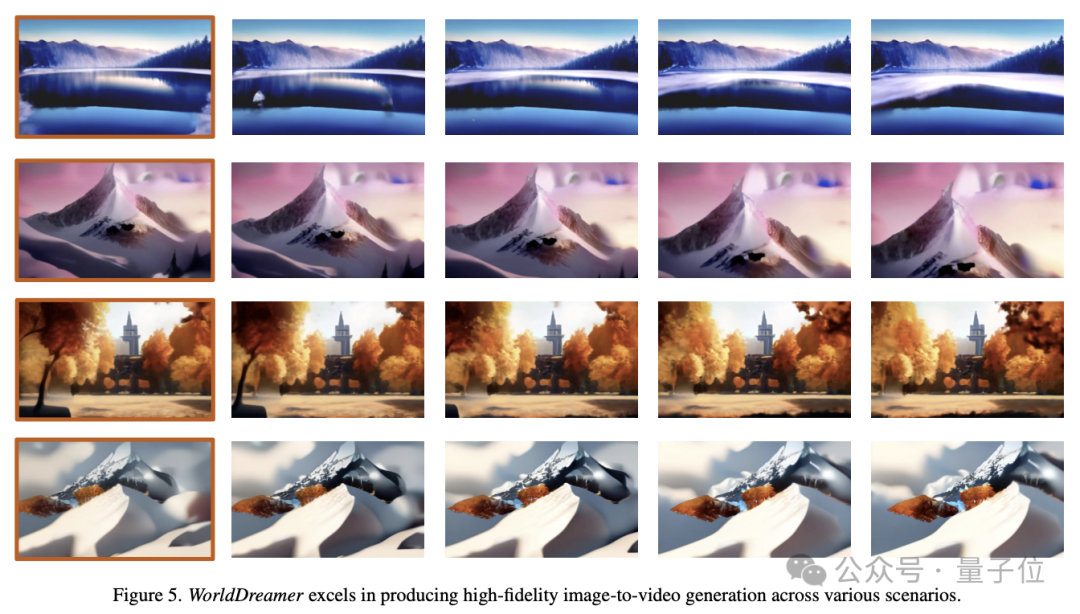
WorldDreamer可以基于单一图像预测未来的帧。
只需首张图像输入,WorldDreamer将剩余的视频帧视为被掩码的视觉Token,并对这部分Token进行预测。
如下图所示,WorldDreamer具有生成高质量电影级别视频的能力。
其生成的视频呈现出无缝的逐帧运动,类似于真实电影中流畅的摄像机运动。
而且,这些视频严格遵循原始图像的约束,确保帧构图的显著一致性。
文本生成视频(Text to Video)
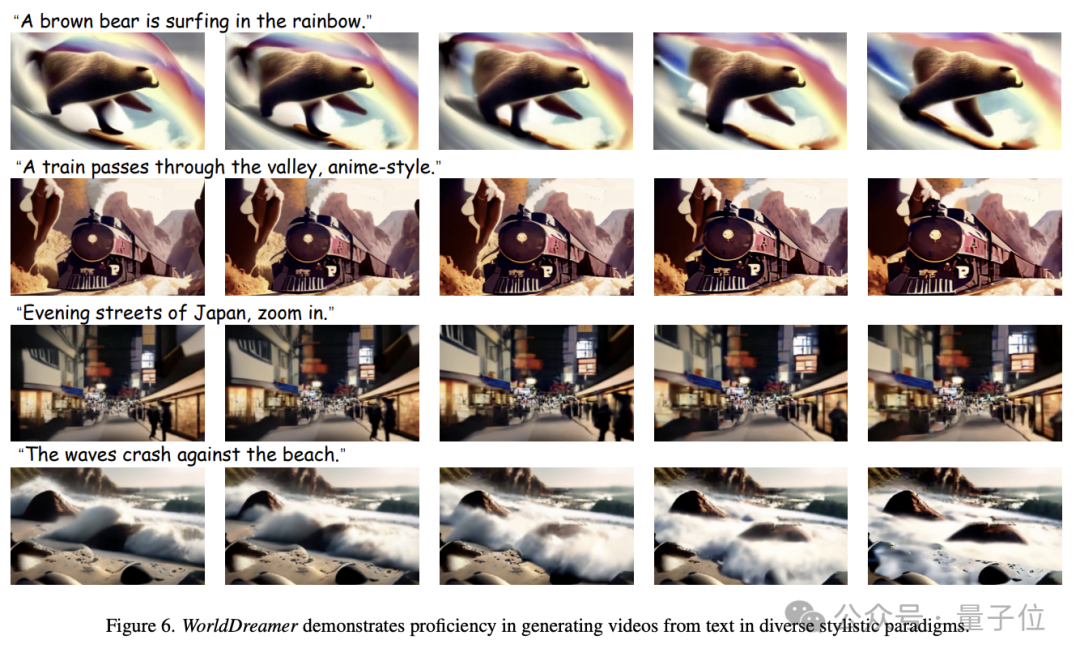
WorldDreamer还可以基于文本进行视频生成。
仅仅给定语言文本输入,此时WorldDreamer认为所有的视频帧都是被掩码的视觉Token,并对这部分Token进行预测。
下图展示了WorldDreamer在各种风格范式下从文本生成视频的能力。
生成的视频与输入语言无缝契合,其中用户输入的语言可以塑造视频内容、风格和相机运动。
视频修改(Video Inpainting)
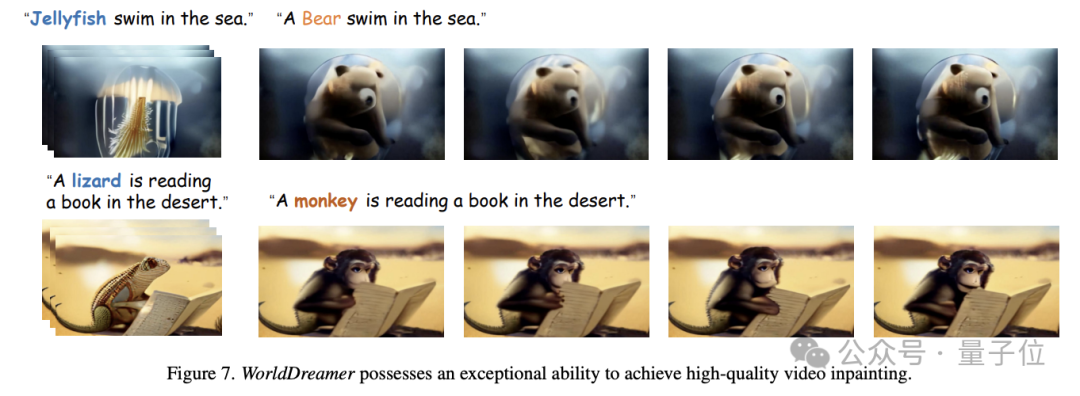
WorldDreamer进一步可以实现视频的inpainting任务。
具体来说,给定一段视频,用户可以指定mask区域,然后根据语言的输入可以更改被mask区域的视频内容。
如下图所示,WorldDreamer可以将水母更换为熊,也可以将蜥蜴更换为猴子,且更换后的视频高度符合用户的语言描述。
视频风格化(Video Stylization)
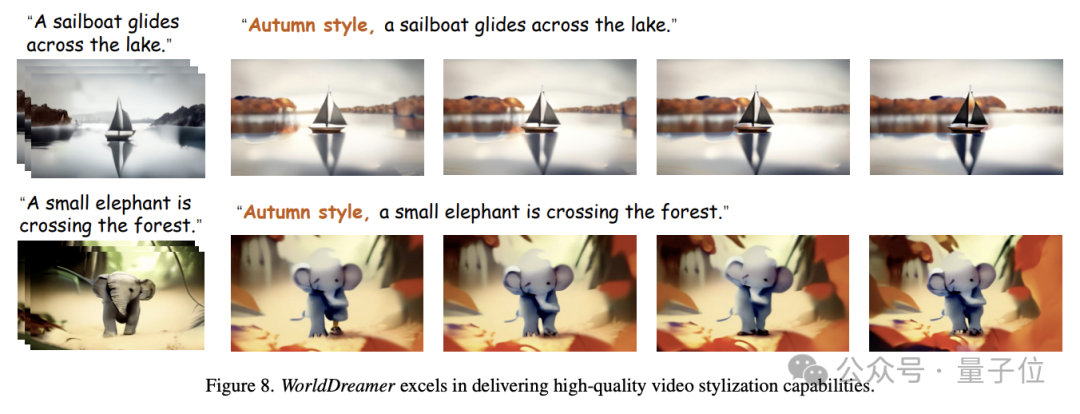
除此以外,WorldDreamer可以实现视频的风格化。
如下图所示,输入一个视频段,其中某些像素被随机掩码,WorldDreamer可以改变视频的风格,例如根据输入语言创建秋季主题效果。
基于动作合成视频(Action to Video)
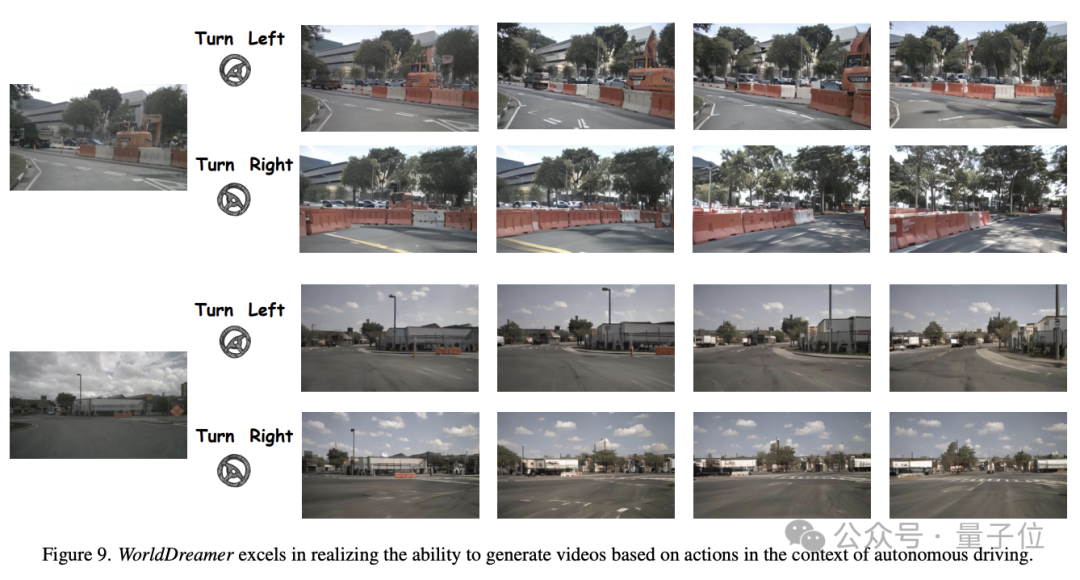
WorldDreamer也可以实现在自动驾驶场景下的驾驶动作到视频的生成。
如下图所示,给定相同的初始帧以及不同的驾驶策略(如左转、右转),WorldDreamer可以生成高度符合首帧约束以及驾驶策略的视频。
那么,WorldDreamer又是怎样实现这些功能的呢?
用Transformer构建世界模型
研究人员认为,目前最先进的视频生成方法主要分为两类——基于Transformer的方法和基于扩散模型的方法。
利用Transformer进行Token预测可以高效学习到视频信号的动态信息,并可以复用大语言模型社区的经验,因此,基于Transformer的方案是学习通用世界模型的一种有效途径。
而基于扩散模型的方法难以在单一模型内整合多种模态,且难以拓展到更大参数,因此很难学习到通用世界的变化和运动规律。
而当前的世界模型研究主要集中在游戏、机器人和自动驾驶领域,缺乏全面捕捉通用世界变化和运动规律的能力。
所以,研究团队提出了WorldDreamer来加强对通用世界的变化和运动规律的学习理解,从而显著增强视频生成的能力。
借鉴大型语言模型的成功经验,WorldDreamer采用Transformer架构,将世界模型建模框架转换为一个无监督的视觉Token预测问题。
具体的模型结构如下图所示:
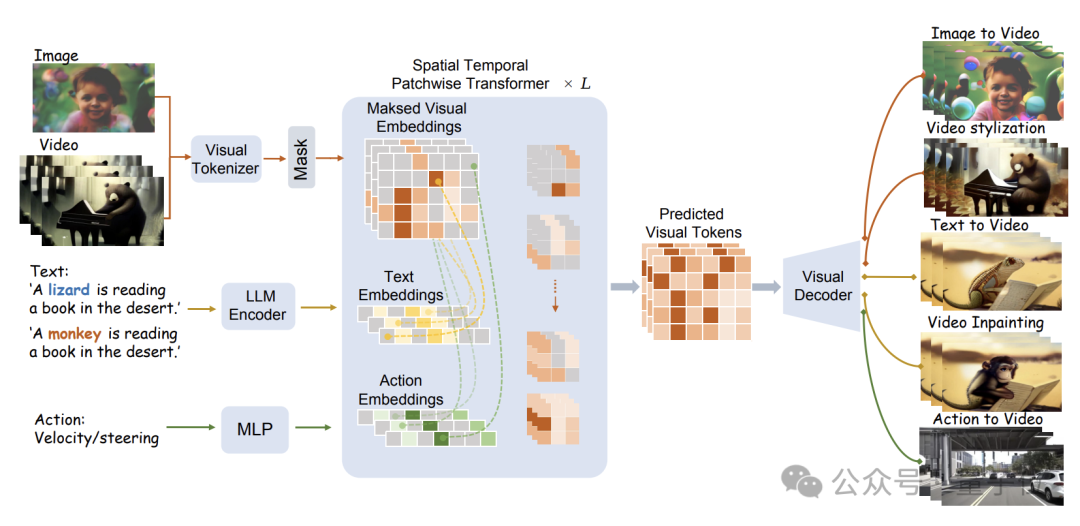
WorldDreamer首先使用视觉Tokenizer将视觉信号(图像和视频)编码为离散的Token。
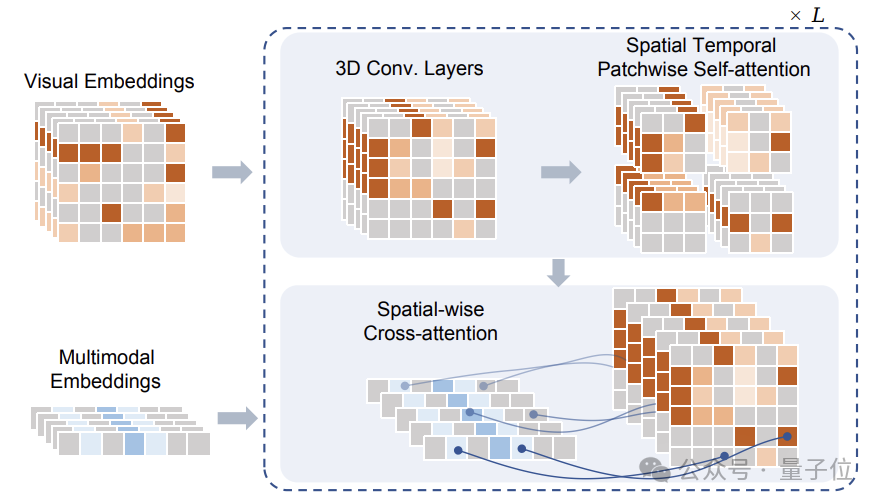
这些Token在经过掩蔽处理后,输入给研究团队提出的Sptial Temporal Patchwuse Transformer(STPT)模块。
同时,文本和动作信号被分别编码为对应的特征向量,以作为多模态特征一并输入给STPT。
STPT在内部对视觉、语言、动作等特征进行充分的交互学习,并可以预测被掩码部分的视觉Token。
最终,这些预测出的视觉Token可以用来完成各种各样的视频生成和视频编辑任务。
值得注意的是,在训练WorldDreamer时,研究团队还构建了Visual-Text-Action(视觉-文本-动作)数据的三元组,训练时的损失函数仅涉及预测被掩蔽的视觉Token,没有额外的监督信号。
而在团队提出的这个数据三元组中,只有视觉信息是必须的,也就是说,即使在没有文本或动作数据的情况下,依然可以进行WorldDreamer的训练。
这种模式不仅降低了数据收集的难度,还使得WorldDreamer可以支持在没有已知或只有单一条件的情况下完成视频生成任务。
研究团队使用大量数据对WorldDreamer进行训练,其中包括20亿经过清洗的图像数据、1000万段通用场景的视频、50万段高质量语言标注的视频、以及近千段自动驾驶场景视频。
团队对10亿级别的可学习参数进行了百万次迭代训练,收敛后的WorldDreamer逐渐理解了物理世界的变化和运动规律,并拥有了各种的视频生成和视频编辑能力。
论文地址:https://arxiv.org/abs/2401.09985
项目主页:https://world-dreamer.github.io/
文中关于AI,视频的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《智能模型利用Transformer技术从庞大数据中学习物理现象,并成功应用于视频生成》文章吧,也可关注golang学习网公众号了解相关技术文章。
 如何将Mac苹果屏幕投射到电视上?
- 上一篇
- 如何将Mac苹果屏幕投射到电视上?
- 下一篇
- 使用零训练数据的VAST、港大和清华实现了3D模型的核心理论重构
-
- 科技周边 · 人工智能 | 41分钟前 | 缓存 · 人工智能 · 提示词工程 · 提示词缓存 cache_control Prompt Caching 静态前缀 cache_read_input_tokens
- 提示词缓存命中率低应如何划分静态前缀
- 453浏览 收藏
-
- 科技周边 · 人工智能 | 3小时前 |
- 模型路由怎样按任务难度分配不同推理预算
- 232浏览 收藏
-
- 科技周边 · 人工智能 | 5小时前 |
- 结构化输出遇到递归字段时怎样约束模式
- 215浏览 收藏
-
- 科技周边 · 人工智能 | 7小时前 | 人工智能 · 工具调用 ·
- 智能体工具调用失败后怎样设计可控重试
- 236浏览 收藏
-
- 科技周边 · 人工智能 | 9小时前 |
- 多模态模型输入图片过大时如何控制视觉令牌
- 196浏览 收藏
-
- 科技周边 · 人工智能 | 11小时前 |
- 推理服务连续批处理怎样减少 GPU 空转
- 404浏览 收藏
-
- 科技周边 · 人工智能 | 15小时前 | 人工智能 · LoRa PEFT merge_and_unload 量化推理 模型合并
- LoRA 合并权重后输出变化过大应检查什么
- 404浏览 收藏
-
- 科技周边 · 人工智能 | 19小时前 |
- RAG 分块重叠过大为什么会降低检索多样性
- 409浏览 收藏
-
- 科技周边 · 人工智能 | 21小时前 | 人工智能 ·
- 合成数据能否替代真实样本:覆盖率与偏差检查方法
- 128浏览 收藏
-
- 科技周边 · 人工智能 | 23小时前 |
- 提示词版本怎么管理:样例、变量与回归集一起提交
- 111浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 393次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 472次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 478次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 421次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 248次使用
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览
-
- Canva手机闪退解决方法及适配指南
- 2026-05-25 501浏览


