
情感词翻译中的逻辑回归、朴素贝叶斯和词向量模型比较
各位小伙伴们,大家好呀!看看今天我又给各位带来了什么文章?本文标题是《情感词翻译中的逻辑回归、朴素贝叶斯和词向量模型比较》,很明显是关于科技周边的文章哈哈哈,其中内容主要会涉及到等等,如果能帮到你,觉得很不错的话,欢迎各位多多点评和分享!

自然语言处理技术的不断发展为处理文本数据提供了更多可能性。借助机器学习和语言模型,我们能够更好地理解和分析文本所蕴含的信息。本文将探讨逻辑回归、朴素贝叶斯和词向量等技术在情感分析、类比推理和词语翻译方面的应用,以揭示语言和情感背后的奥秘。这些技术的运用能够提供更准确的情感判断、更精确的类比推理和更准确的词语翻译,从而帮助我们更好地理解和分析文本数据。
使用逻辑回归进行情感分析,揭示情感背景
情感分析是一种利用自然语言处理技术来识别和理解文本中情感色彩的方法。逻辑回归是一种常用的分类算法,可用于情感分析,帮助我们理解文本背后的情感倾向。在情感分析中,逻辑回归通过训练模型能够识别文本中的情感,如积极、消极或中性。透过逻辑回归模型,我们能够揭示文本背后的情感背景,从而更好地理解人们在文本中表达的情绪和态度。这种方法有助于我们从海量文本数据中提取情感信息,进而为企业、品牌和产品的改进提供有价值的意见和建议。
以下是基于Python的简单示例:
# 导入必要的库import pandas as pdfrom sklearn.model_selection import train_test_splitfrom sklearn.feature_extraction.text import CountVectorizerfrom sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import accuracy_score# 示例数据data = {'text': ["这部电影太精彩了!", "这个产品很失望。", "今天天气不错。", "我对这个服务感到满意。"], 'sentiment': [1, 0, 1, 1]}df = pd.DataFrame(data)# 将文本转换为特征向量vectorizer = CountVectorizer()X = vectorizer.fit_transform(df['text'])# 划分训练集和测试集X_train, X_test, y_train, y_test = train_test_split(X, df['sentiment'], test_size=0.2, random_state=42)# 构建并训练逻辑回归模型lr = LogisticRegression()lr.fit(X_train, y_train)# 情感分析预测y_pred = lr.predict(X_test)print("情感分析准确率:", accuracy_score(y_test, y_pred))使用朴素贝叶斯完成类比,解码语言关系
朴素贝叶斯是一种基于贝叶斯定理的分类算法,它在自然语言处理中常被用于文本分类和类比推理。通过朴素贝叶斯算法,我们可以建立模型来理解语言中的类比关系,例如"man"对应于"king",就如同"woman"对应于"queen"一样。这种类比关系的理解对于语言翻译和语义推理具有重要意义,朴素贝叶斯算法可以帮助我们解码并理解语言中的隐含关系,从而更好地处理类比和推理任务。
以下是基于Python的简单示例:
# 导入必要的库from sklearn.naive_bayes import MultinomialNB# 示例数据word_pairs = {"man": "king", "woman": "queen", "Paris": "France", "Rome": "Italy"}X = list(word_pairs.keys())y = list(word_pairs.values())# 构建并训练朴素贝叶斯模型nb = MultinomialNB()nb.fit(X, y)# 类比推理new_word = "queen"predicted_word = nb.predict([new_word```python# 寎入必要的库import numpy as npfrom gensim.models import Word2Vec# 示例数据sentences = [["I", "love", "playing", "football"], ["He", "enjoys", "playing", "basketball"], ["She", "likes", "playing", "soccer"], ["I", "enjoy", "playing", "tennis"]]# 构建词向量模型model = Word2Vec(sentences, min_count=1)# 获取词向量word_vector = model.wv['playing']print("词语'playing'的词向量:", word_vector)# 计算词语相似度similarity = model.wv.similarity('football', 'basketball')print("词语'football'和'basketball'的相似度:", similarity)使用词向量进行词翻译,弥合语言鸿沟
词向量是一种将词语映射到向量空间中的技术,通过词向量,我们可以将词语表示为具有语义信息的实数向量。在跨语言翻译中,词向量可以帮助我们理解不同语言中词语的含义和关联,从而实现词翻译的任务。通过将不同语言的词语映射到共同的向量空间中,词向量可以帮助我们弥合不同语言之间的鸿沟,实现更准确和连贯的跨语言翻译。词向量的应用为跨语言交流提供了新的可能性,帮助人们更好地理解和沟通不同语言和文化之间的差异。
以下是基于Python的简单示例:
import numpy as npfrom gensim.models import KeyedVectors# 加载预训练的词向量模型wv = KeyedVectors.load_word2vec_format('path_to_pretrained_model.bin', binary=True)# 示例:词语翻译english_word = "hello"translated_word = wv.most_similar(positive=[english_word], topn=1)print("英文单词'hello'的翻译:", translated_word[0][0])通过逻辑回归、朴素贝叶斯和词向量的应用,我们能更深入地理解文本背后的情感、语言关系和词语含义。这些技术的不断发展将提供更多解决语言处理难题的可能性,进一步弥合语言和文化之间的差异,推动跨语言交流和理解的进程。希望本文对语言处理技术的探索能够为您带来启发。
今天关于《情感词翻译中的逻辑回归、朴素贝叶斯和词向量模型比较》的内容介绍就到此结束,如果有什么疑问或者建议,可以在golang学习网公众号下多多回复交流;文中若有不正之处,也希望回复留言以告知!
 人体关键点检测:数据集和应用
- 上一篇
- 人体关键点检测:数据集和应用

- 下一篇
- 无法将文件移动到mac机中?
-
- 科技周边 · 人工智能 | 1天前 |
- Tokenizer padding_side 影响批量生成的对齐
- 206浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | python · 人工智能 · 数据迭代 Hugging Face Datasets streaming IterableDataset 大语料
- Datasets streaming 读取大语料的迭代方式
- 337浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | python · Transformers generate 停止条件 批量输出
- Transformers generate 的停止条件与批量输出
- 133浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | 人工智能 · LoRa 显存优化 bitsandbytes QLoRA 4-bit量化
- bitsandbytes 量化模型配合 LoRA 训练的显存边界
- 249浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | 人工智能 · LoRa PEFT load_adapter set_adapter 适配器切换
- PEFT LoRA 适配器按任务切换的加载方案
- 268浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | 人工智能 · LoRa PEFT merge_and_unload 适配器合并
- PEFT 适配器合并后为什么输出会变化
- 221浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- Tokenizer 左填充和右填充应该怎么选
- 399浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 |
- Safetensors 为什么支持按需读取权重切片
- 258浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 |
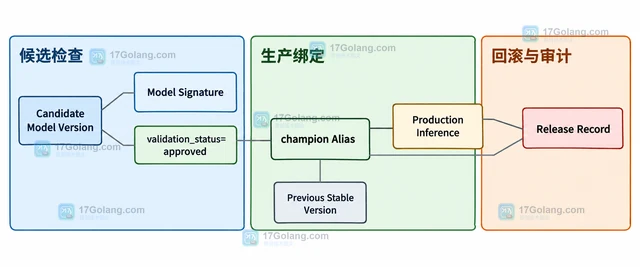
- MLflow Model Alias 怎么替代固定版本号部署
- 360浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 | 索引优化 · 向量数据库 · 向量检索 FAISS Index Factory IVF PQ
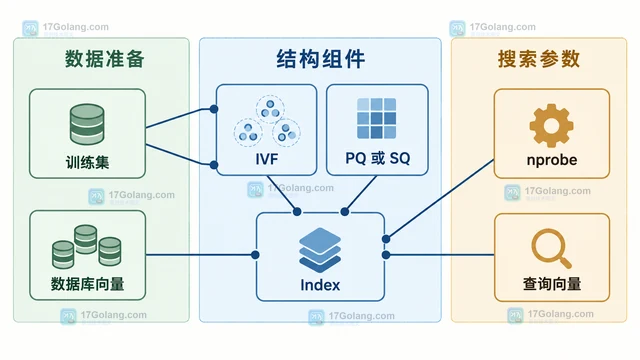
- FAISS Index Factory 字符串怎么组合索引结构
- 100浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 |
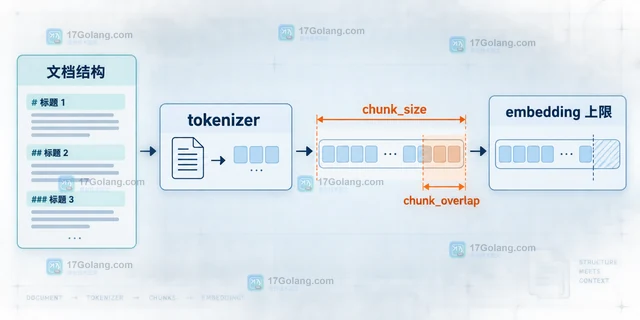
- 知识库切片重叠率怎么影响检索结果
- 268浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 264次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 318次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 302次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 273次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 94次使用
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览
-
- Canva手机闪退解决方法及适配指南
- 2026-05-25 501浏览