
有哪些方法适用于处理超小数据集的文本分类问题?
golang学习网今天将给大家带来《有哪些方法适用于处理超小数据集的文本分类问题?》,感兴趣的朋友请继续看下去吧!以下内容将会涉及到等等知识点,如果你是正在学习科技周边或者已经是大佬级别了,都非常欢迎也希望大家都能给我建议评论哈~希望能帮助到大家!
适用于超小数据集的文本分类方法主要包括传统机器学习方法和深度学习方法。在小数据集上,传统机器学习方法往往表现更佳,因为它们对于有限的数据也能产生较好的模型。相比之下,深度学习方法需要更多的数据来训练,才能达到良好的效果。下面将简要介绍传统机器学习方法和深度学习方法。
一、传统机器学习方法
在传统机器学习方法中,常用的文本分类算法包括朴素贝叶斯、支持向量机(SVM)、决策树等。这些算法都是基于特征工程的方法,即将文本转换成特征向量,然后使用机器学习算法进行分类。其中,朴素贝叶斯算法是一种基于贝叶斯定理的分类算法,它假设所有特征都是相互独立的,因此可以通过计算每个特征对分类的贡献来进行分类。SVM算法是一种分类和回归的方法,它通过将数据映射到高维空间中来寻找一个最优的超平面,从而将不同的类别分开。决策树算法则是一种基于树结构的分类算法,它通过不断划分数据集来建立一个树形模型,从而实现分类。
传统机器学习方法具有处理小数据集和较低计算资源要求的优势。此外,它们在特征工程方面拥有相对成熟的技术,通过选择适当的特征可以提高模型性能。然而,这些方法也存在一些缺点。首先,特征工程需要大量的人工参与,并且特征选择可能会对模型性能产生影响。其次,这些算法通常无法很好地处理文本中的语义信息,因为它们只能处理数字或离散特征,无法处理自然语言。最后,当处理复杂数据集时,这些方法可能会面临欠拟合或过拟合的问题。因此,针对这些问题,需要考虑使用深度学习等方法来克服传统机器学习方法的局限性。深度学习方法可以自动提取特征,并且能够处理文本中的语义信息,同时具有更强大的模型拟合能力。然而,深度学习方法也需要更多的数据和计算资源,以及更复杂的模型调优过程。因此,在选择机器学习方法时,需要根据具体任务的特点和可用资源来进行权衡。
举例来说,如果我们想要对一组新闻进行分类,我们可以使用传统机器学习方法中的朴素贝叶斯算法。我们可以将每篇新闻转换成特征向量,并将其与预先定义的标签进行匹配。例如,我们可以将新闻的标题、正文、发布时间等信息转换成特征向量,然后使用朴素贝叶斯算法来进行分类。这种方法可以快速地对新闻进行分类,并且不需要太多的数据。但是,这种方法可能会受到特征选择的影响,如果选择的特征不够准确,可能会影响分类的准确性。
二、深度学习方法
在深度学习方法中,常用的文本分类算法包括卷积神经网络(CNN)、循环神经网络(RNN)和长短期记忆网络(LSTM)等。这些算法都是基于神经网络的方法,可以自动地学习输入数据中的特征,并进行分类。其中,CNN算法是一种常用的图像处理算法,但也可以用于文本分类。它通过卷积操作和池化操作来提取输入数据中的特征,并使用全连接层来进行分类。RNN算法则是一种能够处理序列数据的算法,它可以通过记忆过去的状态来预测未来的状态,因此适合处理文本数据。LSTM算法是一种RNN的变种,它通过门控机制来控制信息的流动,从而解决了RNN中梯度消失和梯度爆炸的问题。
深度学习方法的优势在于它们能够自动地学习输入数据中的特征,并且可以处理复杂的语义信息。此外,深度学习方法可以通过预训练模型来加速训练过程,并且可以使用迁移学习技术来解决小数据集的问题。然而,深度学习方法也存在一些缺点。首先,深度学习方法需要大量的数据和计算资源才能够训练出好的模型。其次,深度学习方法的黑盒性较强,很难解释模型的决策过程。最后,在小数据集上,深度学习方法的表现常常不如传统机器学习方法。
举例来说,如果我们想要对一组电影评论进行情感分类,我们可以使用深度学习方法中的LSTM算法。我们可以将每条评论转换成词向量,并将其输入到LSTM模型中进行分类。例如,我们可以使用已经预训练好的词向量模型,将每个单词转换成词向量,并将所有词向量组成的序列输入到LSTM模型中。这种方法可以自动地学习输入数据中的特征,并且可以处理复杂的语义信息。但是,由于电影评论数据集通常比较小,因此我们可能需要使用迁移学习技术来提高模型的性能。
综上所述,传统机器学习方法和深度学习方法都有各自的优势和缺点,在超小数据集的情况下,传统机器学习方法更适合处理。在选择适合的方法时,需要根据具体的数据集和任务来进行选择。如果数据集较小,可以选择传统机器学习方法,并合适的特征工程;如果数据集较大,可以选择深度学习方法,并使用预训练模型和迁移学习技术来提高模型的性能。同时,在选择方法时,还需要考虑模型的可解释性、计算资源进行和时间成本等因素。
以上就是本文的全部内容了,是否有顺利帮助你解决问题?若是能给你带来学习上的帮助,请大家多多支持golang学习网!更多关于科技周边的相关知识,也可关注golang学习网公众号。
 使用东芝硬盘在Mac上的方法
- 上一篇
- 使用东芝硬盘在Mac上的方法
- 下一篇
- 深入解析线性判别分析LDA
-
- 科技周边 · 人工智能 | 1小时前 |
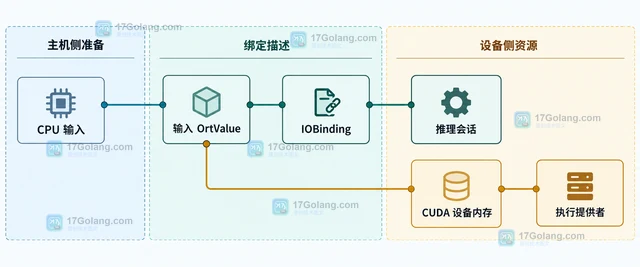
- ONNX Runtime IOBinding 怎样预绑定推理输入输出内存
- 352浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- Sentence Transformers semantic_search 怎样控制语义检索的分块大小
- 491浏览 收藏
-
- 科技周边 · 人工智能 | 2小时前 |
- Tokenizers normalizers.Sequence 怎样组合规范化规则
- 110浏览 收藏
-
- 科技周边 · 人工智能 | 2小时前 |
- Tokenizers pre_tokenizers.Metaspace 怎样表示分词前的空格
- 208浏览 收藏
-
- 科技周边 · 人工智能 | 2小时前 |
- Hugging Face Datasets ClassLabel 怎样固定分类标签映射
- 447浏览 收藏
-
- 科技周边 · 人工智能 | 2小时前 |
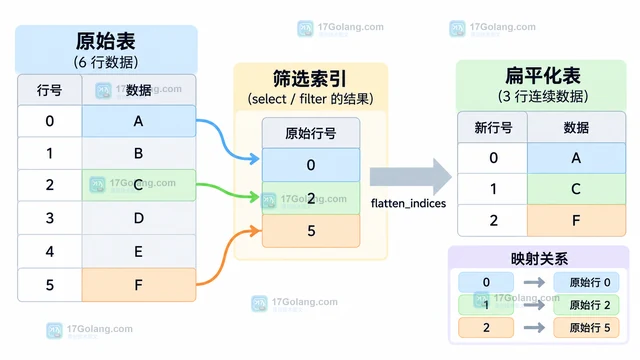
- Hugging Face Datasets flatten_indices 怎样整理筛选后的索引映射
- 344浏览 收藏
-
- 科技周边 · 人工智能 | 2小时前 |
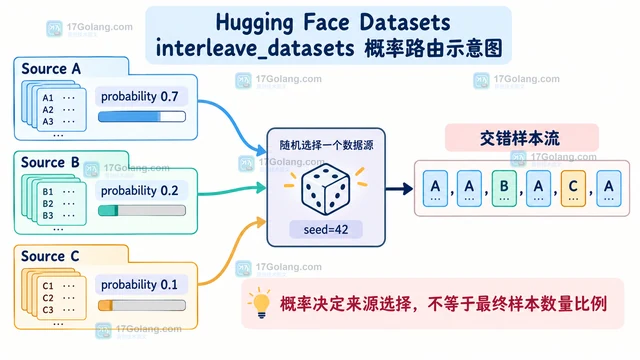
- Hugging Face Datasets interleave_datasets 怎样按概率交错混合语料
- 285浏览 收藏
-
- 科技周边 · 人工智能 | 9小时前 | 人工智能 · 工具调用 · 自定义函数 OpenAI Responses API Function Calling function_call_output strict function_call
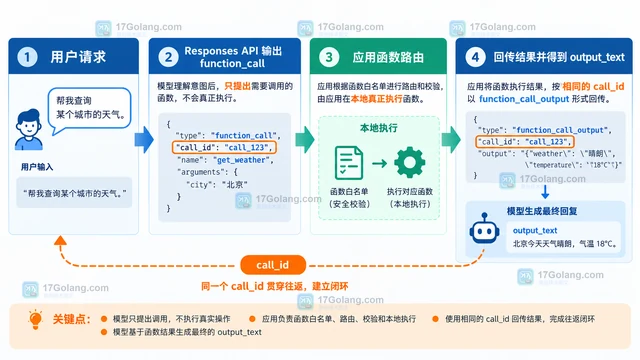
- OpenAI Responses API 怎样让模型调用自定义函数
- 223浏览 收藏
-
- 科技周边 · 人工智能 | 14小时前 |
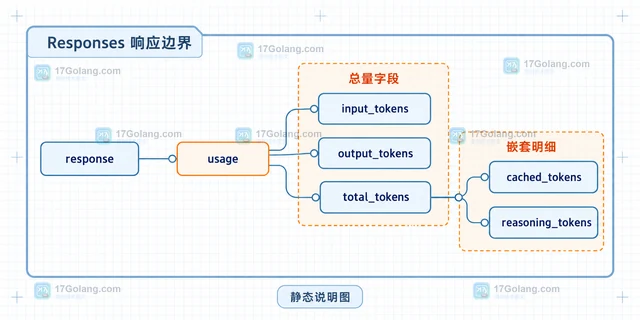
- OpenAI API 怎样读取模型返回的使用量字段
- 234浏览 收藏
-
- 科技周边 · 人工智能 | 14小时前 | 人工智能 · OpenAI Batch API batch status 批处理任务 API状态查询
- OpenAI Batch API 怎样查询批处理任务状态
- 292浏览 收藏
-
- 科技周边 · 人工智能 | 14小时前 | Parquet Hugging Face Datasets shard to_parquet push_to_hub
- Hugging Face Datasets 导出 Parquet 时怎么控制分片大小
- 378浏览 收藏
-
- 科技周边 · 人工智能 | 14小时前 | PyTorch DataLoader IterableDataset get_worker_info
- PyTorch IterableDataset 怎样为每个 worker 分配不同数据片段
- 455浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 731次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 734次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 813次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 772次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 610次使用
-
- 量化模型本地推理的显存估算方法
- 2026-10-17 501浏览
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览


