
如何使用Docker进行应用的监控和日志管理
知识点掌握了,还需要不断练习才能熟练运用。下面golang学习网给大家带来一个文章开发实战,手把手教大家学习《如何使用Docker进行应用的监控和日志管理》,在实现功能的过程中也带大家重新温习相关知识点,温故而知新,回头看看说不定又有不一样的感悟!
Docker已经成为了现代化应用中的一项必备技术,但是使用Docker进行应用监控和日志管理却是一项挑战。随着Docker网络功能,如Service Discovery和Load Balancing的不断增强,我们越来越需要一个完整、稳定,以及高效的应用监控系统。
在本文中,我们将简单地介绍使用Docker进行应用监控和日志管理的同时给出具体的代码示例。
利用Prometheus进行应用监控
Prometheus是一款开源,基于Pull模型的服务监测和警告工具,由SoundCloud开发。它使用Go语言编写,被广泛应用于微服务方案和云环境中。作为一款监控工具,它可以对Docker的CPU、内存、网络和磁盘等进行监控,并且还支持多维数据切换、灵活的查询、报警以及可视化等功能,让你可以快速做出反应,并快速做出决策。
还有一点需要注意的是,Prometheus需要通过Pull方式的采样,也就是访问被监控应用中的/metrics接口获取监控数据。所以,在启动被监控应用镜像时,需要先将可以访问到Prometheus的IP和端口配置到/metrics接口中。下面是一个简单的Node.js应用。
const express = require('express')
const app = express()

app.get('/', (req, res) => {
  res.send('Hello World!')
})

app.get('/metrics', (req, res) => {
  res.send(`
    # HELP api_calls_total Total API calls
    # TYPE api_calls_total counter
    api_calls_total 100
  `)
})

app.listen(3000, () => {
  console.log('Example app listening on port 3000!')
})
在该代码中,我们通过/metrics接口,返回了一个api_calls_total的监控指标。
接着,在官网上下载Prometheus的Docker镜像,并创建一个docker-compose.yml文件,并且在该文件中,我们获取该Node.js应用的数据。
version: '3'
services:
  node:
    image: node:lts
    command: node index.js
    ports:
      - 3000:3000

  prometheus:
    image: prom/prometheus:v2.25.2
    volumes:
      - ./prometheus:/etc/prometheus
    command:
      - '--config.file=/etc/prometheus/prometheus.yml'
      - '--storage.tsdb.retention.time=15d'
    ports:
      - 9090:9090
该docker-compose.yml文件中,我们定义了两个服务,一个是运行Node.js应用的Node服务,另一个是用于监控的Prometheus服务。其中,Node服务发布的端口为3000端口,通过端口映射,可以通过docker-compose.yml中的IP和3000端口访问到该Node应用的/metrics接口。而Prometheus则可以通过9090端口访问对应的监控指标数据。
最后,在prometheus.yml文件中,我们需要定义要获取的数据来源。
global:
  scrape_interval:     15s
  evaluation_interval: 15s

scrape_configs:
  - job_name: 'node-exporter'
    static_configs:
    - targets: ['node:9100']

  - job_name: 'node-js-app'
    static_configs:
    - targets: ['node:3000']
在该文件中,我们定义了要采集的所有的Node.js应用的指标,其中targets参数是Node.js应用的IP地址及其对应端口号。在这里,我们使用的是node和3000端口。
最后,运行docker-compose up命令,即可启动整个应用及其监控服务,并在Prometheus中查看该会员指标。
利用ElasticSearch和Logstash进行日志管理
在Docker中,应用的日志数据分布在不同的Docker容器中。如果你要在集中的地方对这些日志进行管理,那么可以通过使用ELK中的ElasticSearch和Logstash,将日志中心化管理,以便更轻松地实现计算机资源的监控和分析。
在开始之前,需要先下载Logstash和ElasticSearch的Docker镜像,并创建一个docker-compose.yml文件。
在该文件中,我们定义了三个服务,其中bls是用来模拟业务日志的API服务,其每次响应后,将记录一条日志到stdout和日志文件中。logstash服务是由Logstash官方提供的Docker镜像构建,用于收集、过滤和传输日志。ElasticSearch服务用于存储和检索日志。
version: '3'
services:
  bls:
    image: nginx:alpine
    volumes:
      - ./log:/var/log/nginx
      - ./public:/usr/share/nginx/html:ro
    ports:
      - "8000:80"
    logging:
      driver: "json-file"
      options:
        max-size: "10m"
        max-file: "10"

  logstash:
    image: logstash:7.10.1
    volumes:
      - ./logstash/pipeline:/usr/share/logstash/pipeline
    environment:
      - "ES_HOST=elasticsearch"
    depends_on:
      - elasticsearch

  elasticsearch:
    image: elasticsearch:7.10.1
    environment:
      - "http.host=0.0.0.0"
      - "discovery.type=single-node"
    volumes:
      - ./elasticsearch:/usr/share/elasticsearch/data
在配置文件中,我们映射了容器内的路径到宿主机的日志文件系统中。同时通过logging的option,则定义了日志的卷大小和数量,以限制日志的占用存储。
在配置文件的logstash中,我们定义了一个新的pipeline,其名为nginx_pipeline.conf,该文件用于处理nginx日志的收集、过滤和传输。与ELK的工作原理相同,logstash将根据不同的条件,对接收到的日志进行处理,并将其发送到已经创建的 Elasticsearch 集群中。在该配置文件中,我们定义了如下处理逻辑:
input {
  file {
    path => "/var/log/nginx/access.log"
  }
}

filter {
  grok {
    match => { "message" => "%{COMBINEDAPACHELOG}" }
  }
}

output {
  elasticsearch {
    hosts => [ "${ES_HOST}:9200" ]
    index => "nginx_log_index"
  }
}
在该配置文件中,我们定义了一个name为file的输入,表示要从本地Log文件中读取数据。接着,我们引入了使用grok库来解析符合特定模板的日志的filter。最后,我们定义了输出,其将数据传输到 Elasticsearch 集群的地址,同时将检索和报告通过环境变量ES_HOST传递到容器中。
在最后,如上完成整个ELK的配置后,我们会得到一个高效的日志管理系统,每条日志都将发送到集中的地方,并被整合在一起,可以实现简便的搜索,过滤和可视化操作。
以上就是本文的全部内容了,是否有顺利帮助你解决问题?若是能给你带来学习上的帮助,请大家多多支持golang学习网!更多关于文章的相关知识,也可关注golang学习网公众号。
 PHP开发中如何使用Memcache进行分布式缓存?
- 上一篇
- PHP开发中如何使用Memcache进行分布式缓存?
- 下一篇
- Redis在社交网络中的应用探索
-
- 文章 · linux | 1天前 | Linux · 运维 · 日志排查 · journalctl 启动日志 Boot ID --list-boots systemd日志导出
- journalctl 按启动会话筛选并导出日志
- 369浏览 收藏
-
- 文章 · linux | 1天前 | Linux · Linux防火墙 nftables verdict map 多端口策略
- nftables verdict map 组织多端口策略的规则设计
- 475浏览 收藏
-
- 文章 · linux | 1天前 | 权限控制 · 服务管理 · systemd socket激活 systemd.socket ListenStream Accept
- systemd socket 激活服务的依赖与监听配置
- 229浏览 收藏
-
- 文章 · linux | 2天前 |
- Linux ip rule 怎么按来源地址选择路由表
- 347浏览 收藏
-
- 文章 · linux | 2天前 | Linux · 文件系统 · Linux mount bind mount remount
- Linux bind mount 怎么二次挂载为只读
- 116浏览 收藏
-
- 文章 · linux | 2天前 |
- systemd-sysusers 怎么声明软件包所需系统账号
- 150浏览 收藏
-
- 文章 · linux | 2天前 |
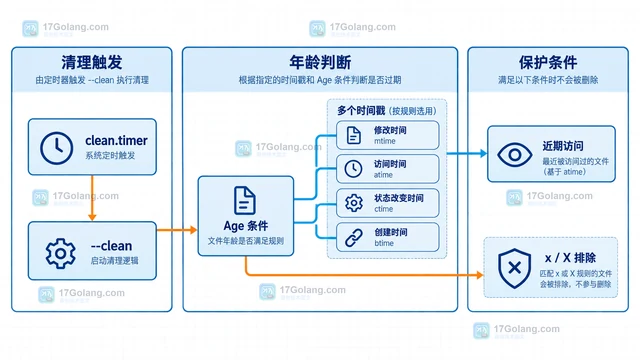
- systemd-tmpfiles 怎么按文件年龄自动清理目录
- 464浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 271次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 324次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 313次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 288次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 104次使用
-
- Linux vmstat 如何分辨内存抖动与磁盘等待:si、so、wa 与复测顺序
- 2026-08-30 501浏览
-
- Linux搭建vsftpdFTP服务器教程
- 2026-04-30 501浏览
-
- Shell脚本安装教程:.sh一键安装指南
- 2026-03-16 501浏览
-
- Linux清空文件内容的几种方法
- 2025-12-01 501浏览
-
- Linux命令行下载文件技巧
- 2025-11-23 501浏览