
LLM 结构化输出失败后怎样做有限修复
我在做 LLM 信息抽取时,最容易误判的一件事是:模型“看起来像 JSON”,并不等于结果已经可以交给业务代码。真正需要守住的是三层边界:文本能否解析成 JSON、JSON 是否符合 Schema、字段值是否满足业务规则。把三层混成一次无限重试,通常只会让延迟和费用一起上涨。
更稳妥的做法是把修复当成一个有预算的函数:每次只携带原始结果和明确错误,最多修复一到两次;仍然失败就返回降级对象、进入人工队列或记录原始文本。本文用一个不绑定模型厂商的小项目,把这条边界实现出来。
官方参考地址:https://huggingface.co/docs/inference-providers/en/guides/structured-output
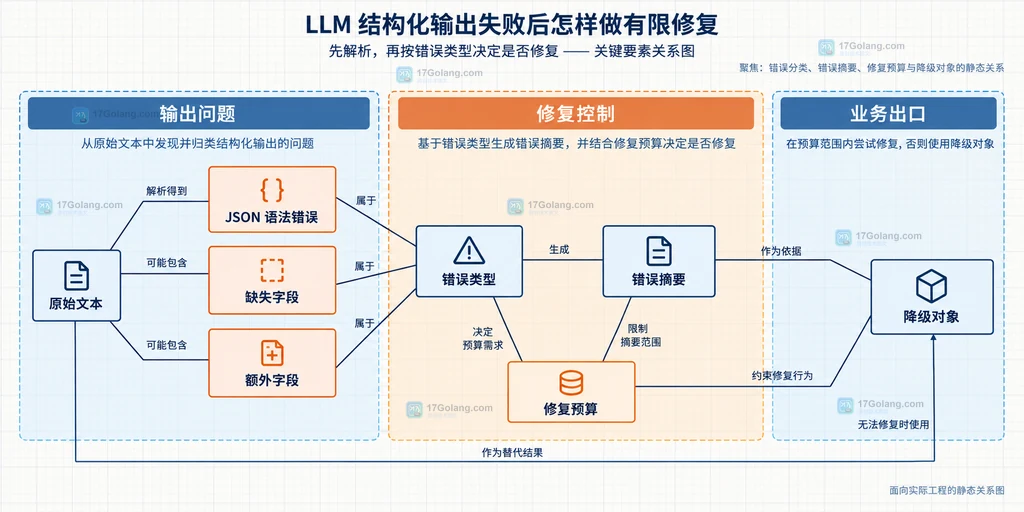
先把“输出失败”拆成三个问题
结构化输出失败并不是一个单一错误。第一类是语法错误,例如模型在 JSON 末尾多了一段解释文字;第二类是结构错误,例如缺少 answer 或把 confidence 生成为字符串;第三类是业务错误,例如字段类型正确,但答案为空或置信度超出 0 到 1。
JSON Schema 的 properties 描述字段,required 约束必须出现的字段,additionalProperties 控制未声明字段。需要注意的是,Schema 能约束结构,不会自动判断内容是否符合你的业务语义,所以最后一层业务规则仍要单独写。
我会把处理函数设计成只返回四种状态:ok、repairable、exhausted 和 unrecoverable。调用方不必猜测“这次是不是应该再试一次”,也不会因为异常捕获位置不同而出现隐藏重试。
定义一个小而闭合的 JSON Schema
示例任务是从一段文本中提取答案、置信度和证据片段。字段数量刻意保持少,便于观察失败原因;生产项目可以继续增加字段,但不要一开始就把整个领域模型塞进模型输出。
{
  "type": "object",
  "properties": {
    "answer": {"type": "string", "minLength": 1},
    "confidence": {"type": "number", "minimum": 0, "maximum": 1},
    "evidence": {
      "type": "array",
      "items": {"type": "string"},
      "maxItems": 3
    }
  },
  "required": ["answer", "confidence", "evidence"],
  "additionalProperties": false
}
这里的 additionalProperties: false 是一个明确取舍:它能尽早暴露模型偷偷增加字段的问题,但也意味着后续扩展时必须同步修改 Schema。若接口需要兼容旧字段,应该在版本化 Schema 中处理,不要靠修复提示词“猜”出字段。
先解析,再按错误类型决定是否修复
修复策略不能只看“模型返回了什么”,还要看错误属于哪一层。JSON 解析失败时,修复请求可以要求模型只返回合法 JSON;Schema 校验失败时,应把缺失字段、错误类型或多余字段压缩成短错误摘要;业务规则失败时,则要回到业务处理,不应假装 Schema 修复已经解决问题。
错误摘要要短而稳定,避免把整段异常堆回提示词。下面的实现只保留路径、校验关键字和简短消息,且对修复次数设置硬上限。
import json
from dataclasses import dataclass
from typing import Any, Callable

from jsonschema import Draft202012Validator


@dataclass
class RepairResult:
    status: str
    data: dict[str, Any] | None
    raw: str
    errors: list[str]
    attempts: int


def summarize_errors(validator: Draft202012Validator, data: Any) -> list[str]:
    # 只把路径和关键字交给下一次修复,避免把完整堆栈变成提示词噪声。
    items = []
    for error in validator.iter_errors(data):
        path = ".".join(str(part) for part in error.absolute_path) or "$"
        items.append(f"{path}: {error.validator} - {error.message}")
    return items[:6]


def parse_and_validate(raw: str, schema: dict[str, Any]) -> tuple[dict[str, Any] | None, list[str]]:
    # 解析异常与 Schema 异常分开返回,调用方才能选择不同的修复提示。
    try:
        data = json.loads(raw)
    except json.JSONDecodeError as exc:
        return None, [f"$: json_syntax - {exc.msg}"]

    validator = Draft202012Validator(schema)
    errors = summarize_errors(validator, data)
    if errors or not isinstance(data, dict):
        return None, errors or ["$: type - 顶层结果必须是对象"]
    return data, []


def repair_with_budget(
    initial_raw: str,
    schema: dict[str, Any],
    repair_call: Callable[[str, list[str]], str],
    max_repairs: int = 2,
) -> RepairResult:
    # max_repairs 是业务预算,不允许被异常分支悄悄增加。
    raw = initial_raw
    errors: list[str] = []
    for attempt in range(max_repairs + 1):
        data, errors = parse_and_validate(raw, schema)
        if data is not None:
            return RepairResult("ok", data, raw, [], attempt)
        if attempt == max_repairs:
            # 预算耗尽后保留原文,交给上层决定降级或人工处理。
            return RepairResult("exhausted", None, raw, errors, attempt)
        raw = repair_call(raw, errors)
    raise RuntimeError("unreachable")  # 防止静态检查器误判循环没有返回值
把修复请求限制在“只改格式”
修复调用最重要的不是措辞漂亮,而是责任边界清楚。提示词应要求模型保留原有事实,只补齐可推断的结构;如果原文缺少事实,就把字段置为空或交给降级分支,不要让修复调用重新编造答案。
def build_repair_prompt(raw: str, errors: list[str]) -> str:
    # 只允许模型修复 JSON 结构,不允许借机重写事实内容。
    error_text = "\n".join(f"- {item}" for item in errors)
    return f"""
请修复下面的结构化输出,只返回 JSON,不要 Markdown,不要解释。
约束:保留原有事实;只处理语法、缺失字段、类型和额外字段;无法确定的值不要编造。
校验错误:
{error_text}
原始输出:
{raw}
""".strip()


def make_repair_call(model_call: Callable[[str], str]) -> Callable[[str, list[str]], str]:
    # 把具体模型 SDK 包在边界内,主循环不依赖某个供应商的返回对象。
    def call(raw: str, errors: list[str]) -> str:
        return model_call(build_repair_prompt(raw, errors))

    return call
如果模型或推理服务本身支持 structured output,应优先在第一次请求时传入 Schema;修复循环只是应对偶发解析错误和兼容性差异,不是替代约束解码的万能层。Hugging Face 的结构化输出文档也把 JSON Schema、解析结果和模型调用放在同一条契约链上。
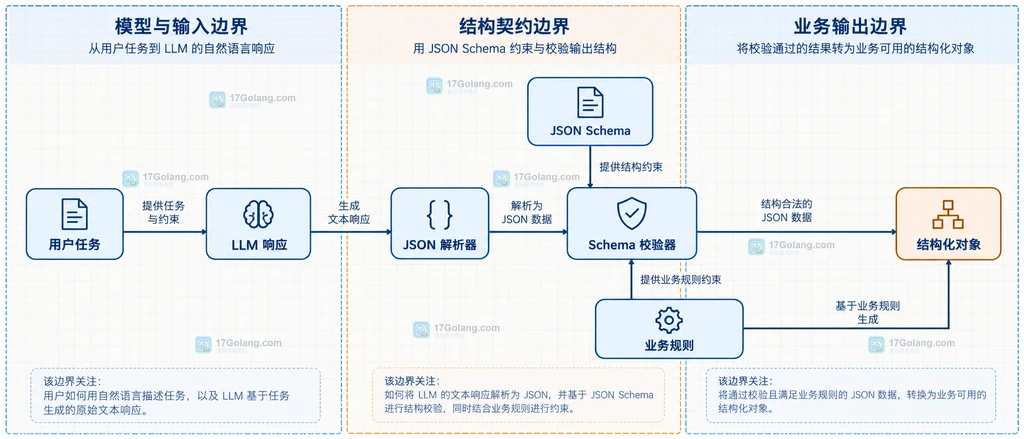
用一个最小项目串起调用边界
目录只保留三个文件,方便把“模型调用”和“结果处理”分开:
structured-repair/
├── schema.py       # JSON Schema 与业务规则
├── repair.py       # 解析、校验、有限修复
└── main.py         # 组装模型调用并输出状态
在真实项目中,model_call 可以接 Hugging Face Inference Providers 或其他兼容客户端;示例不把 Token 写入代码,也不假设某个供应商一定支持相同的 Schema 方言。运行前先固定依赖版本,并把最大修复次数、超时和日志字段做成配置。
SCHEMA = {
    "type": "object",
    "properties": {
        "answer": {"type": "string", "minLength": 1},
        "confidence": {"type": "number", "minimum": 0, "maximum": 1},
        "evidence": {"type": "array", "items": {"type": "string"}, "maxItems": 3},
    },
    "required": ["answer", "confidence", "evidence"],
    "additionalProperties": False,
}


def run(model_call, text: str) -> RepairResult:
    # 第一次请求也应该带结构要求;有限修复只处理服务端偶发偏差。
    initial = model_call(
        "请从下面文本提取 answer、confidence、evidence,严格返回符合给定 JSON Schema 的 JSON。\n"
        f"文本:{text}"
    )
    return repair_with_budget(
        initial_raw=initial,
        schema=SCHEMA,
        repair_call=make_repair_call(model_call),
        max_repairs=2,
    )
这个小项目的关键不是把修复次数设成某个“正确数字”,而是让数字有明确含义:一次初始请求加两次修复,最多三次模型调用。若单次请求平均耗时 2 秒,预算上限就应在接口超时、队列吞吐和业务时效之间做取舍,而不是在异常发生后临时决定。
失败后怎样选择重试、降级或人工处理
可以用下面这张速查表作为调用方契约:
| 状态 | 典型原因 | 建议出口 |
|---|---|---|
| ok | JSON 可解析且通过 Schema | 进入业务层;必要时再做语义规则 |
| repairable | 语法、缺字段、类型或额外字段错误 | 只调用一次受限修复,并记录错误摘要 |
| exhausted | 达到最大修复次数仍不通过 | 返回降级对象、保留原文或转人工 |
| unrecoverable | 模型服务不可用、内容缺失或业务规则冲突 | 按服务重试策略或人工流程处理 |
我个人更倾向于把“格式修复”和“服务重试”分开计数。前者针对同一份输出,通常只允许 1~2 次;后者针对网络超时或服务暂时不可用,要使用指数退避、请求幂等键和更高层的总超时。两种计数混在一个 retry 变量里,很容易出现总调用次数失控。
如果输出涉及订单、权限、付款或其他高风险动作,Schema 通过也不能直接执行动作;应增加人工确认或领域规则校验。结构合法只表示“形状正确”,不表示“事实正确”或“业务允许”。
验收时只看四个可观测结果
不需要把日志做成一大片模型原文。保留请求标识、状态、修复次数、错误摘要和最终出口就够了;原始输出按隐私和保留策略单独存储。验收可以围绕四个问题:
- 合法 JSON 是否一次通过,没有无意义修复调用?
- 缺字段、错误类型和额外字段是否能得到不同的错误摘要?
- 达到上限后是否稳定返回
exhausted,不会递归重试? - 服务异常和业务规则失败是否没有被误标成格式问题?
若这四点都能从日志和返回对象中判断,结构化输出就从“希望模型听话”变成了一个有边界的工程组件。
相关问题
结构化输出已经传了 JSON Schema,还需要修复循环吗?
仍可能需要,但它应该是小预算的兜底。不同模型、推理后端或 Schema 方言支持程度可能不同,第一次响应不一定能覆盖所有边界;若服务已经保证严格结构,可以把修复预算设为 0,并把异常交给上层。
为什么不直接把 max_retries 设得很大?
因为格式错误常常来自同一个提示或同一个输入,重复调用不一定增加信息,反而会放大延迟、费用和重复结果。更大的预算应留给可恢复的服务错误,而不是同一份错误 JSON。
Schema 通过后还要做业务校验吗?
要。Schema 只负责结构和类型,不能替代权限、金额、事实来源、状态机或领域规则。把两者分层,失败时才能给调用方准确的处理建议。
总结
LLM 结构化输出失败后的有限修复,核心是把问题拆开:先解析 JSON,再校验 Schema,最后执行业务规则;只对可定位的格式错误携带短错误摘要进行修复;把修复次数、总超时和服务重试分开计数;达到预算就保留原文并降级,而不是继续循环。这样即使模型偶尔偏离格式,业务代码仍然能得到稳定、可解释的结果。
参考资料:https://json-schema.org/understanding-json-schema/reference/object;https://huggingface.co/learn/cookbook/structured_generation
 PEFT 怎样只保存 adapter 权重
- 上一篇
- PEFT 怎样只保存 adapter 权重
- 下一篇
- RAG 检索结果怎样设置召回和重排的 Top K
-
- 科技周边 · 人工智能 | 1小时前 |
- RAG 文档切片怎样决定 overlap
- 278浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- ONNX 导出怎样声明动态 batch 和序列长度
- 131浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- RAG 检索结果怎样设置召回和重排的 Top K
- 491浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 | LoRa PEFT merge_and_unload adapter unload disable_adapter delete_adapter
- PEFT 怎样卸载 adapter 并保留基础模型
- 485浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- Accelerate mixed_precision 怎样选择 fp16 或 bf16
- 386浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- Accelerate 怎样配置梯度累积
- 356浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 | skip take Hugging Face Datasets streaming IterableDataset shard
- IterableDataset 只有一个 shard 时怎么继续切分数据
- 441浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 | JSON split Hugging Face dataset Datasets
- Hugging Face Datasets 怎样从 JSON 加载数据集
- 266浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- Transformers 生成文本怎样理解 past_key_values 缓存
- 370浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 | 人工智能 · 文本生成 Transformers Python线程 TextIteratorStreamer 流式生成
- Transformers TextIteratorStreamer 怎样流式读取生成结果
- 485浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- Transformers 怎样按模型 chat template 组织消息
- 118浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 474次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 533次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 552次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 506次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 324次使用
-
- Go 1.25 testing.Attr 实战:别让 CI 测试报告只剩一堆失败日志
- 2026-06-02 478浏览
-
- Go 令牌桶限流实战:用 time.Ticker 保护高频接口
- 2026-06-13 484浏览
-
- Go 结构化日志库怎么选:标准库 slog、zap 与 zerolog 的取舍
- 2026-07-22 151浏览
-
- Go 1.26 的 go fix 怎么安全改造旧项目:从扫描到回归验证
- 2026-07-24 396浏览
-
- Go netip 怎么做 CIDR 白名单:解析、匹配与失败回归
- 2026-07-24 167浏览