
RAG overlap 设置过高时如何判断重复上下文
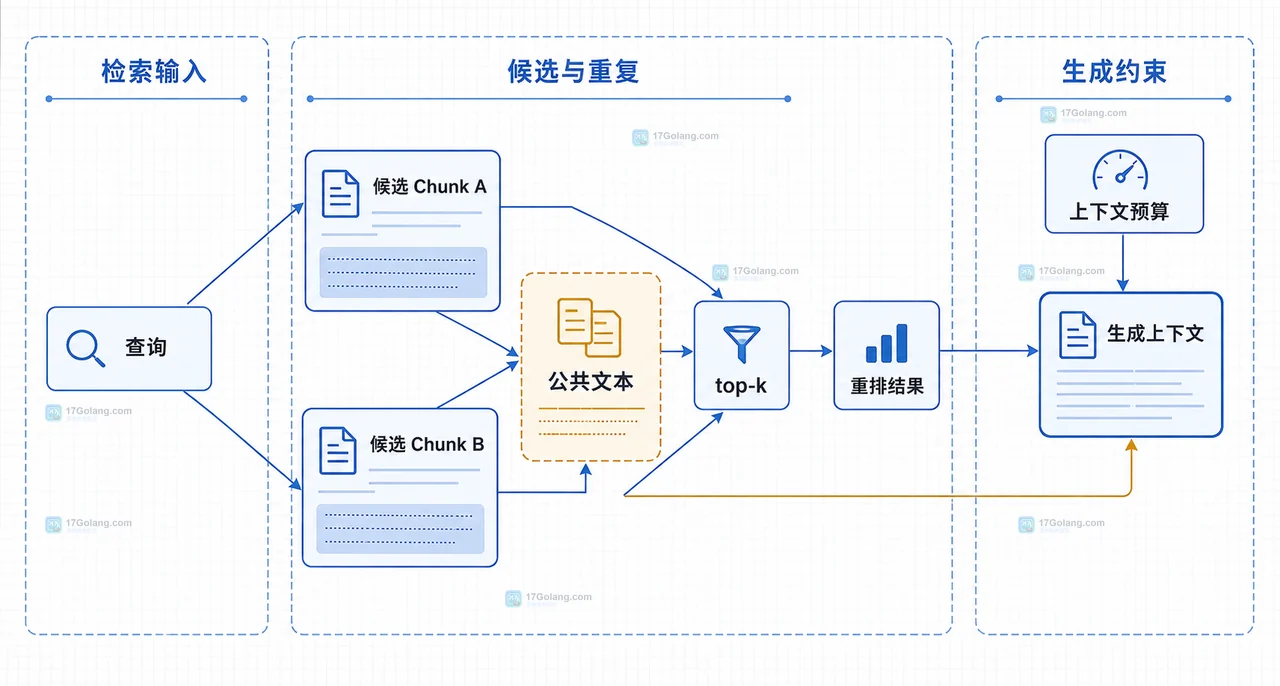
RAG 召回结果里出现几段几乎一样的文字,不一定是检索器“召回错了”,更常见的原因是文档切分时 overlap 相对 chunk size 太大。判断标准也不是某个固定数字:要看相邻 chunk 的重复比例、同一次 top-k 结果里有多少公共文本,以及这些重复内容是否挤占了真正有用的上下文。
先固定 embedding、问题集和 top-k,只改变 chunk size 与 overlap 做小样本对照。若候选片段的公共文本持续占据生成上下文,而跨段问题没有得到更多有效信息,就应降低 overlap,或先改进标题、段落和表格边界。
overlap要和chunk size一起看,绝对值大不等于一定错误。- 重复上下文要在召回结果中判断:记录公共文本、文档位置和最终送入模型的长度。
- 用同一组跨段问题做对照实验,先建立低 overlap 基线,再决定是否增加重叠。
先把 overlap 换算成相邻 chunk 的重复比例
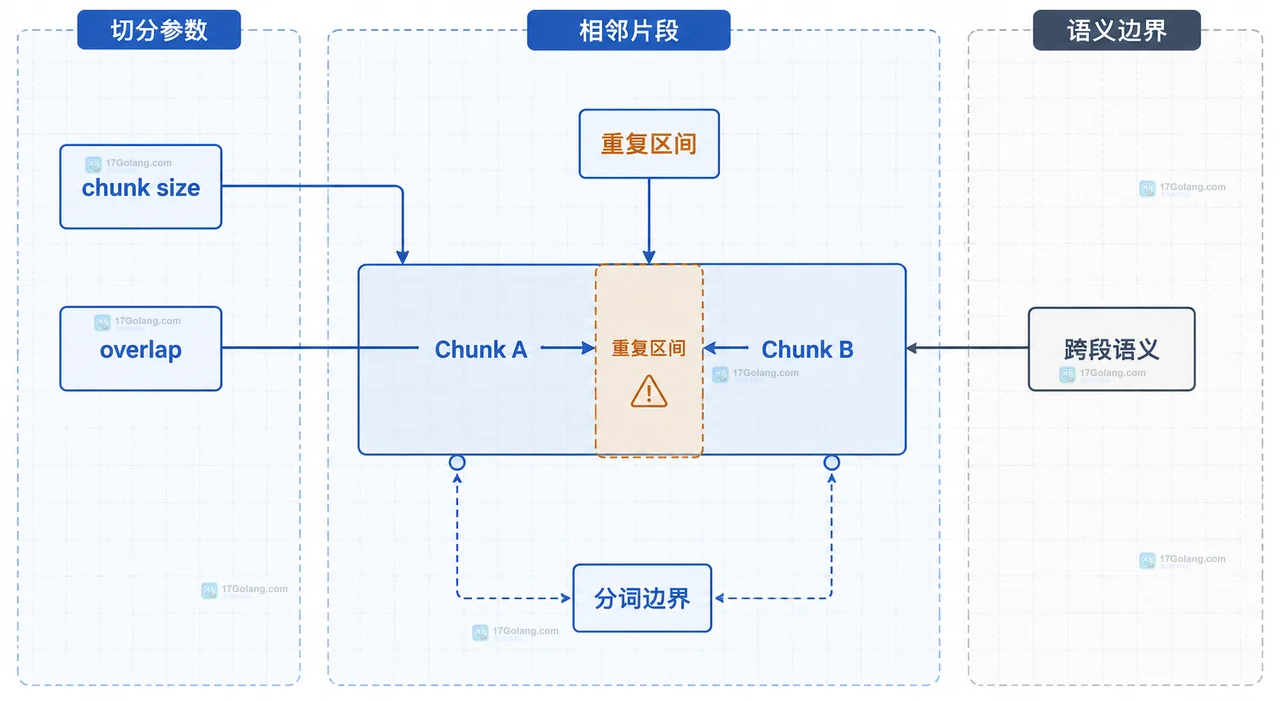
chunk size 决定一个片段能承载多少内容,overlap 决定下一个片段保留前一个片段多少内容。两者的相对关系比单独看 100 或 200 更有意义。可以先用一个简单的诊断比例:
# 这是排查用的相对比例,不是某个向量库的固定阈值
重复比例 = overlap / chunk size

# 只有在同一计量单位下比较,才有解释意义
chunk_size = 512
overlap = 128
例如同样是 128 个 token,放在 256 的 chunk 里和放在 1024 的 chunk 里,意味着完全不同的重叠程度。重叠的价值在于保住跨边界的句子、定义或条件;如果每个相邻片段都复制整段背景,新增信息就会越来越少。
短段落、标题和表格是容易误判的地方。它们可能因为边界保护而重复,但并不代表召回无效。排查时把每个 chunk 的文档位置、字符范围和前后公共文本一起记录,先确认重复来自切分策略,而不是源文档本来就反复写了同一句。
从召回结果判断重复上下文而不是只看切片数量
切片数量变多,只能说明索引里对象变多,不能直接证明 overlap 过高。更可靠的观察对象是一次查询的 top-k:候选 chunk 是否来自相邻位置,前后片段是否共享大段文本,重排后仍然保留多少真正不同的证据。
| 观察项 | 说明 | 异常信号 |
|---|---|---|
| 文档位置 | 候选 chunk 在原文中的起止范围 | 多个结果连续覆盖同一小段 |
| 公共文本 | 相邻候选之间重复的句子或 token | 公共部分接近每个 chunk 的主体 |
| 新增信息 | 每加入一个候选后增加的事实 | top-k 增加但答案证据没有增加 |
| 生成上下文 | 重排后真正送给模型的内容 | 重复文本占预算,关键片段被截断 |
分数相近也不等于内容重复,分数不同也不等于内容互补。可以把一次检索的候选保存成带有 doc_id、start、end 和文本摘要的记录,再统计相邻结果的公共区间。若两个候选只是在向量空间接近,但一个包含定义、另一个包含例外条件,它们仍可能值得同时保留。
用小样本对照实验重新选择参数
调参时把变量控制住:embedding 模型、检索器、top-k、重排规则和问题集保持不变,只建立两到三组切分参数。问题集要包含段内问题、跨段问题、需要例外条件的问题,避免只用一个“看起来命中”的查询。
# 每组参数使用同一批文档和同一批问题,便于横向比较
CHUNK_SIZE=512
CHUNK_OVERLAP=64

# 记录公共文本比例、有效新增信息和端到端延迟
python3 measure_retrieval.py \
  --chunk-size "$CHUNK_SIZE" \
  --overlap "$CHUNK_OVERLAP" \
  --query-set eval-cross-section.json
表格里至少保留三列:召回是否覆盖答案所需片段、候选之间的重复比例、生成上下文长度。低 overlap 组如果丢失跨段定义,再逐步增加;高 overlap 组如果只是让相邻片段一起出现,却没有提高跨段问题的覆盖,就没有继续加大的理由。
把 overlap 调整和上下文预算一起落地
NVIDIA RAG Blueprint 的参数说明把 APP_NVINGEST_CHUNKOVERLAP 与 APP_NVINGEST_CHUNKSIZE 分开列出,并明确更大的 overlap 可能增加处理开销,更大的 chunk 也可能增加 embedding 成本、召回上下文长度和生成延迟。这个关系说明:overlap 不是孤立的“准确率旋钮”,它会影响索引、召回和生成三段链路。
实际落地可以按下面的顺序检查:
- 先用较小 overlap 建基线,确认段内问题和跨段问题分别缺什么。
- 只增加一档 overlap,比较公共文本和答案覆盖是否同时改善。
- 若上下文变长但有效信息不变,优先减少 overlap 或降低送入生成的重复候选。
- 保存参数版本、代表性问题和召回样本,避免下一次只凭模型主观感受回调。
如果源文档的标题、列表和表格被切散,单纯提高 overlap 往往只是把结构问题复制得更长。先修正结构化切分,再决定是否需要更多重叠,通常比不断扩大上下文更容易解释。
常见问题
overlap 越大,RAG 准确率就越高吗?
不一定。它可能保住跨边界语义,也可能增加重复文本、处理开销和生成延迟。应以固定问题集的有效覆盖和重复比例共同判断。
只看 top-k 里有几个相邻 chunk 可以吗?
不够。相邻只说明位置接近,还要比较公共文本和每个候选带来的新增事实;定义与例外条件可能来自相邻但不同的片段。
应该先调 chunk size 还是 overlap?
先建立一组固定 chunk size 的低 overlap 基线,再小步调整 overlap。只有当单个 chunk 本身无法容纳完整语义单元时,才同时评估更大的 chunk size。
判断 overlap 是否过高,核心是看“重复内容占了多少预算,却增加了多少答案信息”。把相对比例、召回公共文本和固定问题集放在一起,参数选择才有可复现的依据。
 Go fuzz 运行很慢时怎么缩小语料和执行范围
- 上一篇
- Go fuzz 运行很慢时怎么缩小语料和执行范围
- 下一篇
- Go 正则匹配日志字段时怎么把子匹配映射成结构体
-
- 科技周边 · 人工智能 | 5小时前 |
- AI 流式输出怎样区分文本增量和工具事件
- 491浏览 收藏
-
- 科技周边 · 人工智能 | 5小时前 |
- AI 工具调用怎样设计幂等键避免重复执行
- 319浏览 收藏
-
- 科技周边 · 人工智能 | 5小时前 |
- AI 应用怎样让结构化输出失败时安全回退
- 395浏览 收藏
-
- 科技周边 · 人工智能 | 5小时前 |
- OpenAI Responses API 怎样迁移旧工具调用代码
- 260浏览 收藏
-
- 科技周边 · 人工智能 | 5小时前 | 安全 · openai · OpenAI 沙箱 工具权限 Agents API Agents SDK
- OpenAI Agents API 怎样把工具权限限制在沙箱
- 321浏览 收藏
-
- 科技周边 · 人工智能 | 5小时前 | Prompt Caching OpenAI API cached_tokens
- OpenAI API prompt caching 怎样判断缓存命中边界
- 150浏览 收藏
-
- 科技周边 · 人工智能 | 5小时前 |
- Gemini API 多轮对话怎样保存历史消息
- 263浏览 收藏
-
- 科技周边 · 人工智能 | 5小时前 |
- Gemini API embeddings 怎样区分对称与非对称检索
- 378浏览 收藏
-
- 科技周边 · 人工智能 | 5小时前 |
- Gemini API function calling 怎样区分工具调用与最终回答
- 290浏览 收藏
-
- 科技周边 · 人工智能 | 5小时前 | JSON · API · python · 人工智能 · 结构化输出 · 结构化输出 JSON Schema Gemini API response_schema response_mime_type additionalProperties
- Gemini API 结构化输出怎样限制 JSON 字段
- 145浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 614次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 653次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 686次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 646次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 475次使用
-
- CodeGeeX for Jetbrains IDEs正式上线!
- 2023-01-17 284浏览
-
- 技术阿里云实现ocr批量图片和pdf文件表格图片转换excel文档/支持票据图片提取/普通图片文字提取处理
- 2023-01-18 387浏览
-
- 直播预告|FeatureStore Meetup V2
- 2023-01-10 328浏览
-
- 深入浅出特征工程 – 基于 OpenMLDB 的实践指南(上)
- 2023-02-25 426浏览
-
- 开源机器学习数据库OpenMLDB v0.4.0产品介绍
- 2023-01-10 147浏览


