
RAG 应用答错怎么复盘:检索命中、证据门禁和评测样本怎么补
RAG 应用上线后答错,大家第一反应往往是“模型不稳定”。但把日志摊开捋一遍就会发现,很多问题根本不是模型凭空乱讲,而是前面检索层已经把错误证据送进了上下文:用户问题没改写好、知识切片切得太碎、相似度匹配命中了同名的旧文档,最后模型只是把这些不靠谱的证据组织成一段看起来逻辑完整的回答。
- 先把用户问题、检索词、召回片段、排序结果和最终回答串成完整链路,不要只盯着模型输出找问题。
- RAG 答错的常见根因是证据错、证据少、证据过旧、证据没有被强制引用。
- 修复动作不只是换模型,还包括调整切片策略、加元数据过滤、优化重排逻辑、新增引用约束和拒答规则。
- 避免问题复发要沉淀专属问题集,覆盖高频问法、别名表述、过期文档干扰和各类边界场景。
影响面:一个错误回答可能来自检索全链路
假设内部客服助手回答“企业版数据保留多久”,给出的结论是90天。客服照着回复客户,半小时后产品同事发现企业版当前实际规则是180天,90天是旧版本帮助文档里的废弃规则。这个事故看起来是AI答错,实际影响范围包括给到客户的错误承诺、一线客服对助手的信任度,还有整个知识库的治理规范。
这类问题很适合按链路逐层拆解排查。用户实际输入了什么?系统把它改写成了什么检索词?召回了哪些片段?这些片段来自哪篇文档、哪个版本、什么时间发布的?回答里有没有明确标注对应来源?一条链路顺完,才能确定到底该修模型、修检索逻辑,还是修整个知识库。

时间线:从用户投诉到定位证据错位
一次很典型的RAG答错复盘,可以按照下面的时间线逐步推进:
| 时间点 | 看到的现象 | 下一步检查 |
|---|---|---|
| 10:05 | 客服反馈答案和产品现行规则冲突 | 找到对应会话编号和用户原始问题 |
| 10:12 | 返回的回答没有展示引用来源 | 回溯检索日志和传入上下文的所有片段 |
| 10:25 | 检索命中了已经失效的旧版帮助文档 | 检查文档附带的元数据和排序规则配置 |
| 10:40 | 新版本规则的文档也在知识库内,但排序位置非常靠后 | 补充版本过滤逻辑和证据门禁规则 |
这张表不是为了写事故报告凑内容,而是为了避免团队讨论跑偏。RAG链路里任何一层都可能出问题,顺着时间线追溯,可以把“感觉模型不行”的模糊判断,变成可验证的具体事实。
触发条件:同名文档、旧规则和模糊问法叠在一起
RAG 最怕“看起来高度相关”的错误证据。比如知识库里同时存了《企业版计费规则 2024》《企业版计费规则 2025》《客户续费 FAQ》三篇内容,用户只问“企业版保留多久”,向量检索大概率会把三篇文档都召回。没有版本过滤的情况下,旧文档的语义相似度分数未必会比新文档低。
还有一类触发条件来自用户的非标准问法。用户不会总按照产品文档里的标准术语提问,他们可能说“记录能留几个月”“历史数据会不会被清”“过期后还能恢复吗”。如果查询改写逻辑只抓住了“历史数据”这个关键词,就可能召回归档、备份、审计日志等完全不同语义的文档。
根因:证据没有被当成核心优先级对象
很多RAG项目一开始把重点放在“能不能答出内容”,而不是“答案基于哪条证据生成”。于是日志里只有最终回答,没有召回的片段内容;就算有召回片段,也没有记录对应的文档版本和相似度分数;就算有分数,也没记录模型实际引用了哪一句。到要复盘的时候,团队只能凭猜测排查。
我更建议把证据当成第一优先级的核心对象。每次回答至少记录这些字段:
question_id:原始问题和改写后的检索问题。chunk_id:命中的文档片段编号、文档版本、更新时间。score:向量相似度、重排分数、经过的过滤条件。citation:回答实际引用了哪些片段,哪些片段只是进入上下文但没有被采用。answer_status:正常回答、证据不足、需要人工确认。
把这些字段补全,复盘就会变成标准工程问题,而不是大家围着讨论模型稳定性的玄学话题。
修复动作:先堵错误证据,再优化回答体验
修RAG答错问题,不要一上来就换大模型。换模型可能让生成的回答更流畅,但如果检索层仍然在往上下文里送错误证据,流畅度反而会放大错误的影响范围。更稳妥的顺序是先修复证据过滤逻辑,再优化回答表达效果。
- 给所有文档加上版本、产品线、适用地区、发布时间等元数据标签。
- 检索时先做业务规则过滤,再做语义召回,从源头避免旧文档进入候选集。
- 对高风险类问题增加重排步骤和证据门禁,证据不足时不要强行生成回答。
- 回答模板要求必须标注引用来源,没有可引用的结论时改为提示用户人工确认。
- 把本次错例加入测试问题集,作为后续版本上线前的回归样本。
这里不需要急着追求“任何问题都能回答”。RAG的价值不只是能回答更多问题,更重要的是知道什么时候不该随便回答。
防复发:证据门禁和问题集要一起补全
避免问题复发的核心是两件事:回答生成前有证据门禁拦截,新版本上线前有问题集回归校验。证据门禁负责拦住“证据不足、证据冲突、证据过旧”的不合格回答;问题集负责让团队感知到新一轮功能改动有没有把之前修好的老问题重新触发。
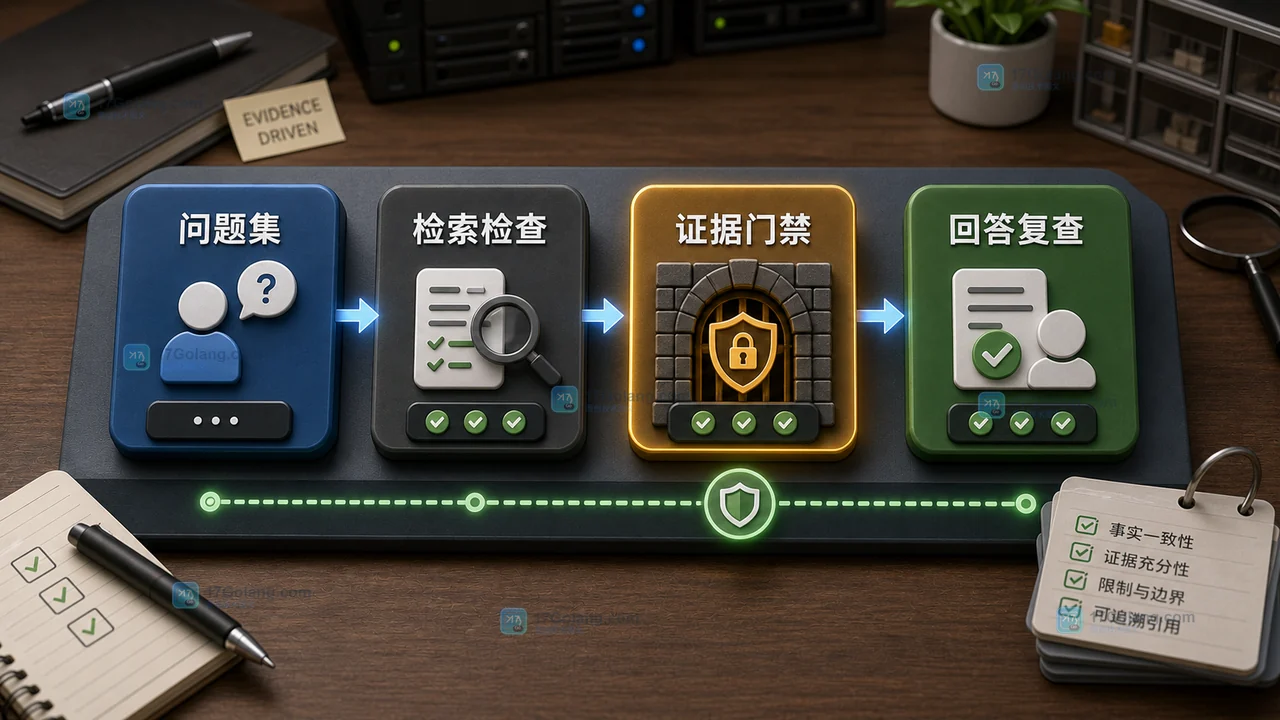
问题集不需要一开始就做得很大,但要有足够代表性。比如覆盖50个高频使用问题、20个同义不同表述的问法、20个有过期文档干扰的问题、10个应该触发拒答的边界问题。每次更新知识库、调整切片策略或者升级模型版本,都把这套问题集跑一遍。
防复发检查清单
- 知识库内所有文档是否标注了版本、时间、业务范围等元数据。
- 检索日志是否能查到原问题、改写后的检索问题、命中片段和排序分数。
- 回答是否要求关联引用证据,引用是否能直接定位到具体的内容片段。
- 出现证据冲突时是否配置了拒答或者转人工确认的流程。
- 历史错例是否进入问题集,并且在下次版本上线前跑一遍回归校验。
- 高风险类答案是否配置了人工复核逻辑或者灰度开关。
常见问题
RAG 答错一定是模型能力不够吗?
不一定。很多答错问题来自检索层和知识库治理环节,比如召回了旧版本文档、切片丢失了上下文、过滤条件配置缺失。模型只是根据传入的材料组织输出内容。
为什么有了引用还会答错?
引用只能说明答案看起来有来源支撑,不代表来源内容本身一定正确。还要检查引用的片段是不是最新版本、是否适用当前产品线,以及回答内容是否真的完全基于该片段生成。
问题集要做到多大才够用?
早期不必追求大而全,先覆盖高频问题、同义问法、历史错例和必须拒答的边界场景。随着线上反馈积累,再逐步扩充内容。
证据不足时应该怎么回答?
最好明确告诉用户当前没有足够的匹配信息,并给出下一步的核对方式。比起编造一个逻辑完整的错误答案,偏保守的回答策略更适合生产环境使用。
最后落到根因
RAG 答错不是单点故障,它通常是知识库、检索、排序、引用和评测多个环节共同暴露出来的链路缺口。把证据链路补全,把错例沉淀成测试问题集,再让所有生成回答都经过证据门禁校验,RAG 应用才会从“只能现场演示”的玩具,变成“可复盘、可迭代、稳定上线”的生产级系统。
 AI Agent 工具调用怎么落地:权限闸门、审批链路和上线观察指标
- 上一篇
- AI Agent 工具调用怎么落地:权限闸门、审批链路和上线观察指标
- 下一篇
- Go Mutex 和 channel 哪个性能更好:共享变量、任务交接和等待链怎么选
-
- 科技周边 · 人工智能 | 11小时前 |
- 模型路由怎么做:按任务难度分配速度、成本与质量
- 147浏览 收藏
-
- 科技周边 · 人工智能 | 13小时前 |
- 多模态模型读图前,图片缩放与裁切会影响什么
- 247浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | 人工智能 · 推理优化 ONNX Runtime 动态量化 nodes_to_exclude
- ONNX Runtime 动态量化怎么选择需要排除的节点
- 377浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | 人工智能 · 向量检索 · Sentence Transformers truncate_dim 嵌入维度 Matryoshka 向量存储
- Sentence Transformers 怎么截断嵌入维度减少存储
- 165浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- PEFT 多个 adapter 怎么按权重组合推理
- 454浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- Accelerate 大模型推理怎么自动分配到多块设备
- 358浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | 人工智能 · Tokenizers offset_mapping 原始文本
- Tokenizers offset mapping 怎么映射回原始文本位置
- 328浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | python · 人工智能 · shuffle Hugging Face Datasets streaming IterableDataset buffer_size
- Datasets streaming 怎么在不下载全集时打乱样本
- 470浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 372次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 443次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 449次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 395次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 220次使用
-
- Go pprof goroutine 画像怎么看阻塞点:采样信号、状态分类与复现验证
- 2026-08-26 263浏览
-
- CodeGeeX for Jetbrains IDEs正式上线!
- 2023-01-17 284浏览
-
- 技术阿里云实现ocr批量图片和pdf文件表格图片转换excel文档/支持票据图片提取/普通图片文字提取处理
- 2023-01-18 387浏览
-
- 直播预告|FeatureStore Meetup V2
- 2023-01-10 328浏览
-
- 深入浅出特征工程 – 基于 OpenMLDB 的实践指南(上)
- 2023-02-25 426浏览


