
用户交互延迟测量方法全解析
本文深入解析了用户首次交互延迟(FID)的准确测量方法,明确指出Event Timing API是当前唯一能原生、可靠获取标准FID的机制——它通过startTime与processingStart两个关键时间戳精准捕获从用户触发事件到浏览器真正开始处理之间的全链路延迟(含主线程排队等待),而广为误用的performance.getEntriesByName('first-input')仅返回微不足道的回调执行耗时(duration),完全忽略阻塞瓶颈,极易造成“响应飞快”的假象;文章不仅厘清原理、揭露常见误区,还提供了Chrome/Edge/Firefox的兼容性细节、正确的PerformanceObserver配置要点、Safari等不支持环境下的高精度手动监听fallback方案(依托event.timeStamp与capture阶段捕获),并强调FID必须线上真实采集、单次上报、合理采样——因为那几十毫秒的遗漏,恰恰是用户感知卡顿的核心真相。

Event Timing API 是目前唯一能直接、可靠获取用户首次交互延迟(FID)的原生机制,performance.getEntriesByName('first-input') 返回的 duration 不是 FID,它只反映事件处理耗时,不包含主线程排队等待时间。
为什么不能用 performance.getEntriesByName('first-input') 取 FID
这个 API 的返回值是 FirstInputEntry,其 duration 字段等于事件回调执行完成时刻减去开始执行时刻,即纯 JS 处理耗时。但 FID 定义为「用户触发事件」到「浏览器开始执行该事件回调」之间的时间差——中间那段被阻塞、排队的时间才是关键。这个起始点(processingStart)在 Entry 对象中并未暴露,所以必须靠 Event Timing API 或手动监听补全。
常见错误现象:duration 常为 0 或极小值(如 0.2ms),让人误以为交互响应很快,实则主线程可能已卡住 200ms 才轮到调度该事件。
- 只有 Chrome 69+、Edge 79+、Firefox 105+ 支持
first-input类型的 PerformanceEntry - 即使支持,也仅对页面生命周期内首个
click/keydown/mousedown/touchstart生效 - 若页面加载后未触发这四类事件,
getEntriesByName('first-input')返回空数组
用 performance.getEntriesByType('event') 捕获真实 FID
Event Timing API(event 类型 entry)才是 W3C 正式推荐方式,它在事件调度前就记录了 startTime(用户触发时间)和 processingStart(浏览器真正开始处理的时间),二者之差就是标准 FID。
使用前提:需在页面早期(如 中)启用 event 类型的 PerformanceObserver,否则会错过首个事件。
- 必须设置
buffered: true,否则页面加载完成前发生的事件不会被缓存上报 - 只监听
event类型,不要混用first-input;后者是旧兼容层,语义模糊 entry.name是事件类型字符串(如"click"),entry.duration仍是处理耗时,别再误用- FID 值 =
entry.processingStart - entry.startTime,该值可能为 0(无阻塞),也可能达数百毫秒
const observer = new PerformanceObserver((list) => {
  for (const entry of list.getEntries()) {
    if (entry.name === 'click' || entry.name === 'keydown') {
      const fid = entry.processingStart - entry.startTime;
      if (fid > 0) {
        console.log('FID:', fid);
        observer.disconnect(); // 仅上报首个
      }
    }
  }
});
observer.observe({ type: 'event', buffered: true });
兼容 fallback:手动监听 + event.timeStamp 计算
当目标环境不支持 Event Timing API(如 Safari 全系、旧版 Firefox),只能退回到手动监听方案,但要注意精度与时机限制。
核心依据:event.timeStamp 是高精度、单调递增的时间戳(相对 navigationStart),且在事件派发瞬间就已固化,比 Date.now() 或 performance.now() 更可信。
- 监听必须覆盖
click、keydown、mousedown、touchstart四种类型 - 监听器要加
{ capture: true },确保在捕获阶段就拿到事件,避免冒泡阶段被其他逻辑阻塞 - 必须在事件回调第一行立即调用
performance.now(),延迟哪怕几毫秒都会引入误差 - 需检查
document.hidden,过滤掉后台标签页中触发的事件
容易踩的坑:event.timeStamp 在某些低版本 Android WebView 中可能不准;performance.now() 若在长任务后调用,会把执行延迟误算进 FID。
上报与采样注意事项
FID 是单页生命周期内仅发生一次的指标,上报逻辑必须做到“捕获即止”,重复上报或跨 SPA 路由重置状态都会污染数据。
生产环境建议做简单采样(如 10% 用户),避免大量日志冲垮监控服务;同时保留原始 processingStart 和 startTime,方便后续做分布分析(比如 P75 FID 是多少)。
真正容易被忽略的是:FID 无法在实验室工具(如 Lighthouse)中稳定复现,它高度依赖真实用户操作节奏和设备负载。所以线上采集不可替代,而手动监听方案里漏掉的那几十毫秒,往往就是用户感知卡顿的全部原因。
本篇关于《用户交互延迟测量方法全解析》的介绍就到此结束啦,但是学无止境,想要了解学习更多关于文章的相关知识,请关注golang学习网公众号!
 数组变量虚拟机优化技巧解析
- 上一篇
- 数组变量虚拟机优化技巧解析

- 下一篇
- 瘦手臂小技巧:减肥期快速塑形方法
-
- 文章 · 前端 | 6小时前 |
- ARIA live 怎样播报异步状态变化
- 261浏览 收藏
-
- 文章 · 前端 | 6小时前 | html · 可访问性 焦点管理 HTML inert 模态框背景禁用
- HTML inert 怎样暂时禁用背景区域交互
- 153浏览 收藏
-
- 文章 · 前端 | 6小时前 | css · 表单 · 表单布局 CSS field-sizing 文本框自适应 textarea 自动高度
- CSS field-sizing 怎样让文本框高度随内容变化
- 328浏览 收藏
-
- 文章 · 前端 | 6小时前 | css ·
- CSS 容器查询怎样按组件宽度切换布局
- 330浏览 收藏
-
- 文章 · 前端 | 6小时前 |
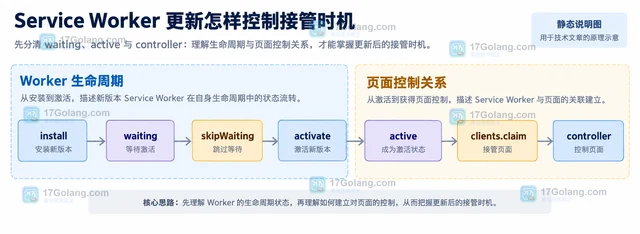
- Service Worker 更新怎样控制接管时机
- 486浏览 收藏
-
- 文章 · 前端 | 6小时前 | 前端 · javascript · request Cache API Cache.match Vary
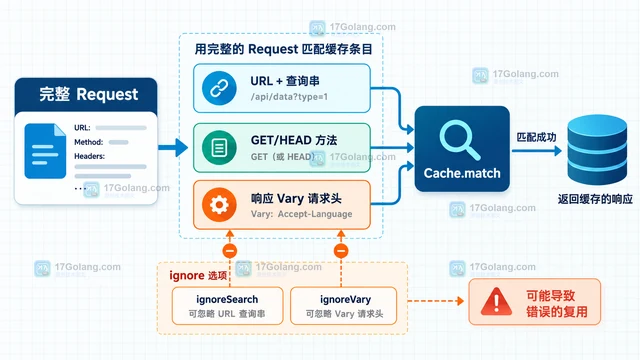
- Cache API 怎样用完整请求区分缓存条目
- 432浏览 收藏
-
- 文章 · 前端 | 6小时前 |
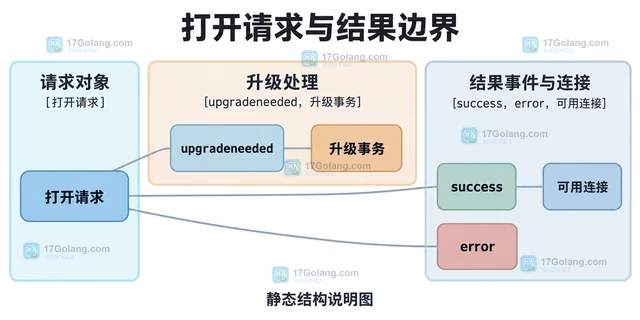
- IndexedDB 数据库升级怎样处理版本变更
- 483浏览 收藏
-
- 文章 · 前端 | 7小时前 |
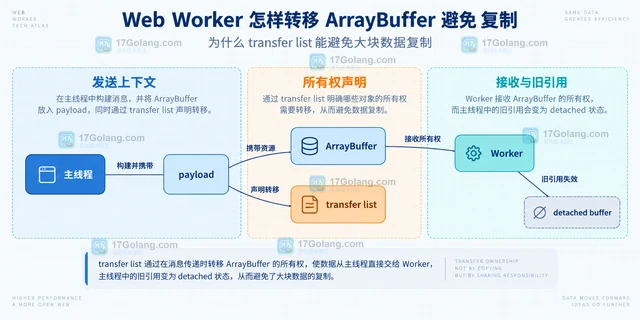
- Web Worker 怎样转移 ArrayBuffer 避免复制
- 408浏览 收藏
-
- 文章 · 前端 | 7小时前 | 前端 · javascript · AbortController ReadableStream Streams API
- ReadableStream 取消后怎样释放请求
- 203浏览 收藏
-
- 文章 · 前端 | 7小时前 | javascript · 前端工程 · ReadableStream 流式响应 TransformStream pipeThrough Streams API
- ReadableStream 怎样用 TransformStream 转换数据
- 151浏览 收藏
-
- 文章 · 前端 | 7小时前 |
- Fetch 怎样用 AbortSignal.timeout 设置请求超时
- 166浏览 收藏
-
- 文章 · 前端 | 7小时前 |
- Fetch keepalive 适合发送哪些小请求
- 397浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 479次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 535次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 558次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 507次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 328次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览