
Perplexity大模型追踪技术解析
如果你正苦于在碎片化、滞后且缺乏上下文的大模型信息洪流中迷失方向,Perplexity不仅能帮你实时捕获全球顶尖AI技术的每一次关键跃迁,更能通过Pro版聚焦模式、动态时间轴提问链、API自动化监控、多源交叉验证与本地知识图谱构建,将零散资讯转化为可追溯、可验证、有时序逻辑的个人技术演进操作系统——让GPT-4o的发布、DeepSeek-v3的架构突破、Qwen2.5-Max的评测争议,不再只是孤立新闻,而成为你理解AI发展脉络的坚实坐标。
如果您希望掌握全球大模型技术的最新进展,但信息来源分散、更新滞后或缺乏上下文关联,则可能是由于缺乏结构化、可验证且具备时间纵深的追踪机制。Perplexity作为具备实时检索、多源编排与引用溯源能力的“答案引擎”,可被系统性地用于构建个人化的技术演进追踪工作流。以下是实现该目标的具体路径:
一、启用Pro订阅并配置领域专属搜索模式
Perplexity Pro版本支持自定义搜索模式(Focus Mode),允许用户锁定特定技术范畴,避免通用结果干扰。启用后,系统将优先调用学术数据库、技术博客、官方发布日志及GitHub仓库变更记录等高信噪比信源。
1、登录perplexity.ai账户,点击右上角头像进入Settings。
2、在左侧菜单选择“Subscription”,完成Pro版本升级(当前月费为$20)。
3、返回主页,在搜索框右侧点击“Focus”下拉菜单,选择“Research”或手动创建新模式,命名为“LLM Evolution”。
4、在模式设置中添加关键词白名单:“GPT-4o release notes”、“DeepSeek v3 technical report”、“Qwen2.5-Max architecture”、“o1 reasoning benchmark”,并排除“tutorial”、“beginner”、“opinion”类低信源标签。
二、构建动态时间轴式提问链
利用Perplexity的对话记忆与上下文继承特性,通过递进式自然语言提问,驱动AI自动拼接跨时间点的技术事件,形成具备因果逻辑的时间轴,而非孤立快照。
1、首次输入:“列出2024年1月至2026年4月间,OpenAI、DeepSeek、阿里通义、Google DeepMind发布的所有大模型架构级更新,按时间倒序排列,注明参数规模、训练数据量、关键能力突破。”
2、紧接追问:“对比上述模型在‘推理延迟’与‘多模态对齐精度’两项指标上的公开实测数据差异,仅引用arXiv论文、厂商白皮书或权威媒体(如TechCrunch、MIT Technology Review)报道。”
3、再追问:“哪些2025年下半年发布的模型变更,直接回应了2024年LLaVA-Rad或Gemini 2.0暴露的医学影像报告生成缺陷?请定位具体技术方案(如LoRA微调策略、视觉token重采样机制)。”
三、接入第三方数据源实现自动化监控
Perplexity支持通过API与外部工具链集成,将高频技术动态转化为可订阅的结构化通知。配合Terra API或b.well健康数据网络的工程化思路,可复用其数据管道逻辑对接AI技术信源。
1、访问Perplexity开发者门户(developer.perplexity.ai),获取Personal API Key。
2、使用curl或Python requests向https://api.perplexity.ai/chat/completions发送POST请求,携带预设prompt模板:“检测过去72小时内GitHub trending中stars增幅超200%的LLM相关仓库,提取README首段、main branch最近三次commit message、以及issue中被标记为‘bug’或‘feature request’的高频术语。”
3、将响应JSON解析后,推送至Notion数据库或Telegram Bot,触发关键词高亮提醒:“FlashAttention-3”、“MoE routing instability”、“quantized KV cache leakage”。
四、交叉验证技术主张的真实性
针对厂商宣传中易被放大的技术指标(如“地球上最聪明的AI”),Perplexity的事实导向机制可强制回溯原始证据链,识别断言与实证间的偏差区间。
1、输入问题:“Qwen2.5-Max被称作‘地球上最聪明的AI’,该说法首次出现在哪篇公开文档?其支撑评测基准(如MMLU、GPQA、HumanEval)的原始得分与测试环境配置是否完整披露?”
2、检查每条引用链接是否直达arXiv编号、Hugging Face模型卡或百炼平台API文档页,而非新闻稿或营销页面。
3、若某引用指向微信公众号文章,追加提问:“该公众号运营主体是否具备独立评测资质?其引用的‘千万卡时算力资源池’是否列明GPU型号、互联带宽与冷却方式?”
五、建立本地知识图谱增强长期记忆
Perplexity本身不存储用户历史数据,但可通过导出引用片段+手动标注,构建轻量级本地图谱,使2024年的技术决策能与2026年的演进路径显式关联。
1、每次获得有效回答后,点击右下角“Export citations”按钮,选择BibTeX格式下载。
2、使用Zotero导入文件,在每条文献元数据中添加自定义字段“Tech_Evolution_Node”,值设为“Foundation_Model_Scaling”、“Reasoning_Architecture”或“Safety_Framework”。
3、在Zotero内启用“Related”功能,手动连接2024年GPT-4训练成本(6300万美元)与2026年o3-mini部署成本数据,标注关系类型为“cost_reduction_ratio”。
今天关于《Perplexity大模型追踪技术解析》的内容就介绍到这里了,是不是学起来一目了然!想要了解更多关于的内容请关注golang学习网公众号!
 个税异地报税入口及操作指南
- 上一篇
- 个税异地报税入口及操作指南
- 下一篇
- 蓝海书屋官网入口推荐地址
-
- 科技周边 · 人工智能 | 1天前 | AI 图像生成 图像编辑 text-to-image
- AI 生成图片 API 怎样区分文本到图像与图像编辑
- 484浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- AI 结构化输出怎样处理字段缺失
- 126浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | 参数校验 · 人工智能 · 工具调用 · 结构化输出 AI工具调用 JSON Schema 业务校验 Tool calling Agent工程
- AI 工具调用怎样区分模型参数校验和业务校验
- 105浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | RAG CrossEncoder Reranker 重排模型 初召回
- RAG 重排模型怎样放在召回链路中
- 245浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
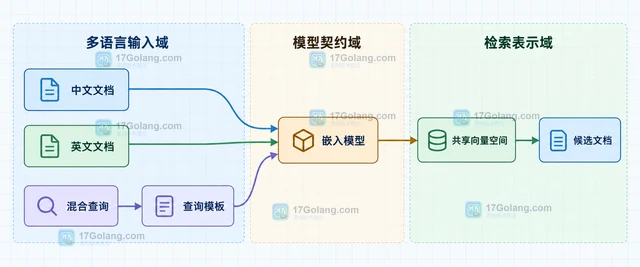
- 向量检索怎样按文档语言过滤召回结果
- 172浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
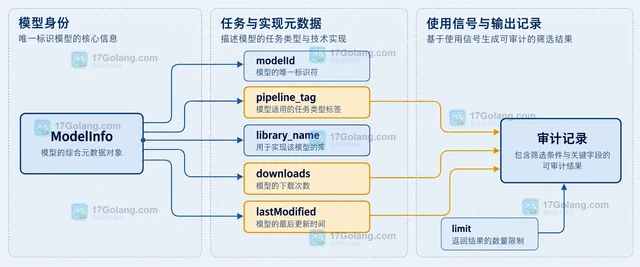
- Hugging Face HfApi 怎样按 pipeline_tag 筛选模型
- 419浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | 人工智能 · 结构化输出 人工复核 业务规则 AI 输出过滤 guardrails
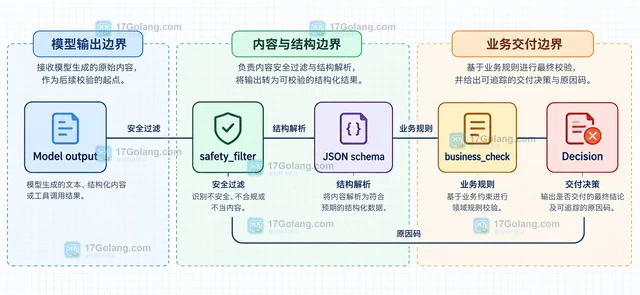
- AI 输出过滤怎样与业务规则分层
- 400浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 582次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 620次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 654次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 618次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 435次使用
-
- 量化模型本地推理的显存估算方法
- 2026-10-17 501浏览
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览


