
数组实现内存对齐与变量管理实战解析
2026-05-20 17:18:49
0浏览
收藏
本文深入解析了如何利用普通char数组手动实现内存对齐与高效变量布局,揭示了数组作为连续内存块所具备的天然对齐潜力——无需依赖编译器扩展或malloc对齐函数,仅通过位运算(如`(addr + align-1) & ~(align-1)`)即可在原始缓冲区内精准定位对齐地址,并按`alignof(T)`和`sizeof(T)`动态管理偏移量,紧凑安放不同对齐要求的变量;进一步封装为轻量级内存池结构,支持可复用、可重置的对齐分配,同时警示关键陷阱:对齐值必须为2的幂、严禁非对齐解引用、注意架构差异(如ARM对未对齐访问的严格异常),让开发者真正掌握底层内存控制的主动权。
数组本身是连续内存块,天然具备地址对齐的物理基础。只要控制数组元素类型、数量和起始偏移,就能模拟手动内存对齐行为,无需依赖编译器扩展或 malloc 对齐分配函数。
用 char 数组模拟对齐缓冲区
核心思路:申请一块足够大的未对齐原始内存(如普通 char 数组),再在其内部按目标对齐值(如 8、16、32 字节)计算首个满足对齐要求的地址作为“逻辑起始点”。
- 定义一个足够大的 char 缓冲区,例如 char buf[1024];
- 假设需要 16 字节对齐,取当前 buf 地址:uintptr_t base = (uintptr_t)buf
- 计算向上对齐后的地址:uintptr_t aligned_ptr = (base + 15) & ~0xF;(即 (base + align-1) & ~(align-1))
- 该 aligned_ptr 就是第一个可用的 16 字节对齐地址,可安全转为 int16_t*、float* 等指针使用
在数组中顺序管理多个对齐变量
对齐不只是首地址,后续变量也要考虑自身对齐需求及前一变量的结束位置,避免跨不对齐边界。
- 维护一个运行偏移量 size_t offset = 0;
- 每分配一个类型 T,先将 offset 按 alignof(T) 对齐:offset = (offset + alignof(T) - 1) & ~(alignof(T) - 1);
- 记录该变量起始地址:void* addr = buf + offset;
- 更新 offset:offset += sizeof(T);
- 重复上述步骤,即可在单个数组内紧凑、正确地布局 int、double、struct 等不同对齐要求的变量
实战:手写简易内存池结构体
把上述逻辑封装成可复用结构,便于反复分配/重置:
- 定义结构:typedef struct { char data[4096]; size_t used; } align_pool_t;
- 分配函数示例:
void* align_alloc(align_pool_t* p, size_t size, size_t align) {
size_t off = (p->used + align - 1) & ~(align - 1);
if (off + size > sizeof(p->data)) return NULL;
p->used = off + size;
return p->data + off;
}
调用如:int* a = align_alloc(&pool, sizeof(int), alignof(int));
注意事项与边界情况
实际使用中需警惕几个易错点:
- align 必须是 2 的整数次幂,否则位运算对齐公式失效
- 不要对非对齐地址做强制类型转换后解引用——即使编译通过,x86 可能容忍但 ARM/AArch64 会触发对齐异常
- struct 成员自然对齐由编译器保证,但整个 struct 的对齐值是其最大成员对齐值;若需更大对齐(如 cache line),仍需手动填充或使用 _Alignas
- 数组首地址不保证对齐(栈/全局 char 数组通常按最小对齐,如 1 或 8 字节),必须自行计算对齐入口
理论要掌握,实操不能落!以上关于《数组实现内存对齐与变量管理实战解析》的详细介绍,大家都掌握了吧!如果想要继续提升自己的能力,那么就来关注golang学习网公众号吧!
 迅雷下载文件怎么管理_迅雷文件整理方法教程
- 上一篇
- 迅雷下载文件怎么管理_迅雷文件整理方法教程

- 下一篇
- 松鼠AI周报导出方法及打印步骤
查看更多
最新文章
-
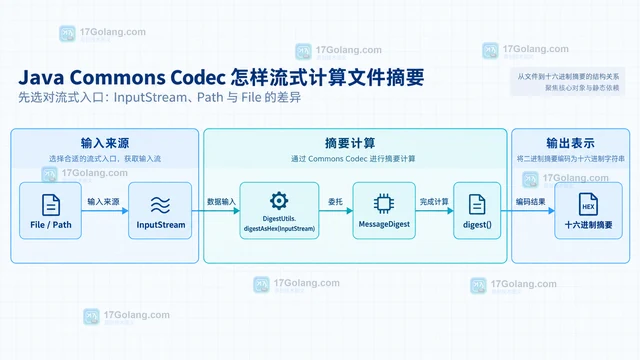
- 文章 · java教程 | 2小时前 | 文件处理 · Java · java InputStream 文件摘要 Apache Commons Codec DigestUtils
- Java Commons Codec怎样流式计算文件摘要
- 370浏览 收藏
-
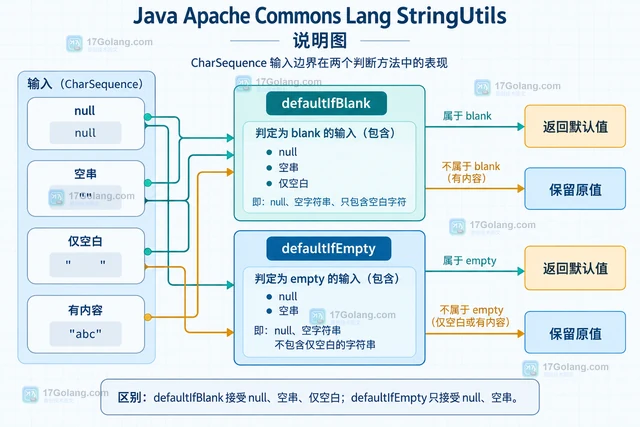
- 文章 · java教程 | 2小时前 | 字符串 · Java · java stringutils defaultIfBlank defaultIfEmpty Apache Commons Lang
- Java StringUtils.defaultIfBlank与defaultIfEmpty有什么区别
- 201浏览 收藏
-
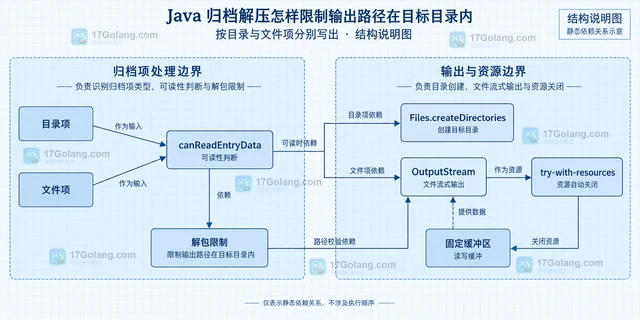
- 文章 · java教程 | 2小时前 | Java · Java教程 · java path 路径安全 Commons Compress 归档解压
- Java归档解压怎样限制输出路径在目标目录内
- 165浏览 收藏
-
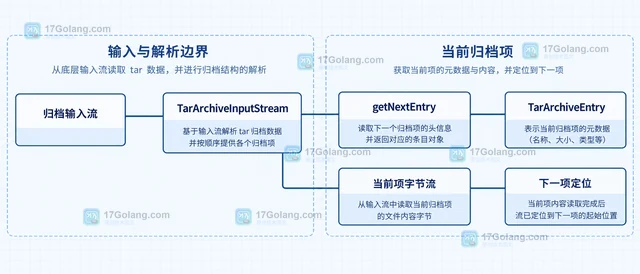
- 文章 · java教程 | 2小时前 | Java · Java教程 · java tar Commons Compress TarArchiveInputStream
- Java Commons Compress怎样逐条读取tar归档项
- 274浏览 收藏
-
- 文章 · java教程 | 3小时前 | java MultiValuedMap Commons Collections 集合视图
- Java MultiValuedMap获取值集合后修改会影响原映射吗
- 205浏览 收藏
-
- 文章 · java教程 | 3小时前 |
- Java MultiValuedMap怎样表达一个键对应多个值
- 497浏览 收藏
-
- 文章 · java教程 | 3小时前 |
- Java Commons CSV空字符串与缺失列怎么区分
- 285浏览 收藏
-
- 文章 · java教程 | 3小时前 | java csv 表头 Commons CSV
- Java Commons CSV怎样按表头名称读取字段
- 127浏览 收藏
-
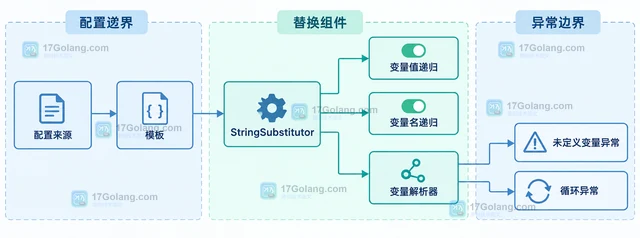
- 文章 · java教程 | 3小时前 | Java · java StringSubstitutor Apache Commons Text 变量循环引用 递归替换
- Java StringSubstitutor遇到变量循环引用怎么处理
- 383浏览 收藏
-
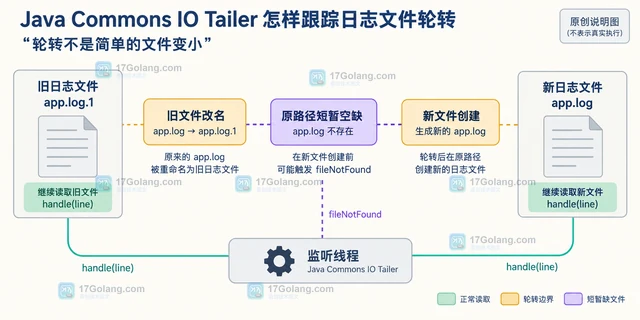
- 文章 · java教程 | 3小时前 | Java · 日志轮转 Tailer Java Commons IO TailerListener Tailer.Builder
- Java Commons IO Tailer怎样跟踪日志文件轮转
- 298浏览 收藏
-
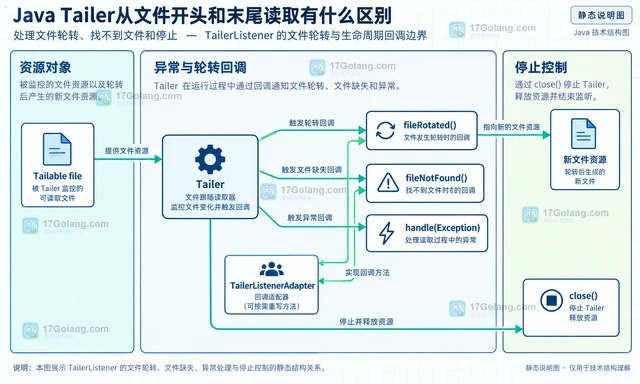
- 文章 · java教程 | 3小时前 | Java · java 日志文件 Tailer Commons IO 文件轮转
- Java Tailer从文件开头和末尾读取有什么区别
- 415浏览 收藏
-
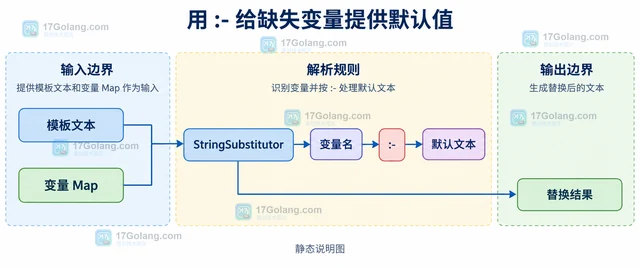
- 文章 · java教程 | 3小时前 |
- Java StringSubstitutor怎样为缺失变量提供默认值
- 304浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 463次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 526次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 544次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 493次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 311次使用
查看更多
相关文章
-
- Java try-with-resources 多个资源关闭顺序是什么
- 2026-09-10 501浏览
-
- 矩阵主副对角线快速定位技巧
- 2026-05-31 501浏览
-
- Java多态优化流程代码与行为分发改进
- 2026-05-26 501浏览
-
- JVM 类元数据双亲委派链表深度解析
- 2026-05-21 501浏览
-
- 反射异常处理:InvocationTargetException解析与应用
- 2026-05-16 501浏览


