
Elasticsearch 如何搜索 # 和 + 等特殊字符
Elasticsearch 默认会过滤掉 #、+ 等特殊字符,导致含符号的文本(如“Java#Spring+Boot”)无法被准确搜索;本文直击痛点,详解两种高效可靠方案:一是零配置启用 `.keyword` 子字段实现毫秒级精确匹配,适合标签、技术栈等完整值检索;二是通过自定义分析器(如 whitespace + lowercase)保留特殊字符参与分词,支持更灵活的含符号子串搜索,同时避坑 wildcard 性能陷阱与大小写敏感问题,兼顾准确性、性能与工程实用性。
Elasticsearch 默认的 standard 分析器会丢弃 #、+ 等非字母数字字符,导致含特殊符号的标题无法被精确匹配;本文详解两种可靠方案:利用 .keyword 子字段进行精确匹配,或自定义分析器保留特殊字符。
Elasticsearch 默认的 standard 分析器会丢弃 `#`、`+` 等非字母数字字符,导致含特殊符号的标题无法被精确匹配;本文详解两种可靠方案:利用 `.keyword` 子字段进行精确匹配,或自定义分析器保留特殊字符。
在使用 Elasticsearch 的 standard 分析器时,像 #(井号)、+(加号)这类字符会被标准分词器(standard tokenizer)直接过滤掉——它依据 Unicode Standard Annex #29 进行分词,仅保留
例如,对文本 "Java#Spring+Boot" 执行分析:
GET _analyze
{
  "analyzer": "standard",
  "text": "Java#Spring+Boot"
}
返回结果中仅包含三个 token:["java", "spring", "boot"],原始的#和+完全丢失。因此,当你尝试搜索title: "Java#Spring"` 时,Elasticsearch 实际查的是已清洗过的词项,自然无法命中原始含符号的文档。
✅ 推荐解决方案一:使用 .keyword 子字段(零配置、最简生效)
Elasticsearch 为 text 类型字段默认生成 .keyword 多字段(multi-field),该子字段使用 keyword 分析器——即不进行任何分词,原样索引整个字符串。你无需修改映射结构(除非显式禁用了 fields),只需在查询时切换到该子字段即可实现精确匹配。
✅ 修改 Java 实体类(启用 .keyword 映射):
@Field(type = FieldType.Text, analyzer = "standard",
       fields = @Field(
           type = FieldType.Keyword,
           name = "keyword"
       ))
private String title;
⚠️ 注意:Spring Data Elasticsearch 4.4+ 默认已为 text 字段自动添加 .keyword 子字段;若未生效,请确认 @Document 的 createIndex 为 true(首次启动时自动创建索引并应用映射)。
? 查询示例(Kibana 或 REST API):
GET jobs/_search
{
  "query": {
    "term": {
      "title.keyword": "DevOps#AWS+CI/CD"
    }
  }
}此方式适用于完整值精确匹配(如搜索带 # 的标签名、技术栈标识符),且性能优异(底层为倒排索引 + 常量时间查找)。
✅ 推荐解决方案二:自定义分析器,保留特殊字符
若需支持部分匹配(如搜索 "#Java" 能匹配 "#Java8" 或 "Learn#Java"),则需构建自定义分析器,让 #、+ 等作为有效 token 的一部分。
? 步骤如下:
定义自定义分析器(推荐使用 pattern tokenizer 拆分空格,配合 lowercase filter):
PUT /jobs { "settings": { "analysis": { "analyzer": { "hashtag_analyzer": { "type": "custom", "tokenizer": "whitespace", "filter": ["lowercase"] } } } }, "mappings": { "properties": { "title": { "type": "text", "analyzer": "hashtag_analyzer", "fields": { "keyword": { "type": "keyword" } } } } } }验证分析效果:
GET jobs/_analyze
{
"analyzer": "hashtag_analyzer",
"text": "Android#Kotlin+Jetpack"
}
输出 token 将为:["android#kotlin+jetpack"](整串保留)或按空格拆分为 ["Android#Kotlin+Jetpack"] —— 取决于是否需要进一步切分。如需识别 # 开头的独立标签,可升级为 pattern tokenizer 配合正则 "[\\s]+" 或更精细规则。
Java 实体同步更新:
@Field(type = FieldType.Text, analyzer = "hashtag_analyzer")
private String title;
⚠️ 注意事项与最佳实践
- 避免滥用 wildcard 或 regexp 查询:虽然 title:*#Java* 看似可行,但性能差、无法利用倒排索引优势,且易引发 too_many_clauses 错误。
- .keyword 不支持全文检索:它只适用于 term、terms、match_phrase(当值完全一致时)等查询,不支持 match 的分词逻辑。
- 索引重建必要性:修改分析器或映射后,已有数据不会自动重索引,需执行 _reindex 或重建索引。
- 大小写敏感性:keyword 字段默认区分大小写;如需忽略大小写,可在其上添加 normalizer,或在自定义分析器中加入 lowercase filter。
综上,对于 #、+ 等特殊字符的搜索,优先采用 .keyword 子字段实现高效精确匹配;若业务要求更灵活的“含符号子串检索”,再引入定制化分析器——二者兼顾准确性、性能与可维护性。
终于介绍完啦!小伙伴们,这篇关于《Elasticsearch 如何搜索 # 和 + 等特殊字符》的介绍应该让你收获多多了吧!欢迎大家收藏或分享给更多需要学习的朋友吧~golang学习网公众号也会发布文章相关知识,快来关注吧!
 PHP Trait 使用教程:代码复用新特性解析
- 上一篇
- PHP Trait 使用教程:代码复用新特性解析
- 下一篇
- 如何用--add-exports绕过模块限制
-
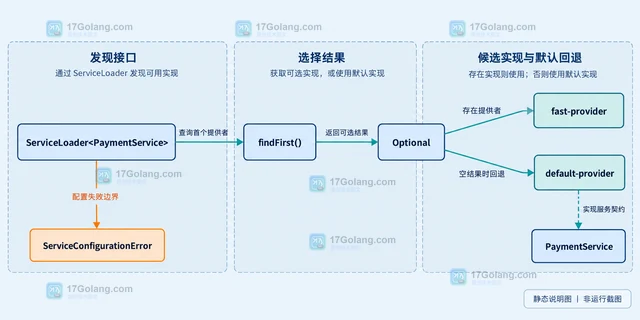
- 文章 · java教程 | 34分钟前 | Java · ServiceLoader module-info.java Java模块
- Java 模块服务加载的可选实现与回退路径
- 363浏览 收藏
-
- 文章 · java教程 | 1小时前 |
- Java VarHandle 内存序选择与可见性验证
- 226浏览 收藏
-
- 文章 · java教程 | 3小时前 |
- Java JFR 事件流定位短时延迟尖峰
- 213浏览 收藏
-
- 文章 · java教程 | 4小时前 |
- Java Record 序列化兼容字段演进方案
- 483浏览 收藏
-
- 文章 · java教程 | 5小时前 |
- Java ServiceLoader 隔离模块化插件实现
- 414浏览 收藏
-
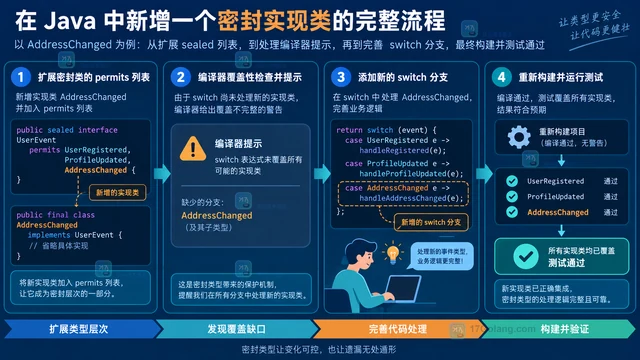
- 文章 · java教程 | 6小时前 |
- Java Pattern Matching switch 处理密封层级
- 189浏览 收藏
-
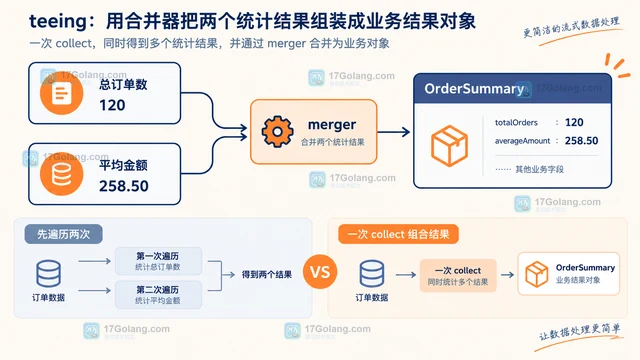
- 文章 · java教程 | 7小时前 | Stream · Java教程 · java Stream Collector Collectors.teeing 统计汇总
- Java Collectors.teeing 汇总两条统计管道
- 385浏览 收藏
-
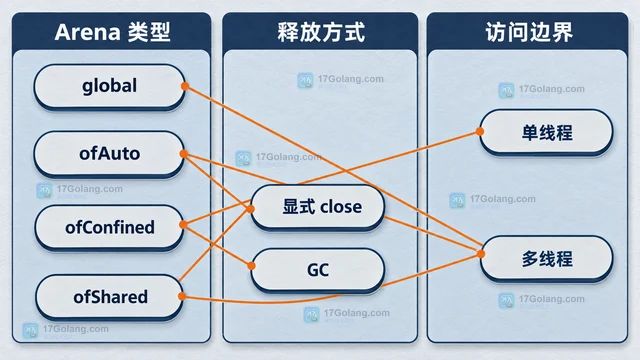
- 文章 · java教程 | 7小时前 |
- Java Foreign Function Memory API 管理本地内存生命周期
- 385浏览 收藏
-
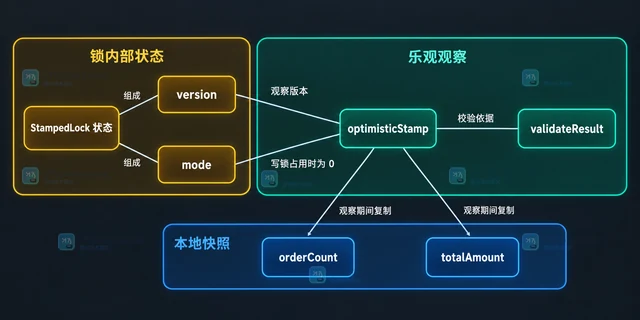
- 文章 · java教程 | 9小时前 |
- Java StampedLock 乐观读校验失败的回退方式
- 165浏览 收藏
-
- 文章 · java教程 | 11小时前 | 异常处理 · 并发编程 · Java教程 · StructuredTaskScope Java Structured Concurrency Joiner allUntil 子任务异常 聚合异常
- Java Structured Concurrency 汇总子任务异常
- 260浏览 收藏
-
- 文章 · java教程 | 14小时前 |
- Java ForkJoinPool asyncMode 调整任务队列顺序
- 121浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 408次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 487次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 494次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 443次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 271次使用
-
- Java try-with-resources 多个资源关闭顺序是什么
- 2026-09-10 501浏览
-
- 矩阵主副对角线快速定位技巧
- 2026-05-31 501浏览
-
- Java多态优化流程代码与行为分发改进
- 2026-05-26 501浏览
-
- JVM 类元数据双亲委派链表深度解析
- 2026-05-21 501浏览
-
- 反射异常处理:InvocationTargetException解析与应用
- 2026-05-16 501浏览


