
如何在 Pandas 的 SQL 查询样式中选择数据子集?
小伙伴们有没有觉得学习数据库很有意思?有意思就对了!今天就给大家带来《如何在 Pandas 的 SQL 查询样式中选择数据子集?》,以下内容将会涉及到,若是在学习中对其中部分知识点有疑问,或许看了本文就能帮到你!
简介
在这篇文章中,我将向您展示如何使用 Pandas 通过 SQL 样式过滤来执行数据分析。大多数企业数据都存储在需要 SQL 来检索和操作的数据库中。例如,像 Oracle、IBM、Microsoft 这样的公司拥有自己的数据库和自己的 SQL 实现。
数据科学家必须在其职业生涯的某个阶段处理 SQL,因为数据并不总是存储在CSV 文件。我个人更喜欢使用 Oracle,因为我公司的大部分数据都存储在 Oracle 中。
场景 – 1 假设我们有一个任务,从我们的电影中查找所有电影具有以下条件的数据集。
- 电影的语言应该是英语(en)或西班牙语(es)。
- 电影的受欢迎程度必须介于 500 到 1000 之间。
- 电影的状态必须已发布。
- 投票数必须大于 5000。对于上述场景,SQL 语句类似于如下。
SELECT
FROM WHERE
title AS movie_title
,original_language AS movie_language
,popularityAS movie_popularity
,statusAS movie_status
,vote_count AS movie_vote_count movies_data
original_languageIN ('en', 'es')

AND status=('Released')
AND popularitybetween 500 AND 1000
AND vote_count > 5000;
现在你已经看到了满足需求的SQL语句,让我们使用pandas一步一步地进行操作。我将向你展示两种方法。
方法1:布尔索引
1. 将movies_data数据集加载到DataFrame中。
import pandas as pd movies = pd.read_csv("https://raw.githubusercontent.com/sasankac/TestDataSet/master/movies_data.csv")为每个条件分配一个变量。
languages = [ "en" , "es" ] condition_on_languages = movies . original_language . isin ( languages )
condition_on_status = movies . status == "Released"
condition_on_popularity = movies . popularity . between ( 500 , 1000 )
condition_on_votecount = movies . vote_count > 5000
3.将所有条件(布尔数组)组合在一起。
final_conditions = ( condition_on_languages & condition_on_status & condition_on_popularity & condition_on_votecount )
columns = [ "title" , "original_language" , "status" , "popularity" , "vote_count" ]
# clubbing all together movies . loc [ final_conditions , columns ]
| 标题 | original_language | 状态 | 受欢迎程度 | vote_count |
|---|---|---|---|---|
| 95星际 | zh | 已发布 | 724.247784 | 10867 |
| 788死侍 | zh | 已发布 | 514.569956 | 10995 |
方法2:- .query()方法。
.query()方法是SQL where子句样式过滤数据的方法。条件可以作为字符串传递给此方法,但是,列名称不得包含任何空格。
如果列名称中有空格,请使用 python 替换函数将其替换为下划线。
根据我的经验,我发现 query() 方法在应用于较大的 DataFrame 时比以前的方法更快。
import pandas as pd movies = pd . read_csv ( "https://raw.githubusercontent.com/sasankac/TestDataSet/master/movies_data.csv" )
4.构建查询字符串并执行该方法。
请注意,.query 方法不适用于跨越多行的三重引号字符串。
final_conditions = (
"original_language in ['en','es']"
"and status == 'Released' "
"and popularity > 500 "
"and popularity < 1000"
"and vote_count > 5000"
) final_result = movies . query ( final_conditions )
final_result
| 预算 | id | original_language | original_title | 受欢迎程度 | 发布日期 | 收入 | 运行时 | st | |
|---|---|---|---|---|---|---|---|---|---|
| 95 | 165000000 | 157336 | zh | 星际 | 724.247784 | 2014年5月11日 | 675120017 | 169.0 | 关系 |
| 788 | 58000000 | 293660zh | 死侍 | 514.569956 p> | 2016年9月2日 | 783112979 | 108.0 | 关系 |
您还可以以编程方式将值创建为 Python 列表,并将它们与 (@) 一起使用。
movie_languages = [ 'en' , 'es' ]
final_conditions = (
"original_language in @movie_languages "
"and status == 'Released' "
"and popularity > 500 "
"and popularity < 1000"
"and vote_count > 5000" )
final_result = movies . query ( final_conditions )
final_result
| 预算 | id | original_language | original_title | 受欢迎程度 | 发布日期 | 收入 | 运行时 | st | |
|---|---|---|---|---|---|---|---|---|---|
| 95 | 165000000 | 157336 | zh | 星际 | 724.247784 | 2014年5月11日 | 675120017 | 169.0 | 关系 |
| 788 | 58000000 | 293660zh | 死侍 | 514.569956 p> | 2016年9月2日 | 783112979 | 108.0 | 关系 |
今天关于《如何在 Pandas 的 SQL 查询样式中选择数据子集?》的内容介绍就到此结束,如果有什么疑问或者建议,可以在golang学习网公众号下多多回复交流;文中若有不正之处,也希望回复留言以告知!
 MySQL标准合规性
- 上一篇
- MySQL标准合规性

- 下一篇
- MySQL bin 目录位于 Windows 操作系统中的哪里?
-
- 数据库 · MySQL | 2天前 |
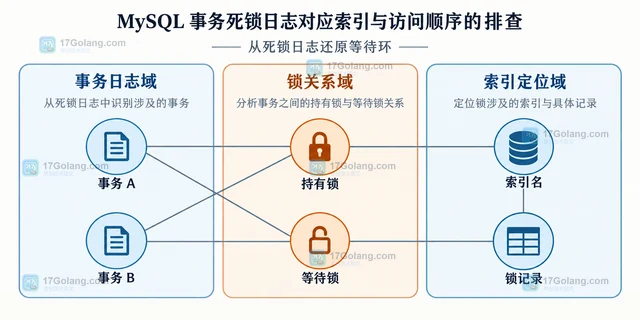
- MySQL 事务死锁日志对应索引与访问顺序的排查
- 401浏览 收藏
-
- 数据库 · MySQL | 2天前 | 执行计划 · MySQL教程 · mysql 执行计划 索引优化 访问路径 EXPLAIN FORMAT=JSON
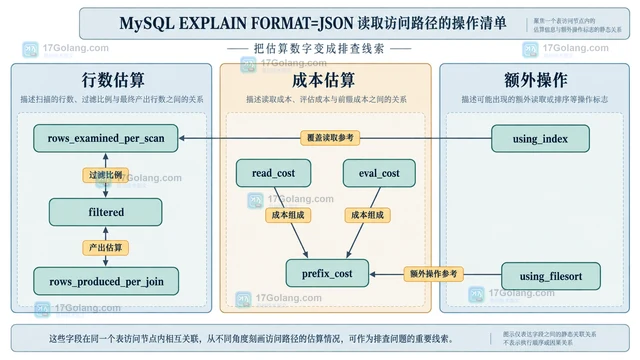
- MySQL EXPLAIN FORMAT=JSON 读取访问路径的操作清单
- 243浏览 收藏
-
- 数据库 · MySQL | 2天前 |
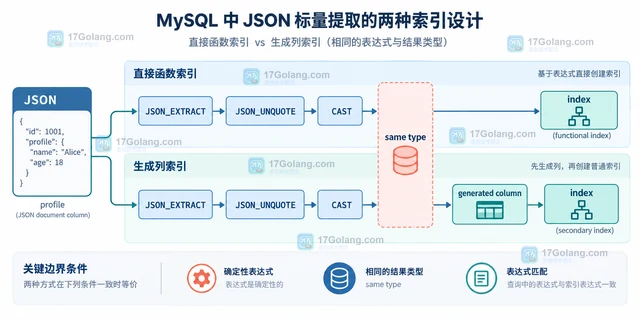
- MySQL 函数索引提取表达式结果的设计方法
- 228浏览 收藏
-
- 数据库 · MySQL | 2天前 |
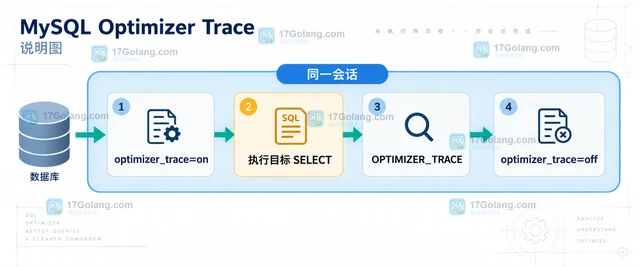
- MySQL Optimizer Trace 怎么查看索引选择原因
- 500浏览 收藏
-
- 数据库 · MySQL | 3天前 |
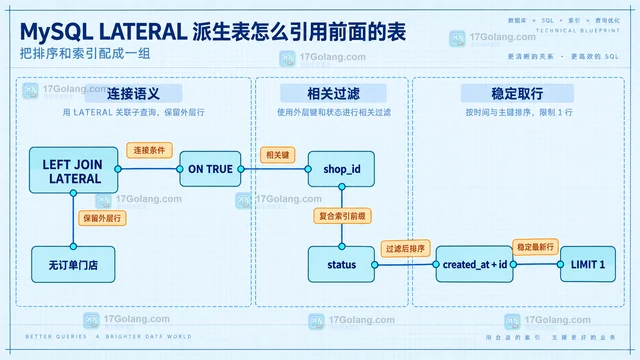
- MySQL LATERAL 派生表怎么引用前面的表
- 252浏览 收藏
-
- 数据库 · MySQL | 3天前 |
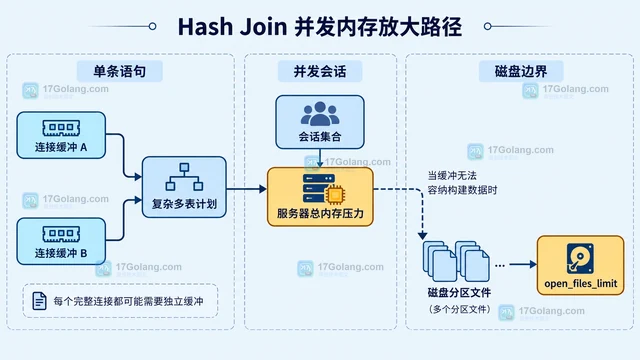
- MySQL Hash Join 什么时候会消耗大量内存
- 488浏览 收藏
-
- 数据库 · MySQL | 3天前 |
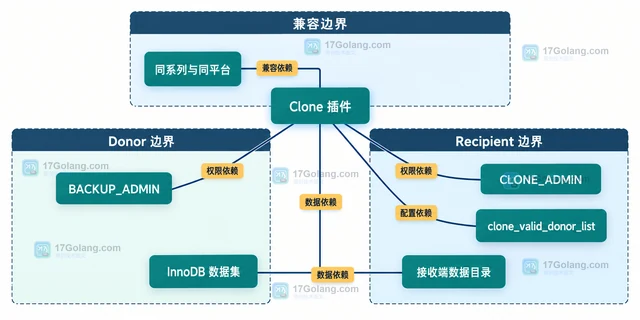
- MySQL Clone 插件怎么为副本准备一致数据
- 184浏览 收藏
-
- 数据库 · MySQL | 3天前 |
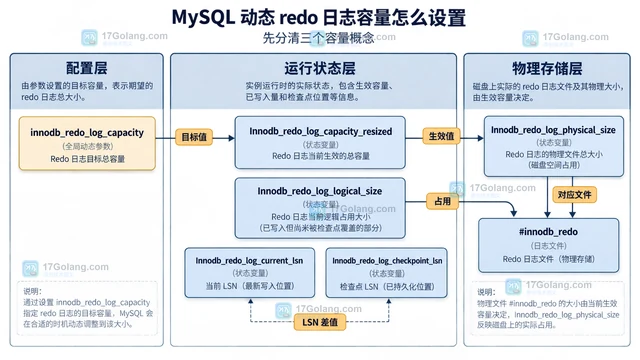
- MySQL 动态 redo 日志容量怎么设置
- 153浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 286次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 339次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 337次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 303次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 125次使用
-
- MySQL JSON_TABLE 展开数组时如何保留缺失字段
- 2026-09-10 501浏览
-
- MySQL 分区表怎么处理跨分区唯一键:分区列约束与建表取舍
- 2026-08-30 501浏览
-
- MySQL权限管理设置全攻略
- 2026-03-29 501浏览
-
- MySQL分片实现方法及常见方案解析
- 2025-06-24 501浏览
-
- MySQL表空间碎片怎么清理?超详细优化教程
- 2025-06-13 501浏览