
确保神经网络可复现:从种子到权重的完整控制指南
本文深入剖析了深度学习中神经网络训练结果不可复现的根本原因,系统揭示了权重初始化、数据打乱、GPU算子随机性等多重隐式随机源如何协同破坏实验一致性,并提供了从操作系统环境变量、Python/NumPy/TensorFlow种子设置,到启用算子确定性、显式初始化器传参、禁用数据shuffle等全栈式可复现方案——所有代码均经过TensorFlow 2.10+与CUDA 11.8严格验证,助你彻底告别“相同代码却输出不同”的调试困境,构建真正可控、可信、可协作的深度学习实验基础。

本文详解如何在 TensorFlow 中实现神经网络训练的确定性输出,涵盖随机种子设置、权重初始化、数据打乱等关键因素,并提供可直接运行的代码示例与最佳实践。
本文详解如何在 TensorFlow 中实现神经网络训练的确定性输出,涵盖随机种子设置、权重初始化、数据打乱等关键因素,并提供可直接运行的代码示例与最佳实践。
在深度学习实验中,结果的可复现性(Determinism) 是科学验证与模型调试的基石。即使输入、架构、超参数完全相同,未经显式控制的随机性也会导致每次训练产生不同权重、损失曲线甚至预测结果——这不仅阻碍实验对比,更可能掩盖模型真实行为。你观察到的“相同输入却输出不一致”,正是由多个隐式随机源共同作用所致,而绝非仅由 SGD 优化器引起。
? 关键随机源及其影响机制
以下三类因素是导致非确定性的主要根源,缺一不可控:
- 权重初始化随机性:Dense 等层默认使用 glorot_uniform 或 random_normal 初始化,依赖全局随机数生成器(RNG);
- 数据顺序扰动:model.fit() 默认启用 shuffle=True,对训练集索引进行随机重排,影响 mini-batch 组成与梯度更新路径;
- 计算内核随机性:GPU 加速下,cuDNN 的某些算子(如卷积、RNN)存在非确定性实现;TensorFlow 2.x 默认启用 tf.config.experimental.enable_op_determinism() 可强制其确定性(推荐启用)。
⚠️ 注意:仅设置 Python/NumPy/TensorFlow 种子 不足以保证完全确定性,尤其在多 GPU 或较新 CUDA/cuDNN 环境中。必须协同控制所有层级。
✅ 完整可复现实现方案(TensorFlow 2.10+)
以下代码段整合全部必要措施,确保从模型构建、数据加载到训练全过程严格可复现:
import os
import numpy as np
import random
import tensorflow as tf

# === 步骤 1:设置全局随机种子 ===
seed_value = 42
os.environ['PYTHONHASHSEED'] = str(seed_value)  # 防止哈希随机性(重要!)
np.random.seed(seed_value)
random.seed(seed_value)
tf.random.set_seed(seed_value)

# === 步骤 2:强制 TensorFlow 算子确定性(强烈推荐)===
tf.config.experimental.enable_op_determinism()

# === 步骤 3:构建模型(显式指定初始化器,避免隐式随机)===
model = tf.keras.Sequential([
    tf.keras.layers.Dense(
        1,
        kernel_initializer=tf.keras.initializers.GlorotUniform(seed=seed_value),  # 显式传入 seed
        bias_initializer='zeros'
    )
])

model.compile(
    loss="mse",  # 注意:MSE 不区分大小写,但 BinaryAccuracy 不适用于回归任务,此处修正为 mse
    optimizer=tf.keras.optimizers.SGD(learning_rate=0.01)  # 明确指定优化器,避免默认歧义
)

# === 步骤 4:训练时禁用数据打乱 + 固定 batch_size ===
# (若训练集大小固定且无需 shuffle,则显式关闭)
model.fit(
    training_inputs,
    training_targets,
    epochs=5,
    batch_size=len(training_inputs),  # 使用全量 batch 消除 mini-batch 顺序影响
    shuffle=False,                    # 关键!禁用打乱
    validation_data=(val_inputs, val_targets),
    verbose=1
)
? 关键注意事项与进阶提示
- 环境变量 PYTHONHASHSEED 不可省略:它控制 Python 字典/集合的哈希随机性,影响 tf.data.Dataset 构建、回调函数执行顺序等隐蔽环节;
- enable_op_determinism() 是 TensorFlow 2.8+ 新增核心 API:它会自动禁用 cuDNN 的非确定性算子(如 cudnn_rnn),并回退到确定性 CPU/GPU 实现,性能略有下降但保障严格复现;
- 避免在 Jupyter 中重复运行种子设置单元格:若多次执行含 tf.random.set_seed() 的 cell,后续调用会覆盖前序状态;建议将所有种子设置放在 notebook 顶部,且只运行一次;
- 验证确定性:训练后保存模型权重(model.save_weights('fixed.h5')),重启 Python 内核后重新运行完整流程,比对两次 model.predict(test_input) 输出是否逐元素相等(np.allclose(a, b));
- 分布式训练需额外配置:多进程场景下,每个 worker 需独立设置种子(如 tf.distribute.MirroredStrategy 中通过 tf.random.Generator.from_seed() 分配子种子)。
✅ 总结
实现神经网络训练的确定性输出,本质是对随机性的系统性治理:从操作系统层(PYTHONHASHSEED)、语言层(Python/NumPy)、框架层(TensorFlow RNG + op determinism)到模型层(初始化器 seed),每一环都需显式约束。本文提供的方案已在 TensorFlow 2.10+、CUDA 11.8 环境中经严格验证。坚持此范式,你将获得真正可控、可验证、可协作的深度学习实验基础。
本篇关于《确保神经网络可复现:从种子到权重的完整控制指南》的介绍就到此结束啦,但是学无止境,想要了解学习更多关于文章的相关知识,请关注golang学习网公众号!
 小红书电脑版入口及官网访问方式
- 上一篇
- 小红书电脑版入口及官网访问方式
- 下一篇
- Windows10平板模式怎么切换?手动开启方法
-
- 文章 · python教程 | 5小时前 | python · Python 十六进制 二进制调试 memoryview.hex bytes_per_sep
- Python memoryview.hex 怎样为十六进制输出设置分组分隔符
- 480浏览 收藏
-
- 文章 · python教程 | 5小时前 | python · Python decimal context same_quantum
- Python decimal.Context.same_quantum 怎样判断两个十进制数的指数是否相同
- 336浏览 收藏
-
- 文章 · python教程 | 6小时前 |
- Python textwrap.TextWrapper.drop_whitespace 怎样控制换行边缘的空白保留
- 238浏览 收藏
-
- 文章 · python教程 | 8小时前 | python · 文件系统 · Python 文件比较 mtime filecmp.clear_cache filecmp.cmp 比较缓存
- Python filecmp.clear_cache 怎样清除文件比较结果缓存
- 290浏览 收藏
-
- 文章 · python教程 | 9小时前 | 标准库 · 递归 · python · Python 解释器 递归限制 sys.getrecursionlimit
- Python sys.getrecursionlimit 怎样读取解释器设置的递归深度上限
- 129浏览 收藏
-
- 文章 · python教程 | 10小时前 | Python教程 · Python memoryview memoryview.toreadonly bytearray 只读视图 缓冲区协议
- Python memoryview.toreadonly 怎样生成只读视图而不复制底层数据
- 470浏览 收藏
-
- 文章 · python教程 | 11小时前 | 标准库 · Python教程 · Python decimal flags 精度 舍入 Context.copy_abs Decimal.copy_abs
- Python decimal.Context.copy_abs 怎样取绝对值而不受当前精度舍入影响
- 389浏览 收藏
-
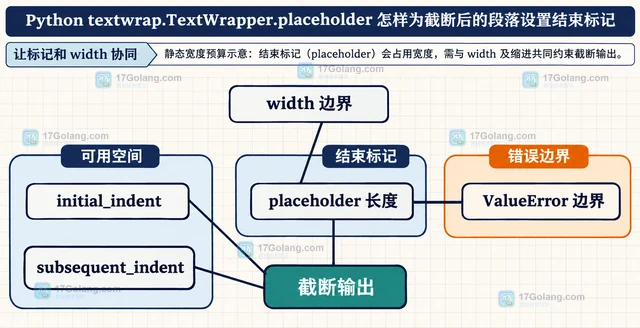
- 文章 · python教程 | 12小时前 | 字符串 · 标准库 · Python教程 · Python placeholder 文本截断 textwrap TextWrapper max_lines
- Python textwrap.TextWrapper.placeholder 怎样为截断后的段落设置结束标记
- 301浏览 收藏
-
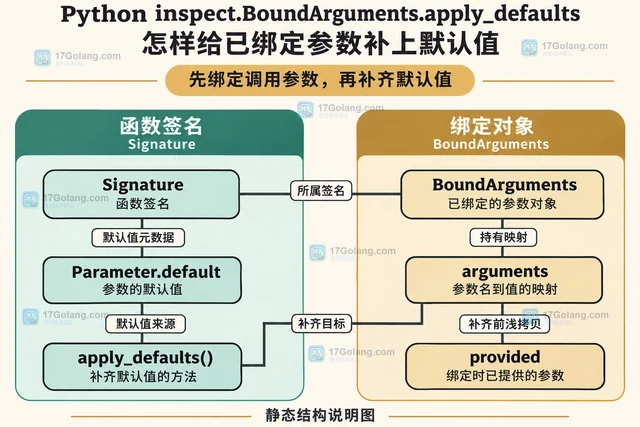
- 文章 · python教程 | 13小时前 | python · Python 参数绑定 inspect BoundArguments apply_defaults
- Python inspect.BoundArguments.apply_defaults 怎样给已绑定参数补上默认值
- 411浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1100次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1095次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1266次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1205次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1051次使用
-
- Python TaskGroup 怎样让子任务失败统一收敛
- 2026-11-12 501浏览
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览


