
Golang切片预分配技巧分享
在Go语言开发中,合理预分配切片容量(使用 `make([]T, 0, cap)` 而非 `make([]T, cap)`)是提升性能、减少内存浪费与GC压力的关键实践:它避免冗余初始化、彻底消除不必要的扩容拷贝,并显著优化高频append场景;结合行数估算、协议字段预判、sync.Pool复用及安全清空策略,能兼顾效率与内存安全——真正高效的Go代码,往往始于写下一行为`append`之前,那一次对数据规模的冷静预判。

预分配容量用 make([]T, 0, cap),不是 make([]T, cap)
预分配切片容量的核心动作,就是让底层数组一次到位,后续 append 不触发 realloc。但很多人写成 make([]int, 1000),这其实分配了 1000 个已初始化的元素——你只打算存 500 个?那白占一半内存;更糟的是,它还可能掩盖扩容问题:因为 len == cap,第一次 append 就得扩容。
正确姿势是:make([]int, 0, 1000)。它只申请底层数组(1000 个 int 空间),len = 0,cap = 1000,所有 append 都复用这块内存,直到第 1001 次才扩容。
make([]byte, 0, 4096)常用于读 buffer,比make([]byte, 4096)少一次初始化开销,也避免未用空间长期驻留- 处理 JSON 数组字段时,可用
json.RawMessage先解析长度,再按字段数预分配目标切片 - 从文件逐行读取?先用
strings.Count(content, "\n") + 1估算行数,再make([]string, 0, lineCount)
预估不准时,宁可略大,别吝啬那点内存
扩容代价远高于“多分一点”。Go 的扩容策略是:小于 1024 时翻倍,超过后每次只加 25%。这意味着从空切片追加 10 万个 int,会经历约 17 次 malloc + copy;而 make([]int, 0, 100000) 是零扩容。
但别走极端——预设 cap = 110241024 却只存 3 条数据,就是纯浪费。合理做法是:
- 有明确上限(如协议头固定 16 字段)→ 直接设
cap = 16 - 常见规模在 10–200 之间 → 用
cap = 256,覆盖 99% 场景,成本可控 - 完全未知但高频调用(如日志拼接)→ 放进
sync.Pool,按 size 分池(smallBufPool/largeBufPool),不混用
复用切片别只靠 s = s[:0],小心“假清空”
s = s[:0] 确实快,但它只是把长度归零,底层数组还挂着。如果这个切片含指针字段(比如 []*User),旧指针不清理,GC 就不敢回收对应对象——表面空了,内存却卡死。
安全复用要分情况:
- 纯值类型(
[]int,[]byte)→s = s[:0]足够,无需额外操作 - 含指针或 map/slice 字段的结构体切片 → 必须遍历置零:
for i := range s { s[i] = MyStruct{} } - 跨 goroutine 或长生命周期复用 → 优先走
sync.Pool,并确保Put前已Reset(如bytes.Buffer.Reset())
别在循环里无脑 append 到空切片
这是最典型的性能陷阱。现象是:pprof 显示大量 runtime.makeslice 和 runtime.growslice,GC 频次飙升,程序越跑越慢。
错误写法:
var result []string
for _, item := range items {
    result = append(result, process(item))
}
改进关键不在“怎么 append”,而在“怎么初始化”。只要能估算总量(哪怕粗略),就该提前算好:
- 已知
len(items) == N→result := make([]string, 0, N) - 每个
item可能产出 0–3 个字符串 → 按N * 3预估,比默认策略省至少 5 次扩容 - 实在无法估算 → 改用索引赋值:
result := make([]string, len(items)); for i := range items { result[i] = process(items[i]) },彻底绕过append逻辑
真正难的不是记住语法,而是每次写 append 前,下意识问一句:我到底知道要塞多少个?
文中关于的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《Golang切片预分配技巧分享》文章吧,也可关注golang学习网公众号了解相关技术文章。
 饿了么早餐券怎么领及入口位置
- 上一篇
- 饿了么早餐券怎么领及入口位置

- 下一篇
- 双11营销脚本怎么写?文心一言阶梯抢购文案教程
-
- Golang · Go教程 | 5小时前 | 命令行 · go · 工程实践 · go generate Go代码生成 go generate -run 生成指令筛选
- go generate -run 怎样只执行指定生成指令
- 453浏览 收藏
-
- Golang · Go教程 | 5小时前 | go · go test -json TestEvent Go测试事件 BuildEvent FailedBuild
- go test -json 输出怎样区分测试事件和构建事件
- 173浏览 收藏
-
- Golang · Go教程 | 6小时前 | 基准测试 · testing · 性能 · Go教程 · GOMAXPROCS RunParallel Go testing.B.SetParallelism 并行基准 IO吞吐
- Go testing.B.SetParallelism 提高 IO 型并行基准吞吐的配置方法
- 404浏览 收藏
-
- Golang · Go教程 | 6小时前 |
- Go testing.T.Cleanup 多次注册时为什么按逆序执行
- 309浏览 收藏
-
- Golang · Go教程 | 6小时前 |
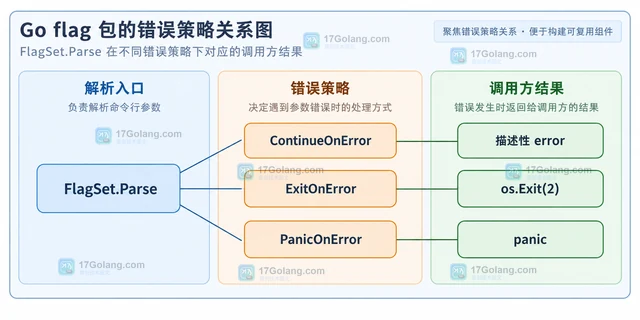
- Go flag.FlagSet 怎样让参数错误返回给调用方
- 273浏览 收藏
-
- Golang · Go教程 | 6小时前 | flag · go ·
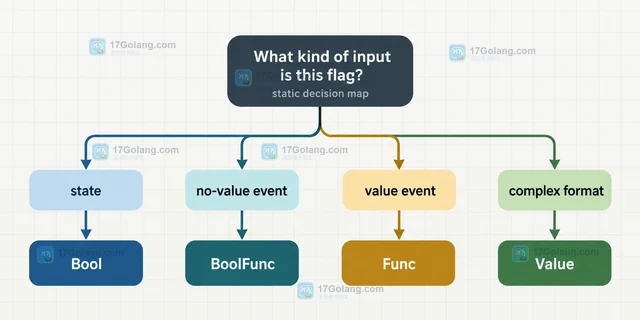
- Go flag.BoolFunc 怎样处理重复出现的布尔开关
- 246浏览 收藏
-
- Golang · Go教程 | 6小时前 | 反射 · Go教程 · database/sql · Go database/sql Rows.Scan ColumnType ScanType 动态查询导出
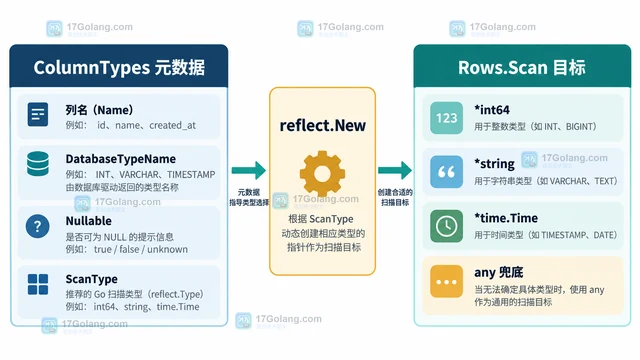
- Go database/sql ColumnType.ScanType 怎样支持动态查询导出
- 381浏览 收藏
-
- Golang · Go教程 | 6小时前 | flag · go · Go flag.TextVar encoding.TextUnmarshaler
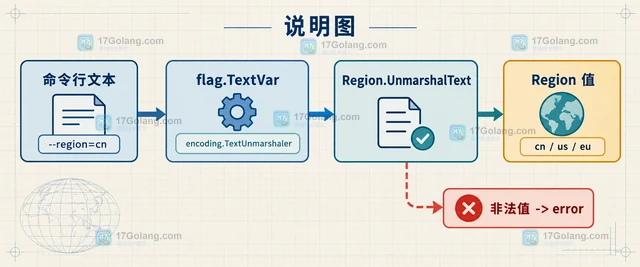
- Go flag.TextVar 怎样复用类型的文本解析逻辑
- 479浏览 收藏
-
- Golang · Go教程 | 6小时前 | go · []byte · database/sql ·
- Go database/sql Scan 得到的 []byte 为什么不能直接长期保存
- 343浏览 收藏
-
- Golang · Go教程 | 6小时前 | 数据库 · Go教程 · database/sql · Go database/sql rows NextResultSet SQL结果集
- Go database/sql 怎样依次读取多个 SQL 结果集
- 456浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 451次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 520次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 536次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 481次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 304次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览


