
Java如何实现文本统计\_字符串处理项目详解
本文深入解析了Java中文本统计与字符串处理的核心实践,涵盖字符频次统计(推荐HashMap+toCharArray高效遍历,兼顾大小写与空白符处理)、单词频次统计(强调标点清洗与健壮分割策略)、大文件安全读取(优先使用Files.lines()防OOM,严格处理编码、路径和异常),以及结果的有序输出与格式化对齐技巧;同时直击开发者常见陷阱——如字符/字符串类型误用、低效查值、乱码、零宽字符干扰等,并提供可立即验证的调试方法(如codePoints打印),是一份兼具原理深度与工程落地性的实用指南。

统计字符串中每个字符出现次数
直接用 HashMap 遍历字符是最稳妥的方式,避免用 String.charAt() 配合 String.indexOf() 这类低效组合。注意区分大小写和空白符——如果需求是“忽略大小写”,得先调用 toLowerCase();如果要跳过空格、换行等,需显式判断 Character.isWhitespace(c)。
常见错误是把 char 当作 String 传给 put(),导致编译失败;或在循环里反复调用 map.get(c) == null 而不是用 getOrDefault(c, 0),多一次哈希查找。
Mapcount = new HashMap(); for (char c : text.toCharArray()) { if (Character.isWhitespace(c)) continue; count.put(c, count.getOrDefault(c, 0) + 1); }
按单词统计频次(不依赖正则)
用 String.split("\\s+") 简单但有隐患:它无法处理标点粘连,比如 "hello,world" 会被当做一个词。更健壮的做法是用 StreamTokenizer 或手动扫描——但对简单项目,先用 replaceAll("[^a-zA-Z0-9\\s]", " ") 清洗再分割更直观。
注意 split(" ") 和 split("\\s+") 的区别:前者只切空格,后者切所有空白符(包括制表、换行),且能自动合并连续空白;空字符串过滤必须加 .filter(s -> !s.isEmpty()),否则数组头尾可能有空项。
String cleaned = text.replaceAll("[^a-zA-Z0-9\\s]", " ");
String[] words = cleaned.split("\\s+");
Map wordCount = new HashMap();
for (String w : words) {
    if (!w.isEmpty()) {
        wordCount.put(w.toLowerCase(), wordCount.getOrDefault(w.toLowerCase(), 0) + 1);
    }
}
读取文件并统计时的编码与异常处理
用 Files.readAllLines(path, StandardCharsets.UTF_8) 比 FileReader 更安全,后者默认用系统编码,中文 Windows 下容易乱码。必须捕获 IOException,不能只写 throws 丢给上层——命令行工具没人接这个异常。
大文件别用 readAllLines(),会 OOM;改用 Files.lines(path) 返回 Stream,配合 try-with-resources 自动关闭。另外,路径含空格或中文时,确保传入的是 Path 对象而非裸字符串,避免 java.nio.file.InvalidPathException。
Paths.get("data.txt")比new File("data.txt").toPath()更推荐- 统计前检查文件是否存在:
Files.exists(path),避免 FileNotFoundException - 空文件要单独处理,
lines.count()为 0 时别直接进统计逻辑
输出结果时保留排序与格式对齐
Java 默认 HashMap 不保证顺序,想按频次降序输出得转成 LinkedHashMap 或用 stream().sorted()。别用 Collections.sort(list) 手动排序 list 再遍历 map——效率低还容易索引错位。
控制台对齐靠 String.format("%-15s %d", word, count),其中 %-15s 表示左对齐、占15字符宽;数字用 %6d 右对齐更清晰。如果导出 CSV,记得对字段中的逗号、换行做转义,否则 Excel 打开会错列。
wordCount.entrySet().stream()
    .sorted(Map.Entry.comparingByValue().reversed())
    .limit(10)
    .forEach(e -> System.out.println(String.format("%-20s %6d", e.getKey(), e.getValue())));
实际跑起来最常卡在文件编码和标点清洗这两步,尤其是测试用的文本从网页复制过来,藏着零宽空格或软连字符,length() 看着正常,split() 却分不出词。先用 text.codePoints().forEach(System.out::println) 打印码点,比猜快得多。今天关于《Java如何实现文本统计\_字符串处理项目详解》的内容介绍就到此结束,如果有什么疑问或者建议,可以在golang学习网公众号下多多回复交流;文中若有不正之处,也希望回复留言以告知!
 中国邮政速递查询入口 11183快递查询方法
- 上一篇
- 中国邮政速递查询入口 11183快递查询方法

- 下一篇
- 宝塔SSL配置与HSTS开启教程
-
- 文章 · java教程 | 1天前 | Java · ServiceLoader module-info.java Java模块
- Java 模块服务加载的可选实现与回退路径
- 363浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java VarHandle 内存序选择与可见性验证
- 226浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java JFR 事件流定位短时延迟尖峰
- 213浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java Record 序列化兼容字段演进方案
- 483浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java ServiceLoader 隔离模块化插件实现
- 414浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java Pattern Matching switch 处理密封层级
- 189浏览 收藏
-
- 文章 · java教程 | 1天前 | Stream · Java教程 · java Stream Collector Collectors.teeing 统计汇总
- Java Collectors.teeing 汇总两条统计管道
- 385浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java Foreign Function Memory API 管理本地内存生命周期
- 385浏览 收藏
-
- 文章 · java教程 | 1天前 |
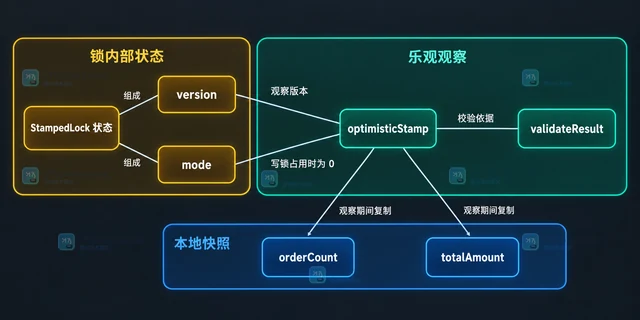
- Java StampedLock 乐观读校验失败的回退方式
- 165浏览 收藏
-
- 文章 · java教程 | 1天前 | 异常处理 · 并发编程 · Java教程 · StructuredTaskScope Java Structured Concurrency Joiner allUntil 子任务异常 聚合异常
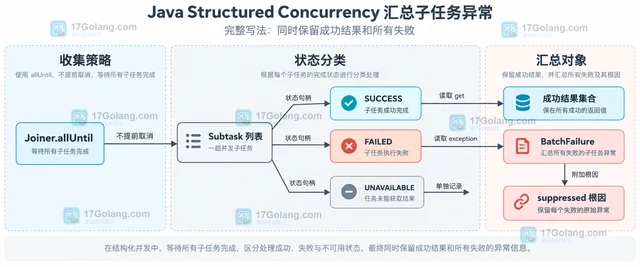
- Java Structured Concurrency 汇总子任务异常
- 260浏览 收藏
-
- 文章 · java教程 | 1天前 |
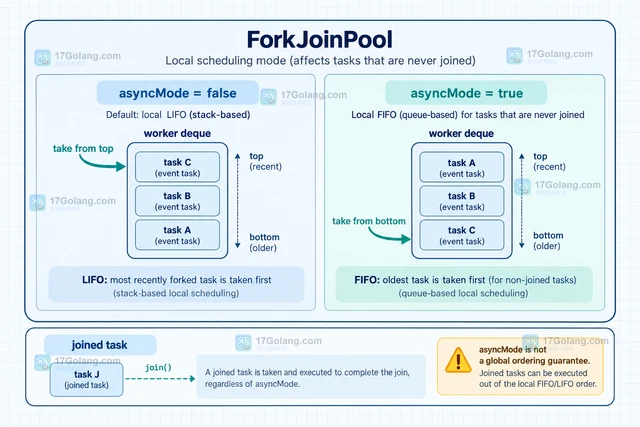
- Java ForkJoinPool asyncMode 调整任务队列顺序
- 121浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 425次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 505次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 516次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 460次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 289次使用
-
- Java try-with-resources 多个资源关闭顺序是什么
- 2026-09-10 501浏览
-
- 矩阵主副对角线快速定位技巧
- 2026-05-31 501浏览
-
- Java多态优化流程代码与行为分发改进
- 2026-05-26 501浏览
-
- JVM 类元数据双亲委派链表深度解析
- 2026-05-21 501浏览
-
- 反射异常处理:InvocationTargetException解析与应用
- 2026-05-16 501浏览


