
Python如何用sample_weight调整类别不平衡损失
本文深入解析了在机器学习中如何正确、安全地使用样本权重(sample_weight)应对类别不平衡问题,覆盖sklearn、LightGBM/XGBoost和PyTorch三大主流框架:sklearn分类器原生支持fit()直接传入sample_weight,无需改动模型或损失函数,但需警惕与class_weight混用导致的重复加权;LightGBM/XGBoost统一通过sample_weight参数控制(注意DMatrix底层weight字段差异),避免手动构造时权重叠加;PyTorch则必须在loss层面显式实现per-sample加权,常用reduction='none'配合手动加权求均值,并严格校验张量形状与设备一致性;尤为关键的是,无论采用何种方式,验证与测试阶段必须禁用样本权重,否则评估结果严重失真——真正的挑战不在于技术实现,而在于依据验证集指标(如PR曲线、混淆矩阵)科学设计权重策略,平衡拟合能力与泛化性能。
sklearn.fit() 传 sample_weight 就行,别碰模型内部
绝大多数场景下,你不需要改损失函数或重写训练逻辑——sklearn 系列分类器(如 LogisticRegression、RandomForestClassifier、SVC)原生支持 sample_weight 参数,直接在 fit() 时传入即可生效。
常见错误是试图手动修改 class_weight='balanced' 后再叠加 sample_weight,结果权重被重复缩放;或者误以为必须用 class_weight 才能处理不平衡,其实 sample_weight 更灵活、更可控。
sample_weight是长度为n_samples的数组,每个样本一个浮点数权重,越大表示该样本在损失计算中越“重要”- 类别不平衡时,通常按
n_samples / (n_classes * n_samples_in_class)给每类样本统一分配权重(即class_weight='balanced'的底层逻辑),但你可以自定义:比如给少数类样本乘以 2.5,多数类保持 1.0 - 注意:传
sample_weight后,predict_proba()和decision_function()输出不受影响,但score()默认用加权准确率(除非显式指定scoring)
LightGBM/XGBoost 用 sample_weight 参数,不是 weight 或 weights
这两个库命名不统一,容易传错参数名。LightGBM 的 train() 和 LGBMClassifier.fit() 都认 sample_weight;XGBoost 的 fit() 也叫 sample_weight,但它的底层 train() API 叫 weight——如果你手拼 DMatrix,就得用 weight 字段,而不是传参。
典型翻车点:把 Pandas DataFrame 直接喂给 XGBoost 的 fit(),同时又手动构造了 DMatrix 并设了 weight,导致权重被应用两次。
- 用 sklearn 接口(
LGBMClassifier/XGBClassifier)就统一走sample_weight=...,别碰DMatrix - 如果必须用原生 API:LightGBM 的
lgb.Dataset用weight=...参数;XGBoost 的xgb.DMatrix构造时传weight=...,且确保该数组和数据行对齐(长度一致、顺序一致) - 权重值本身不做归一化,但极端值(比如某样本权重是其他样本的 1000 倍)会导致梯度爆炸,训练不稳定——建议先做 min-max 或 z-score 缩放
PyTorch 没有全局 sample_weight,得进 loss 函数里加
PyTorch 不像 sklearn 那样在 fit() 层抽象出权重接口,你得自己把权重塞进 loss 计算。最常用的是 nn.CrossEntropyLoss(weight=...),但它只支持 per-class 权重,不是 per-sample。
要实现真正的 per-sample 动态权重(比如根据预测置信度、样本难度实时调整),必须用 reduction='none' + 手动加权求均值。
nn.CrossEntropyLoss(reduction='none')返回 shape 为(N,)的 loss 张量,每一项对应一个样本;再用sample_weight数组(Tensor)逐元素相乘,最后.mean()- 确保
sample_weight是 float 类型、设备一致(.to(device))、形状匹配((N,)),否则报RuntimeError: The size of tensor a (128) must match the size of tensor b (64) - 别在
forward()里加权重——那是模型结构;权重属于训练逻辑,必须出现在 loss 计算环节
权重不是万能的,过拟合少数类和评估失真最常被忽略
加了 sample_weight 后,训练 loss 看着降了,但验证集上的 f1-score 或 auc 可能反而变差——因为模型开始死磕那些高权重样本,泛化能力崩了。
另一个隐形坑:用加权后的训练集去算 validation score,会误导你认为模型变好了,其实只是指标被权重带偏了。验证/测试阶段永远该用 unweighted 指标,除非业务明确要求加权评估。
- 训练时用
sample_weight,验证时禁用(即传sample_weight=None或不传) - 如果用
class_weight='balanced',它基于训练集统计,换数据分布后权重就失效了;动态sample_weight虽灵活,但每次都要重新设计规则(比如按预测误差加权,就得跑两轮训练) - 真正难的不是“怎么加”,而是“加多少”——没有银弹公式,得靠验证集上的
precision-recall curve或confusion matrix反复试
理论要掌握,实操不能落!以上关于《Python如何用sample_weight调整类别不平衡损失》的详细介绍,大家都掌握了吧!如果想要继续提升自己的能力,那么就来关注golang学习网公众号吧!
 手机登录QQ邮箱步骤及网页入口
- 上一篇
- 手机登录QQ邮箱步骤及网页入口
- 下一篇
- 微信网页版入口及消息发送教程
-
- 文章 · python教程 | 8小时前 |
- Python contextvars Token 怎样撤销临时上下文修改
- 353浏览 收藏
-
- 文章 · python教程 | 8小时前 |
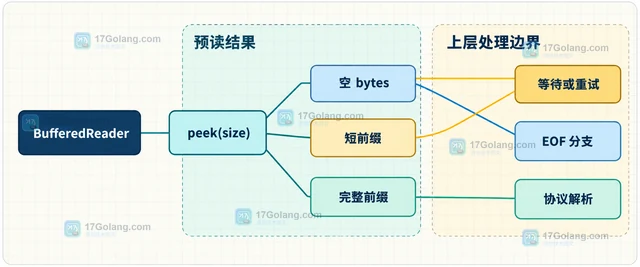
- Python io.BufferedReader.peek 怎样预读字节
- 356浏览 收藏
-
- 文章 · python教程 | 8小时前 | 面向对象 · Python教程 · 字段默认值 slots Python dataclasses 继承字段 weakref_slot
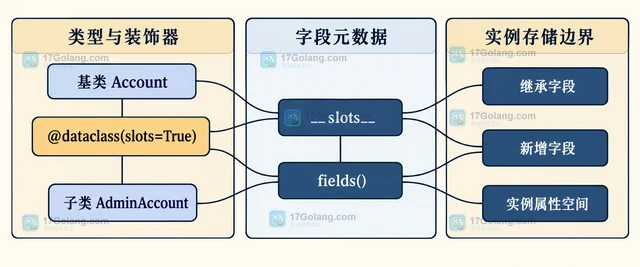
- Python dataclasses slots 与继承字段的设计
- 399浏览 收藏
-
- 文章 · python教程 | 8小时前 |
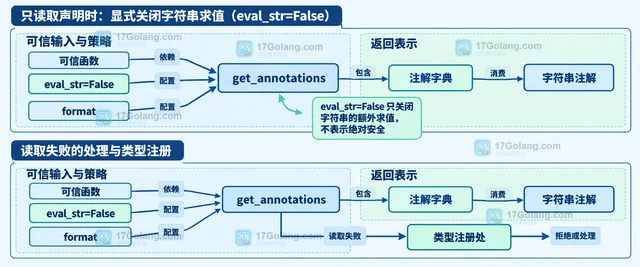
- Python inspect.get_annotations 怎样安全读取函数注解
- 440浏览 收藏
-
- 文章 · python教程 | 8小时前 | 网络编程 · 标准库 · Python教程 · Python 网段判断 ipaddress IPv4Network IPv4Address
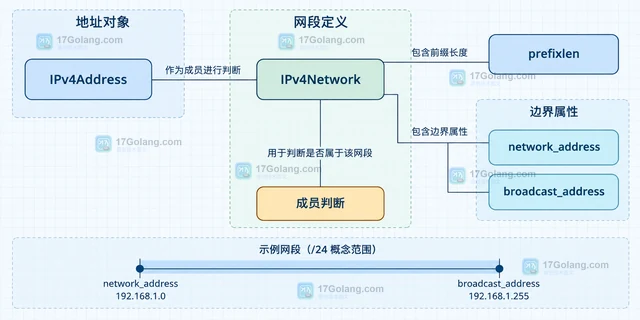
- Python ipaddress.IPv4Network 怎样判断地址是否属于网段
- 365浏览 收藏
-
- 文章 · python教程 | 8小时前 | 标准库 · Python教程 · Python 附件 MIME email.message EmailMessage add_attachment
- Python email.message.EmailMessage 怎样添加 MIME 附件
- 170浏览 收藏
-
- 文章 · python教程 | 8小时前 | 标准库 · Python教程 · Python 命令行 位置参数 argparse parse_intermixed_args
- Python argparse.parse_intermixed_args 怎样处理混合位置参数
- 342浏览 收藏
-
- 文章 · python教程 | 8小时前 | Python教程 · Python 保留关键字 str.isidentifier keyword.iskeyword 名称校验
- Python str.isidentifier 为什么不能排除保留关键字
- 282浏览 收藏
-
- 文章 · python教程 | 8小时前 | 字符串 · Python教程 · Python 字符替换 str.maketrans str.translate 字符串清理
- Python str.maketrans 怎样同时替换字符并删除指定符号
- 264浏览 收藏
-
- 文章 · python教程 | 8小时前 | 字符串 · Python教程 · Python 制表符 str.expandtabs tabsize 字符串排版
- Python str.expandtabs 怎样按制表位展开空格
- 284浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 761次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 757次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 842次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 808次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 638次使用
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览


