
Python线性回归实现教程
2026-03-25 12:51:31
0浏览
收藏
本文深入剖析了scikit-learn中LinearRegression的底层机制与实战陷阱,明确指出它**唯一且默认采用标准最小二乘法**(非可选配置),不支持solver参数、无内置正则化、不自动标准化,并重点警示新手高频踩坑点:X必须为二维数组(一维特征需reshape(-1,1))、predict恒输出1D结果、coef_与intercept_的形状规律、特征顺序与列名一致性风险等——看似简单的线性回归,真正制约建模效率和准确性的,往往不是算法本身,而是数据形态、维度匹配与API行为细节的精准把控。
scikit-learn 的 LinearRegression 默认就是最小二乘法
它不是“一种可选方法”,而是唯一实现方式——LinearRegression 底层调用的是 scipy.linalg.lstsq 或 LAPACK 的 dgelss,纯正最小二乘求解。不用手动设参数,也不支持换其他损失函数(比如 Huber 或 L1)。
常见错误是以为要传 solver='lsqr' 或类似参数,其实那属于 SGDRegressor 或 Ridge 的配置项;对 LinearRegression 来说,加了反而报错:TypeError: __init__() got an unexpected keyword argument 'solver'。
- 只管拟合,不自动中心化或缩放特征——如果你的特征量纲差三四个数量级,系数会难解释,但不影响预测效果
- 没有内置正则项,遇到多重共线性时
.coef_可能剧烈震荡,甚至出现nan(极少数病态矩阵下) - 想加 L2 正则?直接换
Ridge,别硬改LinearRegression
fit() 前必须确保 X 是二维数组,否则报 ValueError: Expected 2D array, got 1D array instead
这是新手掉进最多的一次坑:把一列特征写成 y = model.fit(x, y),其中 x 是 shape 为 (n,) 的 numpy.ndarray。sklearn 所有模型都要求输入特征是二维结构,哪怕只有一列。
正确做法:
- 单特征一维数组转二维:
x.reshape(-1, 1)或x[:, np.newaxis] - 用 pandas 时注意:
df['col']返回 Series(一维),得写成df[['col']](DataFrame,二维) - 如果误用了
np.array([1,2,3])直接传入,fit()不会帮你升维,也不会静默容忍
predict() 输出永远是 1D 数组,不管 X 是 1 行还是 1000 行
model.predict(X) 的返回值 shape 总是 (n_samples,),不是 (n_samples, 1)。这点和 fit_transform() 类方法不同,容易在拼接预测结果和原始 DataFrame 时出错。
典型问题场景:
- 你拿
df['pred'] = model.predict(X)赋值,结果列长度对不上——大概率是X维度错了,而不是predict返回格式异常 - 想和真实标签
y_true一起算 MSE?确保两者都是 1D 且等长:mean_squared_error(y_true, y_pred)要求两个输入维度一致 - 不需要手动
.flatten()或.ravel(),它本来就是扁平的;但如果你做了.reshape(1, -1)反而会让后续计算报错
intercept_ 和 coef_ 的形状取决于输入 X 的列数,别硬套公式 y = ax + b
当 X 有多个特征时,coef_ 是 1D 数组,长度等于特征数;intercept_ 永远是标量(float)。没有“每个特征一个截距”这种事。
容易混淆的点:
- 你以为
coef_[0]对应第一个变量,就去手写y_hat = coef_[0] * x1 + coef_[1] * x2 + intercept_——没错,但前提是x1,x2都是同长度 1D 向量,且顺序和训练时列顺序严格一致 - 如果训练用的是
pd.DataFrame,列名顺序变了(比如先读 CSV 再重排列),coef_顺序不会跟着变,得靠model.feature_names_in_(>=1.2 版本)核对 - 老版本 sklearn 不提供
feature_names_in_,此时只能靠训练时传入的 X 的.columns或.shape[1]推断,不能靠变量名猜
复杂点在于:线性回归本身简单,但数据进出的形状、命名、顺序这些外围环节,才是实际项目里最常打断节奏的地方。
文中关于的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《Python线性回归实现教程》文章吧,也可关注golang学习网公众号了解相关技术文章。
 宝塔Let'sEncrypt证书申请失败解决方法
- 上一篇
- 宝塔Let'sEncrypt证书申请失败解决方法
- 下一篇
- CSSfit-content自适应宽度技巧
查看更多
最新文章
-
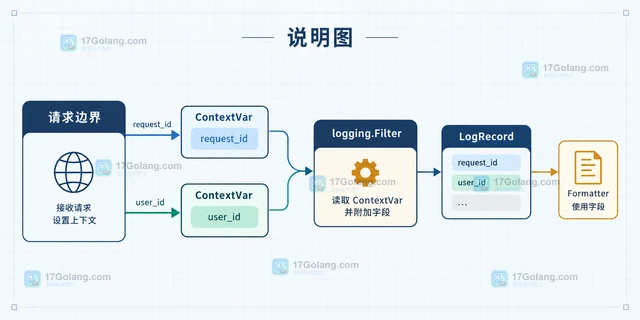
- 文章 · python教程 | 11小时前 | 日志 · logging · Python教程 · Python contextvars request_id LogRecord logging.Filter
- Python logging.Filter 注入请求上下文的做法
- 410浏览 收藏
-
- 文章 · python教程 | 3天前 | Python教程 · Python 鸭子类型 typing.Protocol 结构子类型
- Python typing.Protocol 约束鸭子类型接口
- 246浏览 收藏
-
- 文章 · python教程 | 3天前 | Python教程 · Python 相对路径 is_file pathlib Path.resolve
- Python pathlib 相对路径规范化与文件判断
- 144浏览 收藏
-
- 文章 · python教程 | 3天前 | python · 异步编程 · asyncio · Python CancelledError asyncio.timeout TimeoutError
- Python asyncio.timeout 嵌套取消与异常传播
- 373浏览 收藏
-
- 文章 · python教程 | 3天前 |
- Python heapq 最大堆 API 怎么避免手动取负数
- 397浏览 收藏
-
- 文章 · python教程 | 4天前 | python · Python 不可变对象 namedtuple dataclass copy.replace
- Python copy.replace 怎么更新不可变对象字段
- 245浏览 收藏
-
- 文章 · python教程 | 4天前 | python ·
- Python NamedTemporaryFile 的 delete_on_close 怎么设置
- 311浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 292次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 345次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 350次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 313次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 133次使用
查看更多
相关文章
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览


