
Pandasapply清洗列返回NaN原因及解决方法
本文深入剖析了pandas中使用`str.extract()`配合`apply()`清洗字符串列时频发NaN的根源——并非代码缺陷,而是正则表达式(如强制匹配小数点的`r'([a-z\d]+\.[a-z\d]+)'`)与真实数据格式(如CSV中无小数点的整数)严重脱节所致;通过对比CSV原始数据与人工列表的关键差异,文章不仅揭示了“看似相同逻辑却结果迥异”的底层机制,更提供了可立即落地的解决方案:采用鲁棒数字正则`r'(-?\d+(?:\.\d+)?)'`、安全清理非数字字符、显式处理空字符串,并强调`pd.to_numeric(..., errors='coerce')`等更高效替代方案,最终指出数据清洗的核心原则——正则是工具,理解数据本身才是避免NaN的第一步。
本文揭示了使用 pandas.Series.str.extract() 配合 apply() 清洗字符串列时意外产生大量 NaN 的核心原因——正则表达式模式与实际数据格式不匹配,并提供可复现的诊断方法与健壮的修复方案。
本文揭示了使用 `pandas.Series.str.extract()` 配合 `apply()` 清洗字符串列时意外产生大量 NaN 的核心原因——正则表达式模式与实际数据格式不匹配,并提供可复现的诊断方法与健壮的修复方案。
在 Pandas 数据清洗实践中,一个常见但易被忽视的问题是:看似相同的清洗逻辑,在不同数据源(如 CSV 文件 vs 手动构造列表)上执行结果却大相径庭。正如问题所示,当对 df[['X', 'Y']] 直接应用正则提取 + 替换逻辑时,大量本应成功解析的数值却返回 NaN;而将相同逻辑应用于手动构造的 new_df 时却完全正常。这并非 apply() 或正则引擎的 Bug,而是数据底层格式差异触发了正则匹配失败。
关键线索藏在原始 CSV 与人工列表的第一行对比中:
# data.csv 第一行(逗号分隔,无小数点):
0,1,573436862,3887259269

# thelist 第一行(含小数点):
['1', '573436.862', '3887259.269']
原正则 r'([a-z\d]+\.[a-z\d]+)' 强制要求匹配一个字面量点号 .(因 \. 是转义字符)。而 CSV 中的数字(如 573436862)是整数格式、不含小数点,导致 str.extract() 完全无法匹配,返回 NaN;后续的 .str.replace(...) 对 NaN 无作用,最终结果仍是 NaN。
✅ 正确做法是:使正则适配真实数据分布。若目标是提取任意浮点或整数形式的数字(无论是否带小数点),应改用更鲁棒的数字匹配模式:
import pandas as pd
import re

df = pd.read_csv('data.csv', index_col=[0])

# ✅ 推荐:匹配科学计数法/整数/小数(支持可选小数点及后续数字)
numeric_pattern = r'(-?\d+(?:\.\d+)?)'

out = df[['X', 'Y']].apply(lambda s:
    s.str.extract(numeric_pattern, expand=False)
    .str.replace(r'[^\d.-]+', '', regex=True)  # 清理非数字、非小数点、非负号字符
    .replace('', pd.NA)  # 空字符串转为 NA,避免空字符串干扰
)

out.index += 1
print(out.head())
⚠️ 注意事项:
- str.extract() 返回 NaN 表示无匹配,不是错误,需先确认数据是否真包含目标模式;
- 使用 expand=False 时,extract() 返回 Series;若需多组捕获,设 expand=True 并指定列名;
- str.replace(..., regex=True) 对 NaN 安全,但对空字符串('')无效——务必用 .replace('', pd.NA) 或 .str.strip().replace('', pd.NA) 预处理;
- 调试技巧:对单列运行 df['X'].str.contains(r'\.', na=False) 快速验证小数点覆盖率;
- 更优实践:优先使用 pd.to_numeric(..., errors='coerce') 处理纯数字列,它比正则更高效且自动处理常见异常格式。
总结:apply() 返回 NaN 往往是“数据未达预期”而非“代码有误”。始终以 df['col'].sample(10).tolist() 或 df['col'].str[:50] 检查原始数据形态,再设计匹配逻辑——正则是工具,数据才是真相的源头。
终于介绍完啦!小伙伴们,这篇关于《Pandasapply清洗列返回NaN原因及解决方法》的介绍应该让你收获多多了吧!欢迎大家收藏或分享给更多需要学习的朋友吧~golang学习网公众号也会发布文章相关知识,快来关注吧!
 遭遇中奖诈骗如何应对?
- 上一篇
- 遭遇中奖诈骗如何应对?
- 下一篇
- CSScalc()动态尺寸计算技巧
-
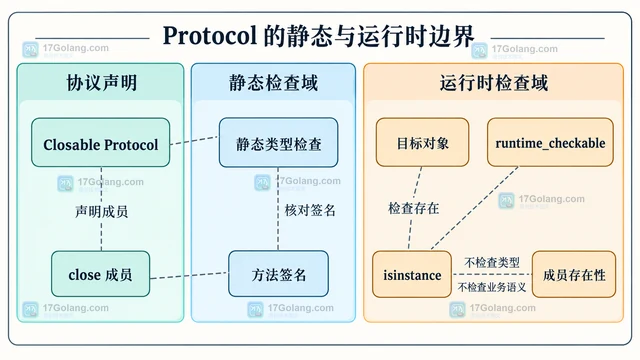
- 文章 · python教程 | 1天前 | Python教程 · Python 鸭子类型 typing.Protocol 结构子类型
- Python typing.Protocol 约束鸭子类型接口
- 246浏览 收藏
-
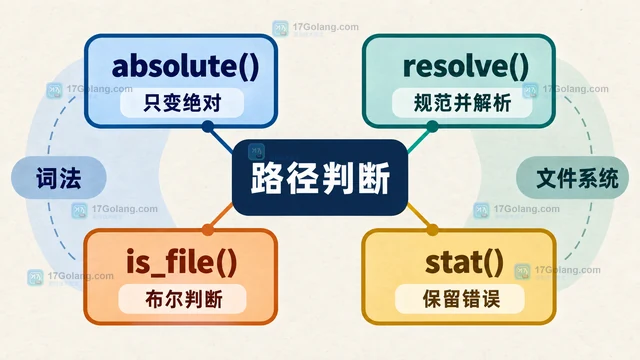
- 文章 · python教程 | 1天前 | Python教程 · Python 相对路径 is_file pathlib Path.resolve
- Python pathlib 相对路径规范化与文件判断
- 144浏览 收藏
-
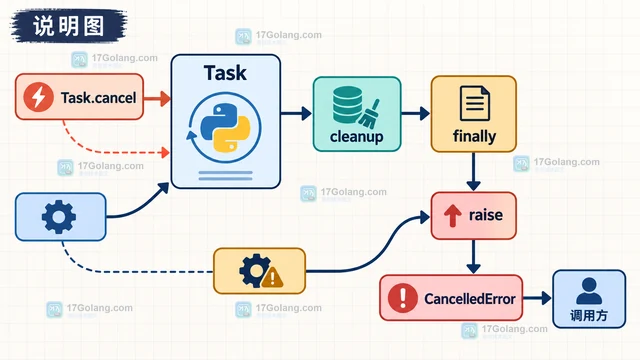
- 文章 · python教程 | 1天前 | python · 异步编程 · asyncio · Python CancelledError asyncio.timeout TimeoutError
- Python asyncio.timeout 嵌套取消与异常传播
- 373浏览 收藏
-
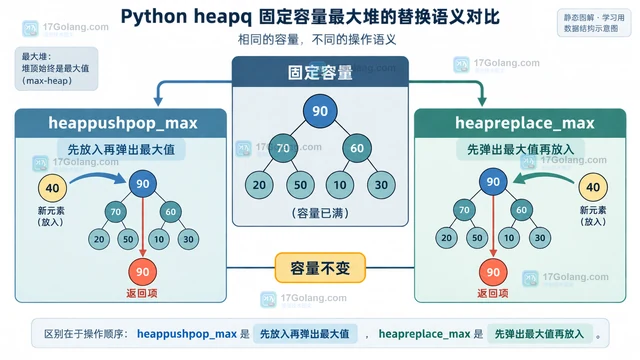
- 文章 · python教程 | 2天前 |
- Python heapq 最大堆 API 怎么避免手动取负数
- 397浏览 收藏
-
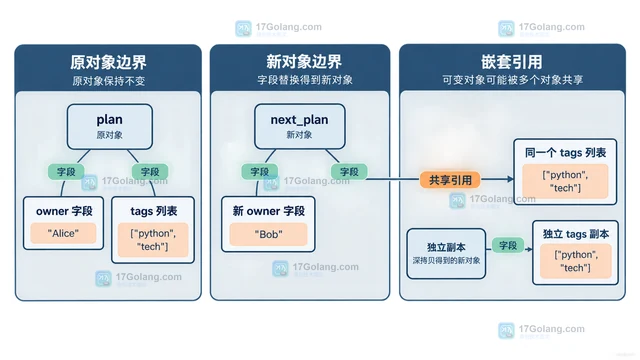
- 文章 · python教程 | 2天前 | python · Python 不可变对象 namedtuple dataclass copy.replace
- Python copy.replace 怎么更新不可变对象字段
- 245浏览 收藏
-
- 文章 · python教程 | 2天前 | python ·
- Python NamedTemporaryFile 的 delete_on_close 怎么设置
- 311浏览 收藏
-
- 文章 · python教程 | 2天前 |
- Python itertools.batched strict 参数什么时候会报错
- 306浏览 收藏
-
- 文章 · python教程 | 2天前 |
- Python ExceptionGroup split 怎么按异常类型拆分
- 311浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 271次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 322次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 310次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 288次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 104次使用
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览