
Java分段锁与ConcurrentHashMap演变解析
本文深入剖析了Java中分段锁思想在ConcurrentHashMap从1.7到1.8版本的演进历程:1.7版通过Segment数组实现粗粒度分段加锁,虽提升了并发度但存在哈希倾斜退化、size()阻塞、内存冗余等固有缺陷;而1.8版彻底摒弃Segment,转而采用CAS无锁插入+同步锁单个Node的细粒度策略,并引入红黑树优化高碰撞场景,显著提升吞吐与扩展性——这不仅是一次API升级,更是对“锁粒度与性能平衡”这一核心并发命题的深刻实践,值得每一位Java开发者重新审视底层设计逻辑与真实业务场景间的匹配关系。

分段锁在ConcurrentHashMap 1.7里怎么实现的
ConcurrentHashMap 1.7 的分段锁本质是把整个哈希表切成了 Segment 数组,每个 Segment 是一个独立的 ReentrantLock + 小型哈希表。写操作(如 put)只锁住对应 key 落入的那个 Segment,其他段还能并发读写。
常见错误现象:以为“分段”能彻底避免锁竞争——其实如果大量 key 哈希后落在同一个 Segment(比如自定义 hashCode 返回固定值),那它就退化成单点瓶颈,吞吐不升反降。
实操建议:
concurrencyLevel参数只是初始化Segment数组长度的提示值,不是硬上限;实际段数会取大于等于该值的最小 2 的幂(如传 10 → 实际用 16 段)- 每个
Segment内部仍是数组 + 链表,扩容时只扩本段,但size()需要尝试加锁所有段来累加,可能阻塞较久 - JDK 1.7 的
get()完全无锁,靠volatile变量和不可变节点保证可见性——这点常被误认为“读也加锁”,其实不是
为什么 1.8 彻底干掉了 Segment
因为 Segment 带来额外内存开销(每个段都有一套 table、count、modCount 等字段),且无法解决单个桶(bin)的并发冲突——只要两个线程往同一个链表头插入,还是得串行。
1.8 改用“CAS + synchronized 锁单个 Node”:数组元素(Node)本身作为锁粒度,配合 TreeBin 在链表过长时转红黑树,进一步降低哈希碰撞下的查找/插入成本。
实操建议:
- 1.8 的
put()先无锁 CAS 插入头节点,失败才用synchronized (f)锁住该桶的首节点(f),不是锁整个 table - 扩容(
transfer)变成协作式迁移:多个线程可同时参与搬数据,每个线程负责一段table区间,通过stride控制粒度 - 注意
computeIfAbsent这类方法在 1.8 中可能触发树化或扩容,若 lambda 里有阻塞操作,会卡住整个桶,影响其他线程对该桶的操作
从 1.7 升级到 1.8 后哪些行为变了
最易踩坑的是迭代器语义和 size() 行为差异:1.7 的 keySet().iterator() 是弱一致性(weakly consistent),允许遍历时修改;1.8 的迭代器仍弱一致,但内部结构变化更频繁(树/链表切换、扩容中迁移),导致某些遍历结果更“跳跃”。
性能上,1.8 在高并发写+低哈希碰撞场景下优势明显;但若写操作极少、读极多,1.7 的无锁 get() 和更简单的结构反而更轻量。
实操建议:
size()在 1.7 中需加锁统计所有Segment,可能慢;1.8 改用baseCount + CounterCell[]的 CAS 累加,但仍是近似值——严格计数请改用mappingCount()- 1.8 不再支持
rehash相关监控(如segments字段已不存在),依赖反射或 JMX 查看内部状态的代码会直接失败 - 自定义
Comparator用于树化时,必须满足与equals()一致的逻辑,否则containsKey可能返回 false(即使 key 存在)
现在还该手动分段锁吗
几乎不该。除非你在 JDK 1.7 环境下维护老系统,或者面对的是极特殊场景:比如某个业务 key 天然聚合成几十个大组,每组内操作高度隔离,且你愿意承担自己实现锁分片、负载均衡、扩容协调的复杂度。
现实中,JDK 1.8 的 ConcurrentHashMap 已经把锁粒度压到单个桶,配合 CAS 和树化,对绝大多数场景足够。手动分段反而容易引入死锁(比如跨段操作没按固定顺序加锁)、状态不一致(段间计数不同步)等问题。
真正要注意的其实是:别把 ConcurrentHashMap 当作通用线程安全容器去塞各种复杂对象——它的线程安全只保障自身结构变更,value 对象内部状态是否线程安全,它不管。
文中关于的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《Java分段锁与ConcurrentHashMap演变解析》文章吧,也可关注golang学习网公众号了解相关技术文章。
 抖音极速版提现限时档位怎么用
- 上一篇
- 抖音极速版提现限时档位怎么用

- 下一篇
- Win11PowerShell卸载软件方法
-
- 文章 · java教程 | 1天前 |
- Maven toolchains 怎样固定构建 JDK
- 458浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Spring Boot @ConfigurationProperties 怎样绑定嵌套集合
- 396浏览 收藏
-
- 文章 · java教程 | 1天前 | 资源管理 · Java教程 · java arena scope MemorySegment FFM Foreign Function and Memory 本地内存
- Java FFM Arena 怎样管理本地内存生命周期
- 300浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java Parameter.isImplicit 怎样识别隐式声明的参数
- 168浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java SubmissionPublisher 怎样处理订阅者过慢
- 205浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java Matcher.hitEnd 怎样判断输入是否被截断
- 354浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java Package.getImplementationVendor 怎样读取包实现供应商
- 310浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java HttpClient 怎样流式保存大响应
- 192浏览 收藏
-
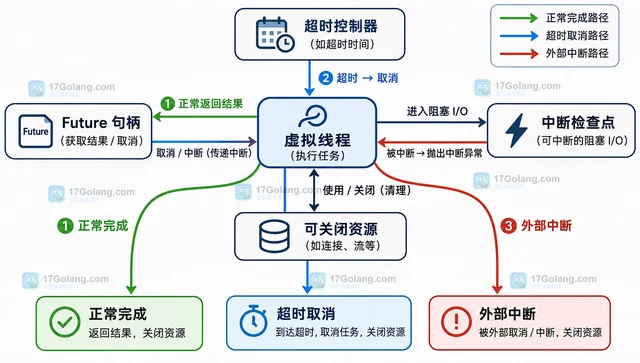
- 文章 · java教程 | 1天前 | 虚拟线程 · java future InterruptedException TimeoutException cancel Virtual Threads
- Java virtual threads 怎样让任务支持可取消超时
- 434浏览 收藏
-
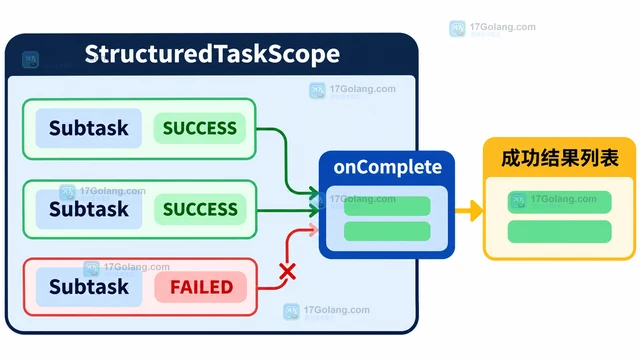
- 文章 · java教程 | 1天前 | 并发 · Java · java 结构化并发 StructuredTaskScope 部分成功 StructuredTaskScope.Joiner
- Java StructuredTaskScope 怎样收集部分成功结果
- 398浏览 收藏
-
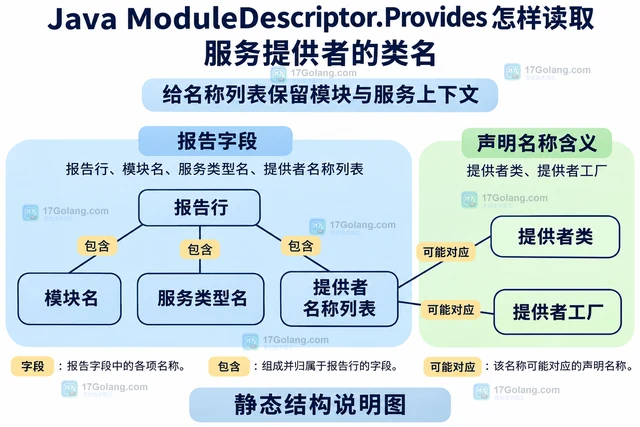
- 文章 · java教程 | 1天前 |
- Java ModuleDescriptor.Provides 怎样读取服务提供者的类名
- 176浏览 收藏
-
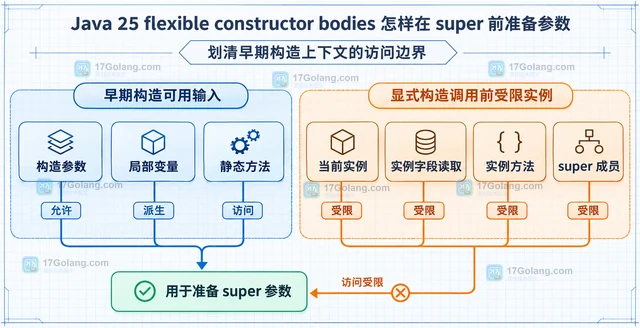
- 文章 · java教程 | 1天前 | Java · 语言特性 · java super Java 25 Flexible Constructor Bodies
- Java 25 flexible constructor bodies 怎样在 super 前准备参数
- 212浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 933次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 938次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1047次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1019次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 846次使用
-
- Java 时间格式兼容多个输入格式的方法
- 2026-10-18 501浏览
-
- Java try-with-resources 多个资源关闭顺序是什么
- 2026-09-10 501浏览
-
- 矩阵主副对角线快速定位技巧
- 2026-05-31 501浏览
-
- Java多态优化流程代码与行为分发改进
- 2026-05-26 501浏览
-
- JVM 类元数据双亲委派链表深度解析
- 2026-05-21 501浏览


