
Python线程锁原理与使用技巧
本文深入剖析了Python线程锁(threading.Lock与RLock)的本质原理与实战要点:它并非依赖Python解释器层面的机制,而是直接封装操作系统原生互斥锁(如pthread_mutex或CreateMutex),实现真正的内核级阻塞等待;强调了with语句在确保锁安全释放中的不可替代性,警示手动管理acquire/release易引发死锁,并厘清了Lock与RLock在递归调用、性能开销和释放权限上的关键差异;更进一步指出,盲目扩大锁粒度、错误锁定I/O操作或混淆“线程安全”与“逻辑正确”的边界,反而会扼杀并发性能、掩盖深层问题——真正有效的并发控制,始于对共享数据访问路径的精准识别,成于细粒度、职责分明、且与业务逻辑深度契合的锁设计。

Python 的 threading.Lock 底层靠什么工作?
它不靠 Python 字节码或解释器魔法,而是直接绑定操作系统原生互斥锁(mutex)。CPython 解释器在创建 threading.Lock 实例时,会调用 pthread_mutex_init(Linux/macOS)或 CreateMutex(Windows),后续的 acquire() 和 release() 就是在操作这些系统级对象。
这意味着:只要线程被 OS 调度、且能进入内核态等待,Lock 就能真正阻塞——不是轮询,也不是 Python 层面的“假装等”。但这也带来一个关键约束:Lock 对 GIL 无感知,它保护的是你指定的共享数据,不是 Python 对象的内部状态。
为什么 with lock: 比手动 acquire()/release() 更安全?
因为异常会打断执行流,手动调用容易漏掉 release(),导致死锁。而 with 语句通过上下文管理器协议,保证无论是否发生异常,__exit__ 都会被调用,从而释放锁。
常见错误现象:acquire() 后抛出 KeyError 或 NetworkError,没走到 release(),后续所有线程卡在 acquire() 上。
- 永远优先用
with lock:,除非你明确需要非阻塞获取(这时用lock.acquire(blocking=False)) - 不要在
with块里做耗时操作(比如 HTTP 请求、文件读写),否则锁持有时间过长,拖慢并发效率 - 如果必须提前退出,用
return或raise都没问题,with仍会释放锁
RLock 和普通 Lock 在递归调用时的区别
普通 Lock 不允许同一线程重复 acquire(),第二次就会永久阻塞;RLock(可重入锁)则记录持有线程和计数,同一线程可多次获取,但必须调用相同次数的 release() 才真正释放。
使用场景:类方法之间相互调用,且各自都试图加锁——比如 add_item() 调用了 validate(),而两者都尝试拿同一把锁。
- 误用
Lock会导致看似“无理由”的卡死,错误现象是线程停在某个acquire()上,threading.enumerate()显示它还在运行 RLock有额外开销(要存线程 ID、维护计数),性能略低于Lock,别为图省事默认全用RLockRLock不能被其他线程release(),只有持有者才能释放,这点和Lock一致
锁粒度太粗会掩盖真正的并发问题
比如整个函数体包在一个 with lock: 里,看起来线程安全了,实则把本可并行的操作串行化,吞吐量掉一半,还可能让你误以为“加了锁就万事大吉”,忽略对共享数据访问路径的梳理。
真正该锁的,只是读写同一块内存(如全局 dict、实例变量)的那几行代码,而不是“整个业务逻辑”。
- 检查所有共享变量:哪些被多个线程读?哪些被写?读写是否需要原子性?
- 避免锁住 I/O 操作(
requests.get()、open())、数据库查询等——它们本身不共享内存,加锁反而降低并发度 - 如果发现多个不相关的共享变量共用一把锁,考虑拆成多把锁(如
item_lock和stats_lock),但要注意避免锁顺序不一致引发死锁
最常被忽略的一点:锁只解决竞态条件,不解决逻辑错误。比如两个线程都读到 count=5,各自加 1 再写回,结果还是 6——这种得靠原子操作(threading.local、队列、或更高层的同步原语)来破,不是多加几把锁就能绕过去的。
文中关于的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《Python线程锁原理与使用技巧》文章吧,也可关注golang学习网公众号了解相关技术文章。
 CSS网格布局性能解析:二维布局渲染机制详解
- 上一篇
- CSS网格布局性能解析:二维布局渲染机制详解

- 下一篇
- 2026年体育中考时间最新公布
-
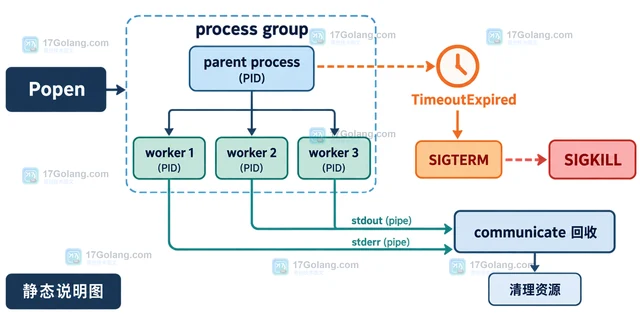
- 文章 · python教程 | 22小时前 | python · 进程管理 · Python subprocess Popen 进程树 TimeoutExpired 超时清理
- Python subprocess 超时后清理子进程树
- 108浏览 收藏
-
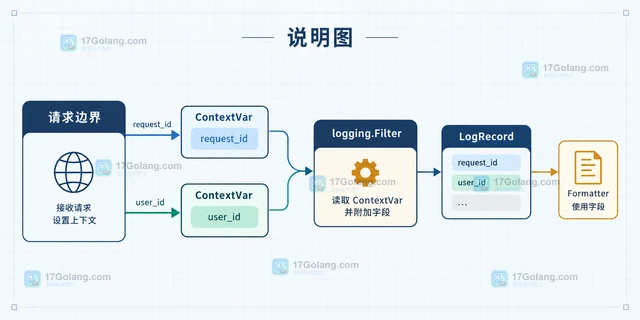
- 文章 · python教程 | 1天前 | 日志 · logging · Python教程 · Python contextvars request_id LogRecord logging.Filter
- Python logging.Filter 注入请求上下文的做法
- 410浏览 收藏
-
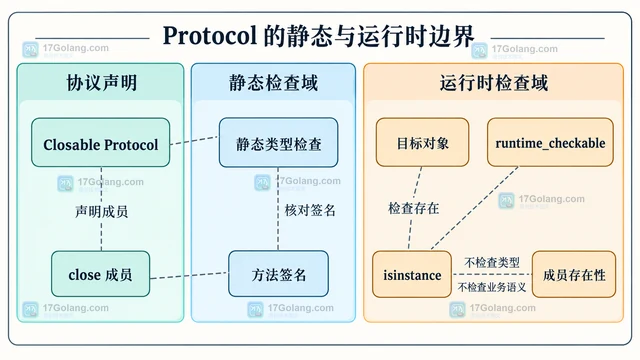
- 文章 · python教程 | 4天前 | Python教程 · Python 鸭子类型 typing.Protocol 结构子类型
- Python typing.Protocol 约束鸭子类型接口
- 246浏览 收藏
-
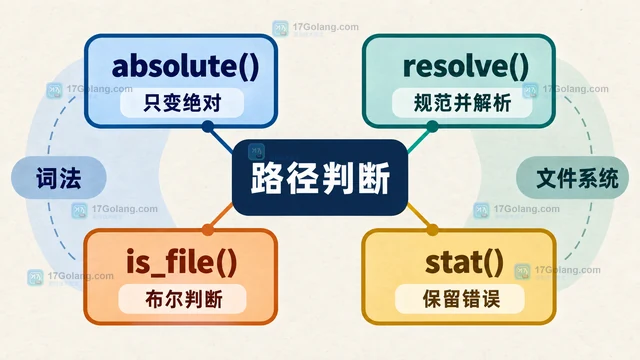
- 文章 · python教程 | 4天前 | Python教程 · Python 相对路径 is_file pathlib Path.resolve
- Python pathlib 相对路径规范化与文件判断
- 144浏览 收藏
-
- 文章 · python教程 | 4天前 | python · 异步编程 · asyncio · Python CancelledError asyncio.timeout TimeoutError
- Python asyncio.timeout 嵌套取消与异常传播
- 373浏览 收藏
-
- 文章 · python教程 | 5天前 |
- Python heapq 最大堆 API 怎么避免手动取负数
- 397浏览 收藏
-
- 文章 · python教程 | 5天前 | python · Python 不可变对象 namedtuple dataclass copy.replace
- Python copy.replace 怎么更新不可变对象字段
- 245浏览 收藏
-
- 文章 · python教程 | 5天前 | python ·
- Python NamedTemporaryFile 的 delete_on_close 怎么设置
- 311浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 312次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 370次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 364次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 334次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 155次使用
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览


