
多DataFrame按序号对齐合并技巧
2026-02-25 17:36:54
0浏览
收藏
本文详解了一种精准、鲁棒的多DataFrame对齐合并方法,特别适用于系统性能测试等场景中需按语义化迭代标识(如“1_1”“2_2”)横向比对不规则数据的情况——它摒弃了易出错的位置索引依赖和键值严格匹配的局限,通过“设索引→按目标列表reindex强制对齐→重置索引→水平拼接”三步核心流程,确保输出行序严格一致、缺失项自动填充NaN、多源列名清晰可辨,兼具准确性、可扩展性与工程实用性,是处理非对称实验数据比对的高效标准解法。
本文介绍如何基于指定的迭代标识(如"1_1"、"2_2"等)从多个DataFrame中精准提取行,并沿列方向(axis=1)对齐合并,适用于性能测试数据比对等场景。
在实际数据分析(尤其是系统性能基准测试)中,常需对比不同实验轮次下相同迭代编号(如 1_1, 2_2)的指标(如 IOPS、延迟),但各DataFrame的行顺序、长度及覆盖范围往往不一致。此时,不能直接使用 merge 或 join(因需严格匹配键值),也不能依赖索引位置(因顺序不可靠);正确做法是:先按用户指定的迭代ID列表对每个DataFrame进行语义对齐(semantic alignment)——即重排行序、补全缺失(设为NaN)、确保输出顺序与目标列表完全一致,再水平拼接。
核心思路分三步:
- 将 'iteration' 列设为索引;
- 使用 .reindex() 按目标ID列表强制重排并对齐(未命中ID自动填充NaN);
- 重置索引并用 pd.concat(..., axis=1) 横向合并多个对齐后的DataFrame。
以下为完整实现代码:
import pandas as pd

# 示例数据(与问题一致)
df1 = pd.DataFrame({
    'iteration': ['1_1', '2_2', '3_3', '4_4', '5_5', '6_6', '7_7', '8_8', '9_9'],
    'IOPS': [46090, 12, 49164, 98311, 196604, 249843, 298974, 348108, 397230],
    'Latency': [0.7300, 0.0221, 0.1236, 0.1318, 0.2076, 0.1467, 0.1578, 0.1604, 0.1707]
})

df2 = pd.DataFrame({
    'iteration': ['1_1', '2_2', '3_3', '4_4', '5_5', '6_6'],
    'IOPS': [46074, 12, 49159, 98307, 298976, 397265],
    'Latency': [0.6977, 0.0279, 0.1921, 0.2189, 0.2337, 0.2622]
})

# 定义对齐函数:按指定 iteration 列表重排 DataFrame
def align_by_iteration(df, target_iters):
    return (df.set_index('iteration')
              .reindex(target_iters)  # 关键:保持 target_iters 的顺序,缺失行填 NaN
              .reset_index()          # 恢复 iteration 为普通列
           )

# 对两个 DataFrame 分别对齐后横向拼接
df3 = pd.concat([
    align_by_iteration(df1, ['1_1', '2_2', '3_3', '9_9']),
    align_by_iteration(df2, ['1_1', '2_2', '5_5', '6_6'])
], axis=1)

print(df3)
输出结果将严格按输入列表顺序对齐,且列名自动保留原始前缀(无重复列名冲突):
  iteration    IOPS  Latency iteration    IOPS  Latency
0       1_1   46090   0.7300       1_1   46074   0.6977
1       2_2      12   0.0221       2_2      12   0.0279
2       3_3   49164   0.1236       5_5  298976   0.2337
3       9_9  397230   0.1707       6_6  397265   0.2622
✅ 关键优势与注意事项:
- 顺序严格保证:.reindex() 确保输出行顺序与 target_iters 列表完全一致,不受原始DataFrame顺序影响;
- 缺失值显式处理:若某ID在源DataFrame中不存在,对应行所有字段为 NaN,便于后续识别数据缺口;
- 可扩展性强:支持任意数量DataFrame,只需将 (df, target_list) 元组传入 starmap 或循环调用 align_by_iteration;
- 避免隐式索引错误:切勿省略 .set_index('iteration') 步骤——直接对原始DataFrame用 .loc[target_list] 会因索引类型不匹配报错;
- 列名管理提示:若需区分来源列(如添加 _df1/_df2 后缀),可在 concat 前使用 add_suffix(),例如 align_by_iteration(...).add_suffix('_A')。
该方法兼顾准确性、可读性与工程鲁棒性,是处理非对称实验数据比对的标准实践。
以上就是本文的全部内容了,是否有顺利帮助你解决问题?若是能给你带来学习上的帮助,请大家多多支持golang学习网!更多关于文章的相关知识,也可关注golang学习网公众号。
 鸡肉冷藏能放几天?冷冻多久会变质?
- 上一篇
- 鸡肉冷藏能放几天?冷冻多久会变质?
- 下一篇
- 快速拖车救援服务全攻略
查看更多
最新文章
-
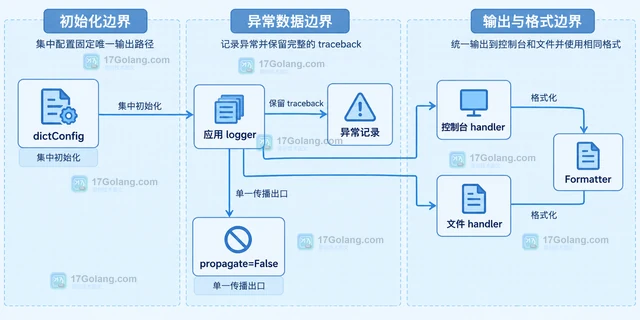
- 文章 · python教程 | 13小时前 | 异常处理 · python · logging · handler traceback propagate Python logging logging.exception 日志重复输出
- Python logging 怎样为异常记录 traceback 但避免重复输出
- 181浏览 收藏
-
- 文章 · python教程 | 13小时前 |
- Python zipfile.ZipFile 怎样用 ZIP64 写入超大文件
- 131浏览 收藏
-
- 文章 · python教程 | 13小时前 |
- Python tomllib 怎样读取配置中的日期字符串
- 223浏览 收藏
-
- 文章 · python教程 | 13小时前 | python ·
- Python sqlite3 怎样注册自定义类型适配器
- 438浏览 收藏
-
- 文章 · python教程 | 13小时前 | Python join TaskGroup asyncio.Queue task_done
- Python asyncio.Queue 怎样用 join 等待所有任务完成
- 426浏览 收藏
-
- 文章 · python教程 | 13小时前 |
- Python asyncio.timeout 怎样把超时转换成 TimeoutError
- 285浏览 收藏
-
- 文章 · python教程 | 13小时前 |
- Python asyncio.wait 怎样只处理先完成的任务
- 314浏览 收藏
-
- 文章 · python教程 | 13小时前 |
- Python pathlib.Path.from_uri 怎样解析带 UNC 的 file URI
- 281浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 682次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 698次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 748次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 713次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 551次使用
查看更多
相关文章
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览


