
自动化抓取CoinCodex数据的实用方法
2026-02-25 08:12:48
0浏览
收藏
本文揭秘了如何绕过CoinCodex前端图表的视觉屏障,通过逆向其开放但隐蔽的RESTful API,稳定、免密钥地批量抓取加密货币全市场总市值、BTC、ETH等核心资产的高精度时序数据,并提供开箱即用的Python脚本——支持自动时间对齐、Pandas标准化、灵活采样粒度与健壮错误处理,让原本难以获取的动态图表数据变成可定时更新、直接接入量化分析 pipeline 的可靠数据源。
本文详解如何通过逆向分析 CoinCodex 的前端 API,稳定获取加密货币全市场总市值等高频时序数据,并封装为可复用的 Python 脚本,支持批量采集、时间对齐与 Pandas 标准化处理。
CoinCodex(https://coincodex.com/market-cap/)以交互式图表形式展示加密货币市场总市值(SUM_ALL_COINS)、比特币(BTC)、以太坊(ETH)等关键资产的历史走势。这些图表由前端 JavaScript 动态加载,其真实数据源并非 HTML 页面本身,而是隐藏在后台的 RESTful API 接口。直接请求网页 HTML 无法获取原始时间序列,而盲目构造参数又易因签名、时间戳或反爬机制失败。所幸该站 API 设计相对开放——无需认证密钥,仅需正确传递查询参数即可返回结构化 JSON 数据。
以下是一个完整、健壮的采集示例,适用于 SUM_ALL_COINS(全市场总市值),并可轻松扩展至其他资产:
import pandas as pd
import requests
from typing import Optional, Dict, List

def fetch_chart_data(
    asset: str = "SUM_ALL_COINS",
    include: str = "market_cap",
    samples: str = "md",  # 'sm' (small), 'md' (medium), 'lg' (large)
    charts: str = "ALL",
    timeout: int = 10
) -> pd.DataFrame:
    """
    从 CoinCodex API 抓取指定资产的图表数据

    Parameters:
    -----------
    asset : str
        资产标识符,如 "SUM_ALL_COINS", "BTC", "ETH"
    include : str
        数据类型,如 "market_cap", "price", "volume"
    samples : str
        数据采样粒度:'sm'(约 300 点)、'md'(约 600 点)、'lg'(约 1200 点)
    charts : str
        图表类型,"ALL" 表示主趋势线(推荐)
    timeout : int
        HTTP 请求超时(秒)

    Returns:
    --------
    pd.DataFrame with columns ['Date', 'Value', 'Cap'] (for market_cap)
    """
    api_url = "https://coincodex.com/api/v1/assets/get_charts"

    # 注意:t 参数为 Unix 时间戳(秒),但实际作用是缓存键/防重放,非必需
    # 实测留空或使用当前时间戳均可成功;为稳定性建议固定或省略
    params = {
        "charts": charts,
        "samples": samples,
        "assets": asset,
        "include": include,
    }

    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    }

    try:
        response = requests.get(api_url, params=params, headers=headers, timeout=timeout)
        response.raise_for_status()
        data = response.json()

        # 解析响应:data[asset]["ALL"] 是核心时间序列列表
        if asset not in data:
            raise KeyError(f"Asset '{asset}' not found in API response")
        if "ALL" not in data[asset]:
            raise KeyError(f"'ALL' chart not available for asset '{asset}'")

        raw_series = data[asset]["ALL"]

        # 构建 DataFrame(注意字段顺序可能随 API 微调变化,此处按典型结构)
        df = pd.DataFrame(raw_series, columns=["Date", "Value", "Cap"])
        df["Date"] = pd.to_datetime(df["Date"], unit="s", utc=True).dt.tz_localize(None)

        return df.sort_values("Date").reset_index(drop=True)

    except requests.exceptions.RequestException as e:
        raise ConnectionError(f"API request failed: {e}")
    except (KeyError, ValueError, TypeError) as e:
        raise RuntimeError(f"Failed to parse API response: {e}")

# ✅ 使用示例:获取全市场总市值(中等粒度)
df_market = fetch_chart_data(
    asset="SUM_ALL_COINS",
    include="market_cap",
    samples="md"
)
print("✅ 全市场总市值数据(最后5条):")
print(df_market.tail())

# ✅ 批量采集示例:BTC + ETH 市值对比
assets = ["BTC", "ETH"]
dfs = {}
for a in assets:
    dfs[a] = fetch_chart_data(asset=a, include="market_cap", samples="sm")

# 合并并按日期对齐(可选)
aligned = pd.concat([
    dfs["BTC"][["Date", "Value"]].rename(columns={"Value": "BTC_MCap"}),
    dfs["ETH"][["Date", "Value"]].rename(columns={"Value": "ETH_MCap"})
], on="Date", how="outer").sort_values("Date").reset_index(drop=True)
关键注意事项与最佳实践:
- ? 参数 t 并非必需:原问题中尝试的 t=5693725 实为过期或无效时间戳(远小于 Unix 纪元)。实测该参数可完全省略,或设为当前时间戳 int(time.time()) 以提升缓存命中率,但不影响数据可用性。
- ? 响应结构依赖资产类型:data["BTC"]["ALL"] 是标准路径,但部分小币种可能仅返回 data["XRP"] 下单层结构。建议始终校验 asset in data 和 data[asset].get("ALL")。
- ⏱️ 采样粒度说明:samples=sm/md/lg 控制返回点数(非时间跨度),md 在精度与体积间较平衡;若需更长历史,优先增大 samples 而非调整 t。
- ? 反爬友好策略:添加 User-Agent 头已足够;避免高频请求(建议 ≥5 秒间隔),生产环境可加入 requests.Session() 复用连接及简单重试逻辑。
- ? 数据字段含义:对于 include="market_cap",三列通常为 [timestamp_s, market_cap_usd, volume_usd];若 include="price",则为 [timestamp_s, price_usd, market_cap_usd] —— 请以实际响应为准并做字段验证。
通过上述方法,你不仅能自动化获取 CoinCodex 的高质量时序特征,还可将 fetch_chart_data() 函数封装进数据管道,配合定时任务(如 APScheduler 或 cron)实现每日更新,为量化模型训练持续注入可靠的历史数据源。
到这里,我们也就讲完了《自动化抓取CoinCodex数据的实用方法》的内容了。个人认为,基础知识的学习和巩固,是为了更好的将其运用到项目中,欢迎关注golang学习网公众号,带你了解更多关于的知识点!
 Linux软件安装方法全解析
- 上一篇
- Linux软件安装方法全解析
- 下一篇
- 在线姓名评分解析,神算测名打分指南
查看更多
最新文章
-
- 文章 · python教程 | 22小时前 |
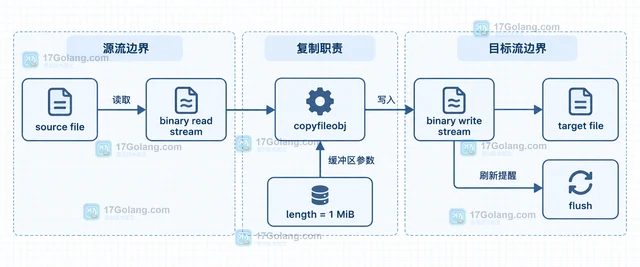
- Python shutil.copyfileobj 怎样控制大文件复制缓冲区
- 206浏览 收藏
-
- 文章 · python教程 | 22小时前 |
- Python logging 怎样按模块切分日志级别
- 151浏览 收藏
-
- 文章 · python教程 | 22小时前 |
- Python hashlib 怎样流式计算大文件摘要
- 149浏览 收藏
-
- 文章 · python教程 | 22小时前 | 配置管理 · python · Python 配置对象 dataclass dataclasses frozen FrozenInstanceError
- Python dataclass 怎样定义不可变配置对象
- 209浏览 收藏
-
- 文章 · python教程 | 23小时前 | 浮点数 · python · Python 浮点数 精度 quantize decimal.Decimal
- Python decimal.Decimal 怎样避免浮点数构造误差
- 369浏览 收藏
-
- 文章 · python教程 | 23小时前 | 文件处理 · python · Python TempFile 临时文件 NamedTemporaryFile delete_on_close
- Python tempfile.NamedTemporaryFile 怎样安全创建临时文件
- 407浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 642次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 674次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 716次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 679次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 510次使用
查看更多
相关文章
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览


