
Java用ForkJoinPool拆分任务详解
本文深入解析了Java中ForkJoinPool的适用场景与最佳实践,强调它专为可递归拆分的纯CPU密集型任务(如归并排序、大规模数组求和)而生,依托工作窃取机制显著提升多核利用率;但需警惕其不适用于I/O或阻塞操作,滥用会导致线程池耗尽甚至死锁,尤其要避免在CompletableFuture默认使用的commonPool中执行文件读取或HTTP调用;文章还详解了如何通过合理设置阈值、自定义并行度、正确继承RecursiveTask并使用invokeAll而非手动fork/join来写出高效、健壮的分治代码——帮你避开常见陷阱,真正释放多核性能。

什么时候该用 ForkJoinPool 而不是普通线程池
ForkJoinPool 专为「可递归拆分的计算型任务」设计,比如归并排序、树遍历、大规模数组求和。它用工作窃取(work-stealing)机制提升 CPU 利用率,但不适合 I/O 密集或阻塞操作——这类任务会让窃取线程卡住,反而拖慢整体吞吐。
常见误用场景:CompletableFuture.supplyAsync(..., forkJoinPool) 里执行 File.readAllBytes() 或 HttpClient.send(),结果线程池被占满,新任务排队甚至死锁。
- ✅ 适合:纯 CPU 计算、无锁、能切分成子任务且子任务粒度均衡
- ❌ 不适合:含
Thread.sleep()、Object.wait()、数据库查询、HTTP 调用 - ⚠️ 注意:
ForkJoinPool.commonPool()是 JVM 全局共享的,第三方库(如CompletableFuture默认)也在用,滥用会导致互相干扰
如何正确继承 RecursiveTask 拆分任务
核心是重写 compute() 方法:判断是否达到「阈值」,够小就直接算;否则 fork 出子任务,再 invokeAll() 并 join() 收集结果。
阈值不是越小越好——太小会增加任务调度开销;太大则无法充分利用多核。经验上,对简单计算(如整数累加),设为 10000 ~ 100000 元素较稳。
class SumTask extends RecursiveTask{ private final int[] array; private final int lo, hi; private static final int THRESHOLD = 10000; SumTask(int[] array, int lo, int hi) { this.array = array; this.lo = lo; this.hi = hi; } @Override protected Long compute() { if (hi - lo <= THRESHOLD) { long sum = 0; for (int i = lo; i < hi; i++) sum += array[i]; return sum; } int mid = lo + (hi - lo) / 2; SumTask left = new SumTask(array, lo, mid); SumTask right = new SumTask(array, mid, hi); invokeAll(left, right); // 自动 fork + 等待完成 return left.join() + right.join(); }}
ForkJoinPool 构造参数的实际影响
构造时传入的 parallelism 参数,并非「最多创建多少线程」,而是「活跃工作线程的目标数量」。它会影响:
parallelism小于 CPU 核心数 → 可能闲置核心parallelism远大于核心数 → 增加上下文切换,尤其在任务轻量时反降性能- 不指定时,默认用
Runtime.getRuntime().availableProcessors() - 1(commonPool)
自定义池建议显式指定并命名,便于排查线程 dump 中的线程归属:
ForkJoinPool pool = new ForkJoinPool(
    4, // parallelism
    ForkJoinPool.defaultForkJoinWorkerThreadFactory,
    (t, e) -> System.err.println("Uncaught in " + t.getName()),
    true // asyncMode:true 表示 LIFO 调度,适合后进先出任务(如深度优先遍历)
);
为什么 invokeAll 比手动 fork+join 更安全
手动调用 fork() 后必须配对 join(),漏掉或顺序错乱会导致任务丢失或死锁。而 invokeAll(task1, task2) 内部已封装了 fork + join + 异常传播逻辑,更简洁可靠。
另一个关键点:invokeAll 是批量提交,ForkJoinPool 会优化任务入队和唤醒策略;而连续写 task1.fork(); task2.fork(); task1.join(); task2.join(); 容易让当前线程过早阻塞,降低窃取效率。
如果真要手动控制,务必遵守「先 fork 所有子任务,再 join」的顺序,且确保每个 fork() 都有对应 join(),哪怕中间抛异常也要在 finally 里补上。
终于介绍完啦!小伙伴们,这篇关于《Java用ForkJoinPool拆分任务详解》的介绍应该让你收获多多了吧!欢迎大家收藏或分享给更多需要学习的朋友吧~golang学习网公众号也会发布文章相关知识,快来关注吧!
 兽音译者教程:平台操作技巧详解
- 上一篇
- 兽音译者教程:平台操作技巧详解

- 下一篇
- Go指针参数性能测试与分析
-
- 文章 · java教程 | 1天前 | Java · ServiceLoader module-info.java Java模块
- Java 模块服务加载的可选实现与回退路径
- 363浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java VarHandle 内存序选择与可见性验证
- 226浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java JFR 事件流定位短时延迟尖峰
- 213浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java Record 序列化兼容字段演进方案
- 483浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java ServiceLoader 隔离模块化插件实现
- 414浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java Pattern Matching switch 处理密封层级
- 189浏览 收藏
-
- 文章 · java教程 | 1天前 | Stream · Java教程 · java Stream Collector Collectors.teeing 统计汇总
- Java Collectors.teeing 汇总两条统计管道
- 385浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java Foreign Function Memory API 管理本地内存生命周期
- 385浏览 收藏
-
- 文章 · java教程 | 1天前 |
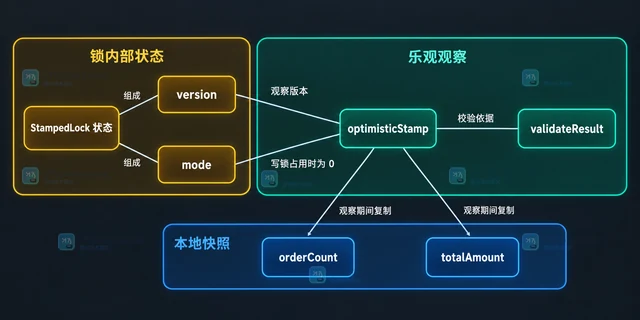
- Java StampedLock 乐观读校验失败的回退方式
- 165浏览 收藏
-
- 文章 · java教程 | 1天前 | 异常处理 · 并发编程 · Java教程 · StructuredTaskScope Java Structured Concurrency Joiner allUntil 子任务异常 聚合异常
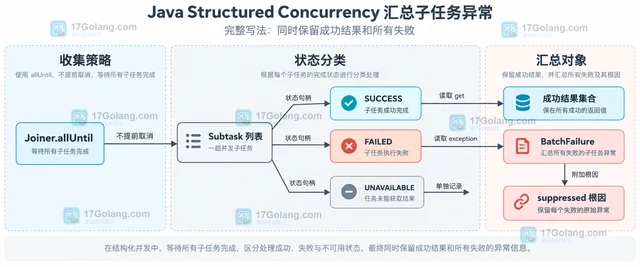
- Java Structured Concurrency 汇总子任务异常
- 260浏览 收藏
-
- 文章 · java教程 | 1天前 |
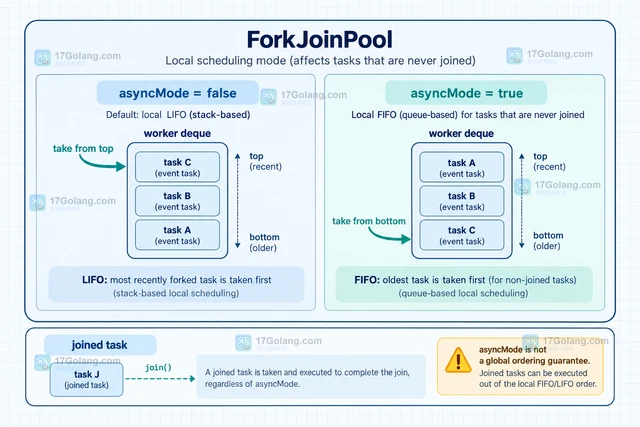
- Java ForkJoinPool asyncMode 调整任务队列顺序
- 121浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 429次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 507次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 520次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 463次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 291次使用
-
- Java try-with-resources 多个资源关闭顺序是什么
- 2026-09-10 501浏览
-
- 矩阵主副对角线快速定位技巧
- 2026-05-31 501浏览
-
- Java多态优化流程代码与行为分发改进
- 2026-05-26 501浏览
-
- JVM 类元数据双亲委派链表深度解析
- 2026-05-21 501浏览
-
- 反射异常处理:InvocationTargetException解析与应用
- 2026-05-16 501浏览


