
ZSTD字节数组压缩解压Java实现
2026-02-10 16:27:40
0浏览
收藏
文章小白一枚,正在不断学习积累知识,现将学习到的知识记录一下,也是将我的所得分享给大家!而今天这篇文章《ZSTD算法Java实现字节数组压缩解压》带大家来了解一下##content_title##,希望对大家的知识积累有所帮助,从而弥补自己的不足,助力实战开发!

本文详解如何在Java中正确使用ZSTD算法对字节数组进行压缩和解压缩,涵盖缓冲区大小动态计算、实际压缩/解压长度获取、结果截取等关键实践要点,并提供健壮、可直接复用的工具方法。
在Java中集成ZSTD(Zstandard)算法进行高性能无损压缩,需避免常见误区:不可预设固定缓冲区大小(如1024字节),也不可直接返回未截断的完整缓冲区数组——否则会导致压缩结果包含大量冗余零字节,或解压失败。核心在于利用ZSTD提供的元信息动态确定缓冲区容量,并精确提取真实有效数据。
✅ 正确做法:按需分配 + 精确截取
ZstdCompressor 提供 maxCompressedLength(int srcLen) 方法,可安全估算压缩后最大所需空间;而 compress() 和 decompress() 方法均返回实际写入字节数,这是截取有效结果的关键依据。
以下为生产环境推荐的完整实现(基于 LZ4/ZSTD Java bindings 库,Maven依赖:net.jpountz.lz4:lz4-java:1.8.0,该库同时支持ZSTD):
import net.jpountz.util.SafeUtils;
import net.jpountz.xxhash.XXHashFactory;
import net.jpountz.zstd.Zstd;
import java.util.Arrays;

public class ZstdUtil {

    // 压缩字节数组(自动计算缓冲区,返回紧凑结果)
    public static byte[] compressZstd(byte[] input) throws RuntimeException {
        if (input == null) throw new IllegalArgumentException("Input cannot be null");
        long maxCompressedSize = Zstd.maxCompressedSize(input.length);
        if (maxCompressedSize > Integer.MAX_VALUE) {
            throw new IllegalStateException("Input too large for JVM array");
        }
        byte[] compressedBuffer = new byte[(int) maxCompressedSize];
        int compressedSize = Zstd.compress(compressedBuffer, 0, compressedBuffer.length,
                                           input, 0, input.length);
        if (Zstd.isError(compressedSize)) {
            throw new RuntimeException("ZSTD compression failed: " + Zstd.getErrorName(compressedSize));
        }
        return Arrays.copyOf(compressedBuffer, compressedSize);
    }

    // 解压缩字节数组(需预先知晓原始大小,或使用带长度头的封装格式)
    public static byte[] decompressZstd(byte[] compressed, int originalSize) throws RuntimeException {
        if (compressed == null) throw new IllegalArgumentException("Compressed input cannot be null");
        byte[] decompressedBuffer = new byte[originalSize];
        int decompressedSize = Zstd.decompress(decompressedBuffer, 0, originalSize,
                                               compressed, 0, compressed.length);
        if (Zstd.isError(decompressedSize)) {
            throw new RuntimeException("ZSTD decompression failed: " + Zstd.getErrorName(decompressedSize));
        }
        if (decompressedSize != originalSize) {
            throw new IllegalStateException("Decompressed size mismatch: expected " + originalSize + ", got " + decompressedSize);
        }
        return decompressedBuffer;
    }

    // 进阶:自描述式解压(压缩流内嵌原始长度,更安全)
    public static byte[] compressZstdWithLength(byte[] input) {
        byte[] compressed = compressZstd(input);
        byte[] withLength = new byte[4 + compressed.length];
        // 写入原始长度(小端4字节)
        withLength[0] = (byte) (input.length & 0xFF);
        withLength[1] = (byte) ((input.length >> 8) & 0xFF);
        withLength[2] = (byte) ((input.length >> 16) & 0xFF);
        withLength[3] = (byte) ((input.length >> 24) & 0xFF);
        System.arraycopy(compressed, 0, withLength, 4, compressed.length);
        return withLength;
    }

    public static byte[] decompressZstdWithLength(byte[] compressedWithLength) {
        if (compressedWithLength.length < 4) {
            throw new IllegalArgumentException("Invalid compressed data: missing length header");
        }
        int originalSize = ((compressedWithLength[0] & 0xFF)
                          | ((compressedWithLength[1] & 0xFF) << 8)
                          | ((compressedWithLength[2] & 0xFF) << 16)
                          | ((compressedWithLength[3] & 0xFF) << 24));
        byte[] compressed = Arrays.copyOfRange(compressedWithLength, 4, compressedWithLength.length);
        return decompressZstd(compressed, originalSize);
    }
}
⚠️ 关键注意事项
- 缓冲区大小必须动态计算:Zstd.maxCompressedSize() 是安全上限,比硬编码(如1024)更可靠;解压时若原始大小未知,建议采用“长度头+压缩数据”的封装格式(如上述 compressZstdWithLength)。
- 务必检查返回值:Zstd.compress() / decompress() 返回负数即为错误码,需通过 Zstd.isError() 和 Zstd.getErrorName() 诊断。
- 内存安全:避免传入过大的输入(如 >2GB),防止 maxCompressedSize 超出 int 范围。
- 依赖版本:确保使用 lz4-java >= 1.8.0(支持ZSTD),旧版本不兼容。
通过以上实现,你将获得高吞吐、低延迟且零误用风险的ZSTD压缩能力,适用于日志归档、网络传输、序列化优化等典型场景。
今天关于《ZSTD字节数组压缩解压Java实现》的内容就介绍到这里了,是不是学起来一目了然!想要了解更多关于的内容请关注golang学习网公众号!
 PyCharm查找替换快捷键教程
- 上一篇
- PyCharm查找替换快捷键教程

- 下一篇
- 王者荣耀掉帧卡顿解决方法大全
查看更多
最新文章
-
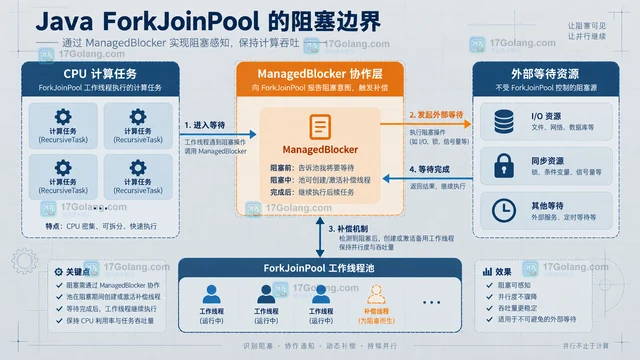
- 文章 · java教程 | 1天前 | 线程池 · Java教程 · java 并发编程 ForkJoinPool ForkJoinTask managedBlock ManagedBlocker
- Java ForkJoinPool managedBlock 怎样避免阻塞任务拖住并行计算
- 489浏览 收藏
-
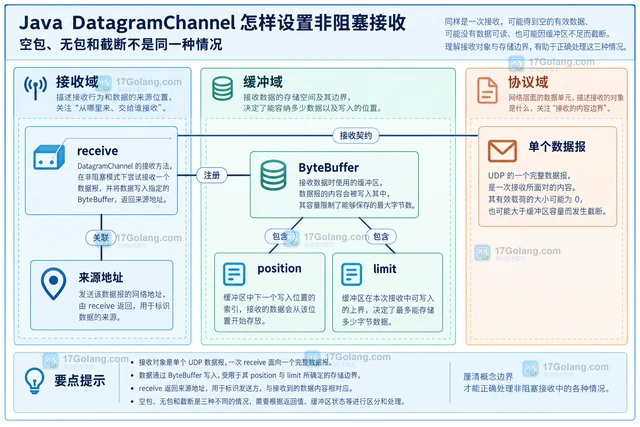
- 文章 · java教程 | 2天前 |
- Java DatagramChannel 怎样设置非阻塞接收
- 337浏览 收藏
-
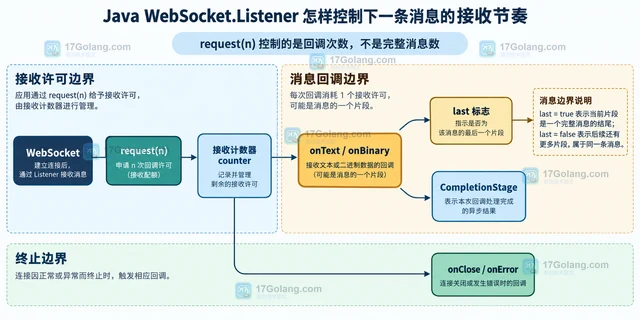
- 文章 · java教程 | 2天前 |
- Java WebSocket.Listener 怎样控制下一条消息的接收节奏
- 370浏览 收藏
-
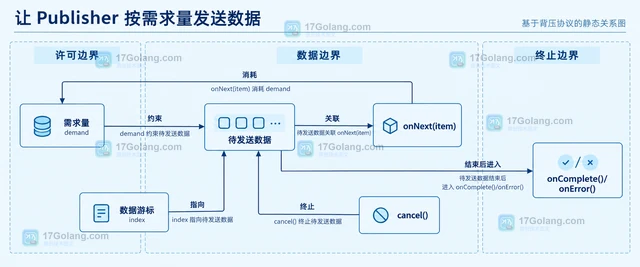
- 文章 · java教程 | 2天前 |
- Java Flow Publisher 怎样实现背压协议
- 339浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java CompletableFuture resultNow 怎样读取已完成结果
- 302浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java Foreign Function 怎样管理 MemorySegment 生命周期
- 259浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java switch pattern 怎样显式处理 null
- 220浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java 紧凑源文件怎样直接运行单文件程序
- 461浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java String.lines 怎样保留文本末尾的空行
- 337浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java WatchService 怎样处理 OVERFLOW 事件避免漏文件
- 360浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java String.stripIndent 怎样保留文本块的相对缩进
- 320浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java PathMatcher 怎样按 glob 规则筛选文件
- 246浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 498次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 558次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 584次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 537次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 348次使用
查看更多
相关文章
-
- Java try-with-resources 多个资源关闭顺序是什么
- 2026-09-10 501浏览
-
- 矩阵主副对角线快速定位技巧
- 2026-05-31 501浏览
-
- Java多态优化流程代码与行为分发改进
- 2026-05-26 501浏览
-
- JVM 类元数据双亲委派链表深度解析
- 2026-05-21 501浏览
-
- 反射异常处理:InvocationTargetException解析与应用
- 2026-05-16 501浏览