
SQLAlchemy插入或更新方法及行数返回
你在学习文章相关的知识吗?本文《SQLAlchemy 实现“插入或更新”并返回受影响行数的方法如下:1. 使用 insert + on_conflict_do_update在 SQLAlchemy 中,可以使用 insert().on_conflict_do_update() 来实现 “插入或更新” 的逻辑。这通常用于处理唯一约束冲突(如主键或唯一索引)。示例代码(使用 PostgreSQL):from sqlalchemy import insert, Table, MetaData, create_engine from sqlalchemy.dialects.postgresql import insert as pg_insert # 假设你已经有一个 engine 和 metadata engine = create_engine('postgresql://user:password@localhost/dbname') metadata = MetaData() table = Table('your_table', metadata, autoload_with=engine) # 构建插入语句 stmt = pg_insert(table).values( id=1, name='Test', value=100 ).on_conflict_do_update( index_elements=['id'], # 指定唯一索引字段 set_={ 'name': 'Updated', 'value': 200 } ) # 执行并获取影响的行数 with engine.connect() as conn: result = conn.execute(stmt) affected_rows = result.rowcount print(f"受影响行数:{affected_rows}")2. 使用 upsert 方法(适用于 SQLAlchemy 2》,主要介绍的内容就涉及到,如果你想提升自己的开发能力,就不要错过这篇文章,大家要知道编程理论基础和实战操作都是不可或缺的哦!
PostgreSQL 中 insert().on_conflict_do_update() 不返回行数,需用 RETURNING 子句配合 fetchall() 计数;MySQL 依赖 rowcount(需 exec_driver_sql);SQLite 用 changes();ORM 中避免 merge(),应使用 returning()。

SQLAlchemy 里 insert().on_conflict_do_update() 不返回行数
PostgreSQL 的 ON CONFLICT DO UPDATE 本身不直接返回“影响了多少行”,execute() 返回的 Result 对象默认也不暴露这个信息。你调用 result.rowcount 得到的往往是 -1(尤其在 psycopg2 异步或某些驱动配置下),不是真实受影响行数。
真正能拿到插入/更新行数的方式,是靠 RETURNING 子句 + 手动计数:
- 对 PostgreSQL:用
INSERT ... ON CONFLICT DO UPDATE RETURNING id,然后统计result.fetchall()长度 - 对 MySQL:原生不支持
ON DUPLICATE KEY UPDATE的RETURNING,得靠rowcount—— 但必须确保使用exec_driver_sql()或显式设置cursor.rowcount可用(如关闭连接池预处理) - 对 SQLite:
INSERT OR REPLACE后查connection.execute("SELECT changes()").scalar()
PostgreSQL 实操:用 RETURNING 精确统计
这是最可靠的方式,适用于需要区分“新插入”和“已存在但更新”的场景:
from sqlalchemy import textstmt = text(""" INSERT INTO users (id, name, email) VALUES (:id, :name, :email) ON CONFLICT (id) DO UPDATE SET name = EXCLUDED.name, email = EXCLUDED.email RETURNING id """) result = conn.execute(stmt, {"id": 123, "name": "Alice", "email": "a@b.com"}) affected_count = len(result.fetchall()) # ✅ 真实行数
注意点:
RETURNING必须指定至少一个列(哪怕只写RETURNING 1),否则fetchall()为空,长度为 0- 不能混用 ORM 模型对象直接传入
text();要用原生参数绑定 - 如果想同时知道是 insert 还是 update,可在
RETURNING里加伪列:RETURNING CASE WHEN xmax = 0 THEN 'insert' ELSE 'update' END(PostgreSQL 内部机制)
MySQL / SQLite 的兼容性取舍
MySQL 的 ON DUPLICATE KEY UPDATE 会把“插入”和“更新”都算作“受影响行数”,但 SQLAlchemy 默认不透出这个值:
- 用
exec_driver_sql()(SQLAlchemy 2.0+)可绕过 ORM 层限制:result = conn.exec_driver_sql("INSERT INTO t ... ON DUPLICATE KEY UPDATE ..."),之后result.rowcount通常可用 - SQLite 的
INSERT OR REPLACE本质是删+插,rowcount不稳定;推荐改用conn.exec_driver_sql("SELECT changes()").scalar()获取最后操作变更行数 - 跨数据库抽象时,别依赖
rowcount—— 它在不同方言、不同执行模式(如 execute vs executemany)下行为差异极大
ORM 层怎么写?别用 merge()
session.merge() 看似符合“插入或更新”语义,但它内部是先 SELECT 再决定 insert/update,无法原子化,且 rowcount 总是 1(不管实际是否写入)。
真要走 ORM 路线,只能手动控制:
- 用
session.execute(insert(...).on_conflict_do_update(...).returning(...))(SQLAlchemy 2.0+ 支持) - 避免混合 ORM 实例和原生语句;一旦用了
RETURNING,就老实用字典或元组接收结果 - 别指望
session.commit()后从 session 缓存里反推影响行数——缓存不记录底层 DML 统计
最易被忽略的是:RETURNING 在 PostgreSQL 中要求目标表有主键或唯一约束才能触发 ON CONFLICT,否则语法报错;而 MySQL 的 ON DUPLICATE KEY UPDATE 则强制依赖已有 UNIQUE/PRIMARY KEY 索引 —— 约束缺失时,所谓“插入或更新”会静默变成纯插入,且无提示。
终于介绍完啦!小伙伴们,这篇关于《SQLAlchemy插入或更新方法及行数返回》的介绍应该让你收获多多了吧!欢迎大家收藏或分享给更多需要学习的朋友吧~golang学习网公众号也会发布文章相关知识,快来关注吧!
 CSS多列布局:媒体查询与Flex结合技巧
- 上一篇
- CSS多列布局:媒体查询与Flex结合技巧

- 下一篇
- 咪咕快游官网入口及游戏大厅详解
-
- 文章 · python教程 | 54分钟前 |
- Python singledispatchmethod 在继承类中为什么没有命中重载
- 362浏览 收藏
-
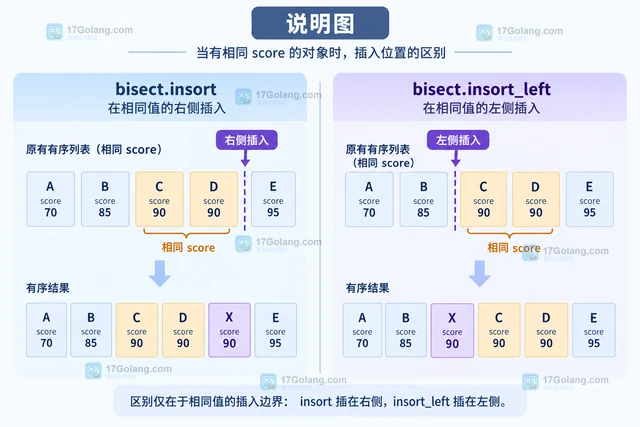
- 文章 · python教程 | 58分钟前 | Python bisect bisect_left bisect_right 重复分数
- Python bisect 查找重复分数时怎么定位区间
- 118浏览 收藏
-
- 文章 · python教程 | 3小时前 | python · Python 异常传播 函数装饰器 contextlib.ContextDecorator with
- Python ContextDecorator 同时支持 with 与函数装饰器的实现边界
- 242浏览 收藏
-
- 文章 · python教程 | 3小时前 | 文件处理 · python · 异常排查 · Python 工作目录 异常恢复 contextlib.chdir
- Python contextlib.chdir 临时切换目录后如何保证异常恢复
- 158浏览 收藏
-
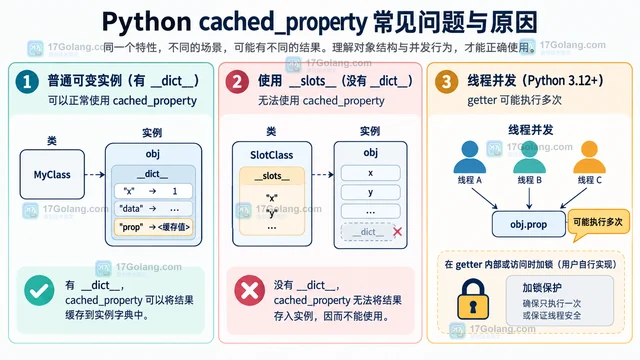
- 文章 · python教程 | 3小时前 | 缓存 · python · Python 缓存失效 实例属性 __dict__ functools.cached_property
- Python functools.cached_property 删除属性后如何强制刷新缓存
- 463浏览 收藏
-
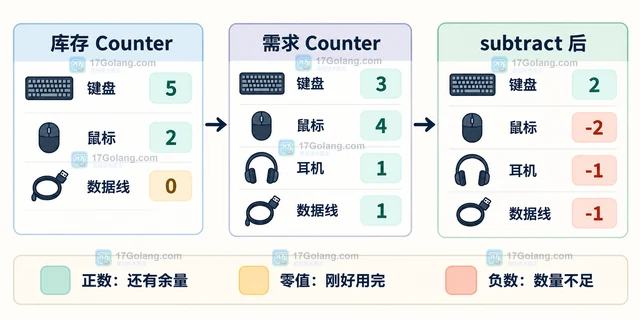
- 文章 · python教程 | 3小时前 | 标准库 · python · 数据处理 · 问题排查 · collections.Counter 库存扣减 Python Counter.subtract 缺失项目 负计数
- Python Counter.subtract 后怎么判断真正缺失的项目
- 410浏览 收藏
-
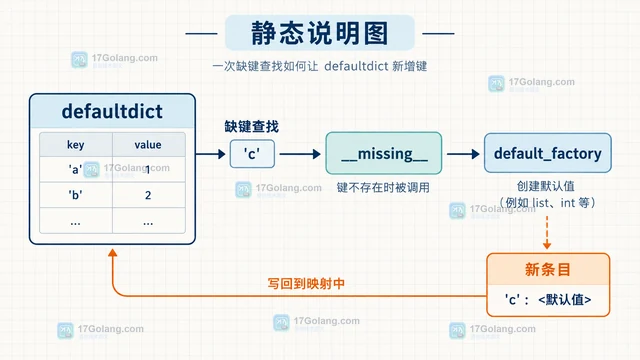
- 文章 · python教程 | 3小时前 | python ·
- Python defaultdict 访问缺省键为什么会改变字典内容
- 482浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 457次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 521次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 536次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 484次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 306次使用
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览


