
Java集合性能优化技巧详解
大家好,今天本人给大家带来文章《Java集合类与性能优化技巧》,文中内容主要涉及到,如果你对文章方面的知识点感兴趣,那就请各位朋友继续看下去吧~希望能真正帮到你们,谢谢!
ArrayList尾插均摊O(1),LinkedList头/尾插严格O(1)但内存开销大、缓存不友好;随机访问ArrayList为O(1),LinkedList为O(n);实际性能受JVM优化、GC及CPU缓存影响显著。

ArrayList 和 LinkedList 插入性能差异在哪
在尾部插入元素时,ArrayList 通常比 LinkedList 快;但在中间或头部频繁插入,LinkedList 的常数时间优势才可能体现——前提是没触发 ArrayList 的扩容,且你真的在用 Iterator.add() 或 ListIterator 做随机位置插入。
常见错误是以为“链表插入快”就无脑选 LinkedList,结果发现 list.add(0, item) 在 ArrayList 上是 O(n),在 LinkedList 上也是 O(n)(因为要先遍历到索引 0?不,那是 get(0);但 add(0, ...) 确实是 O(1),因为头插直接改头指针)。可实际中,JVM 对 ArrayList 的连续内存访问高度优化,而 LinkedList 每次 new Node() 带 GC 压力,对象引用跳转还破坏 CPU 缓存局部性。
ArrayList尾插:均摊 O(1),扩容时触发数组复制(O(n)),但扩容策略是 1.5 倍增长,摊还代价可控LinkedList头插/尾插:严格 O(1),但每个元素多两个引用字段(8~16 字节),内存占用翻倍以上- 用
list.get(i)随机访问:前者 O(1),后者 O(n),哪怕 i=0 —— 因为LinkedList.get()内部仍要从头或尾开始遍历
HashMap 初始化容量与负载因子怎么设才不浪费
默认构造 new HashMap() 会用初始容量 16、负载因子 0.75,意味着第 13 个键值对插入时触发扩容。如果预估要存 1000 个元素,直接写 new HashMap(1024) 或 new HashMap(1280)(向上取最近的 2 的幂 × 1.25)更省事;硬算的话,用 (int) Math.ceil(expectedSize / 0.75) 再 round up 到 2 的幂。
负载因子不是越小越好:设成 0.5 能减少哈希冲突,但空间利用率腰斩,且扩容更频繁;设成 0.9 容易导致链表过长(Java 8+ 在桶中节点数 ≥ 8 且 table.length ≥ 64 才树化),反而增加查找开销。
- 若 key 是字符串且长度短、取值范围小(如状态码 "OK", "ERR"),哈希分布可能极不均匀,优先考虑重写
hashCode()或换IdentityHashMap - 并发场景别用
HashMap加 synchronized 块,ConcurrentHashMap的分段锁(Java 7)或 CAS + synchronized 桶(Java 8+)更可靠 - Java 8 中,单个桶内链表转红黑树的阈值是 8,但前提是 table.length ≥ 64;否则先扩容,避免过早树化带来的额外内存和维护成本
HashSet、TreeSet、LinkedHashSet 各自不可替代的场景
HashSet 底层是 HashMap,插入/查找平均 O(1),但不保证顺序;TreeSet 用红黑树,自动排序,操作 O(log n),适合需要范围查询(如 subSet(from, to))或天然有序输出的场景;LinkedHashSet 是带插入顺序的 HashSet,迭代性能接近 HashSet,但内存多一个双向链表指针,适合需去重+保序(如解析 CSV 表头、缓存最近请求 URL)。
容易踩的坑:把 TreeSet 当普通集合用,却忘了它的 add() 是 O(log n) 而非 O(1),在高频写入场景下吞吐骤降;或者误以为 LinkedHashSet 迭代是“按访问顺序”,其实它是插入顺序,LRU 需要用 LinkedHashMap 并重写 removeEldestEntry()。
TreeSet要求元素实现Comparable或传入Comparator,null 元素在自然排序下会抛NullPointerExceptionLinkedHashSet的迭代顺序稳定,但序列化后反序列化仍保持该顺序——这点比靠ArrayList+ 手动去重更可靠- 如果只是临时去重再转回 list,用
new ArrayList(new LinkedHashSet(list))比流式list.stream().distinct().collect(...)更快,后者在小数据量下有明显函数式开销
Stream.collect(Collectors.toMap()) 的并发陷阱
用 Collectors.toMap() 转换 List 到 Map 时,若原始数据含重复 key,默认抛 IllegalStateException;加 merge 函数可解决,但并发流(.parallelStream())下,merge 行为不可预测——多个线程可能同时尝试合并同一 key,导致结果取决于竞态时序。
真正安全的并发 map 构建方式是:先用 parallelStream().collect(Collectors.groupingByConcurrent()) 得到 ConcurrentMap,再按需转换;或者干脆用 ConcurrentHashMap + computeIfAbsent() 手动构建。
toMap()的 value mapper 函数若抛异常,整个 collect 会中断,不会部分成功- key 冲突时传的
(v1, v2) -> v1看似简单,但在 parallelStream 中无法保证“先出现的胜出”,因为分段处理后合并阶段才 resolve 冲突 - 如果 value 是复杂对象且需深拷贝,别在 value mapper 里做 clone,应在收集后统一处理;否则并行流中重复 clone 浪费 CPU
集合性能优化的复杂点不在公式计算,而在理解 JVM 内存布局、CPU 缓存行为和具体 JDK 版本的实现细节——比如 Java 21 的 SequenceCollection 预览特性,或不同 GC 算法下对象分配速度对 LinkedList 节点创建的影响。这些没法靠背 API 解决。
好了,本文到此结束,带大家了解了《Java集合性能优化技巧详解》,希望本文对你有所帮助!关注golang学习网公众号,给大家分享更多文章知识!
 飞书登录异常解决与安全优化方法
- 上一篇
- 飞书登录异常解决与安全优化方法

- 下一篇
- 阻止默认事件方法全解析
-
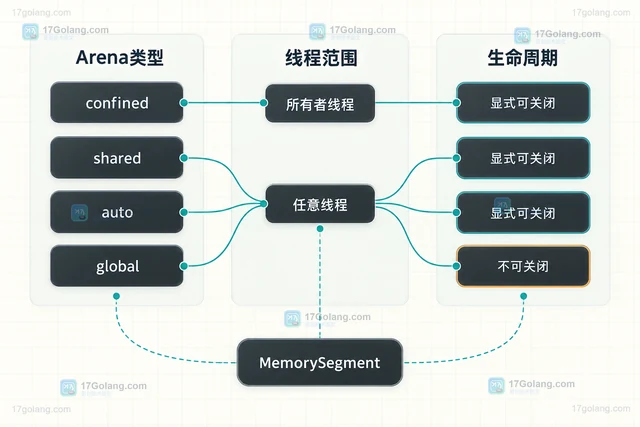
- 文章 · java教程 | 1小时前 | 并发编程 · Java教程 · java arena MemorySegment WrongThreadException FFM API
- Java MemorySegment 怎么限制跨线程访问范围
- 132浏览 收藏
-
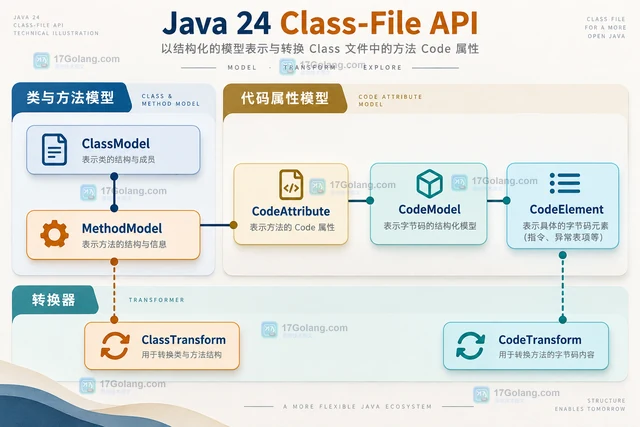
- 文章 · java教程 | 4小时前 | Java · Java 24 Java Class-File API CodeTransform ClassTransform CodeAttribute
- Java Class-File API 怎么转换方法代码属性
- 199浏览 收藏
-
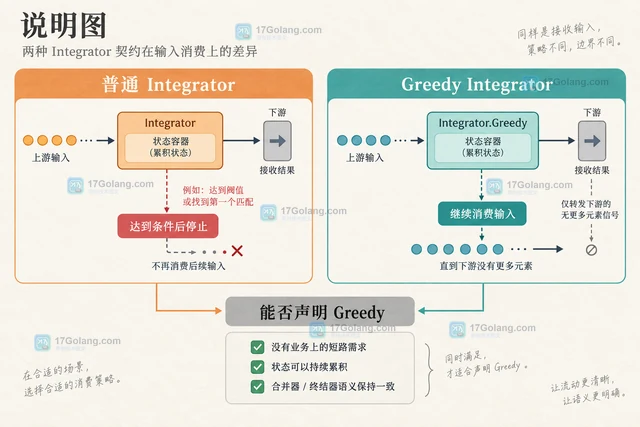
- 文章 · java教程 | 6小时前 | Java · Stream · java Stream Gatherer Integrator.Greedy
- Java Gatherer Integrator.Greedy 什么时候可以声明贪婪处理
- 112浏览 收藏
-
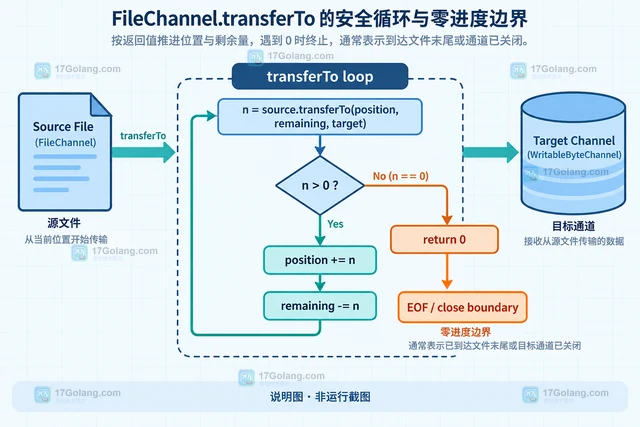
- 文章 · java教程 | 8小时前 |
- Java FileChannel transferTo 为什么可能只传输部分字节
- 229浏览 收藏
-
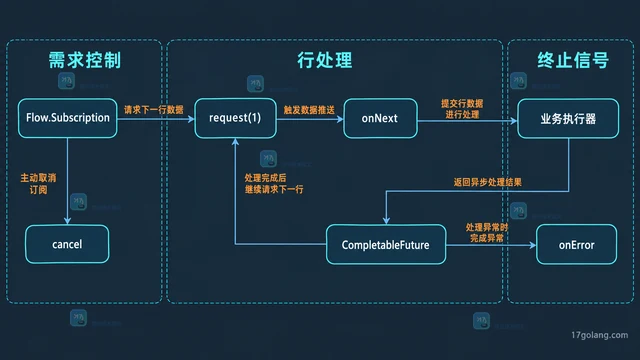
- 文章 · java教程 | 10小时前 | Java · 异步编程 · Java HttpClient BodyHandlers.fromLineSubscriber Flow.Subscriber 异步响应 按行消费
- Java HttpClient 怎么把响应体按行异步消费
- 433浏览 收藏
-
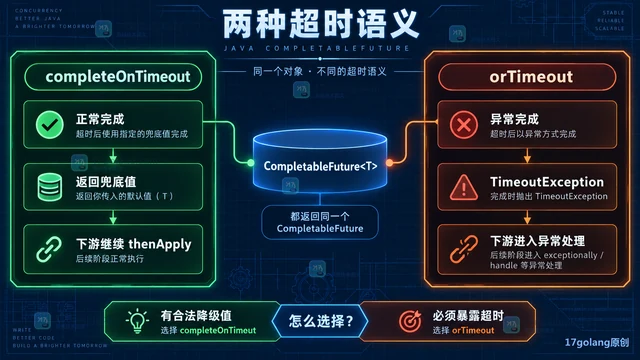
- 文章 · java教程 | 12小时前 | 并发 · 超时控制 · 异步编程 · Java教程 · CompletableFuture · java completablefuture TimeoutException orTimeout completeOnTimeout
- Java completeOnTimeout 和 orTimeout 怎么选择
- 152浏览 收藏
-
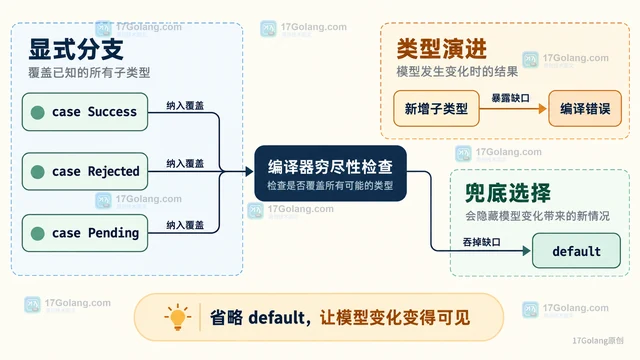
- 文章 · java教程 | 20小时前 | Java · Switch · Java 21 switch模式匹配 sealed 穷尽性
- Java switch 模式匹配怎么处理密封类型的穷尽性
- 413浏览 收藏
-
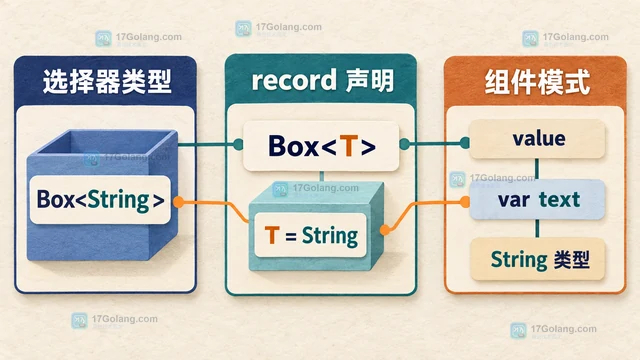
- 文章 · java教程 | 1天前 | Java · 泛型 · 模式匹配 Java 21 Java record pattern 泛型记录模式 组件类型推断
- Java 泛型 record pattern 怎么推断组件类型
- 357浏览 收藏
-
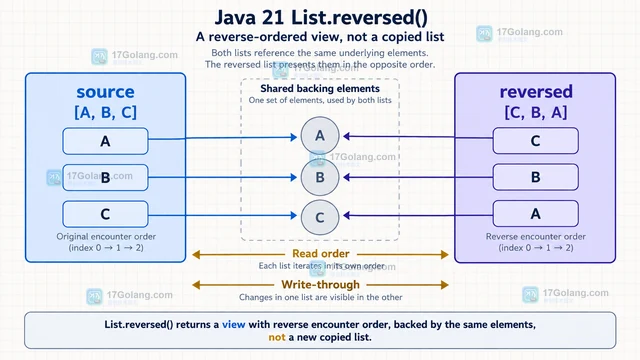
- 文章 · java教程 | 1天前 | Java · List · 集合 · list Java 21 SequencedCollection reversed
- Java reversed 视图上的修改会不会影响原集合
- 105浏览 收藏
-
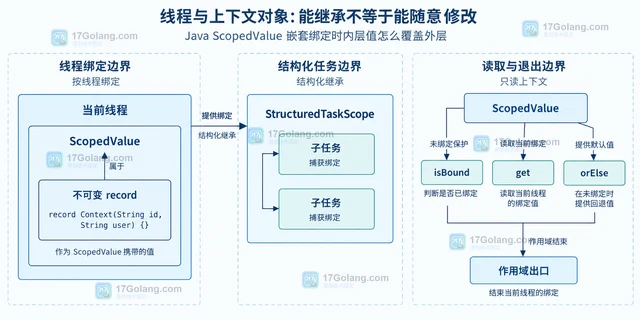
- 文章 · java教程 | 1天前 |
- Java ScopedValue 嵌套绑定时内层值怎么覆盖外层
- 104浏览 收藏
-
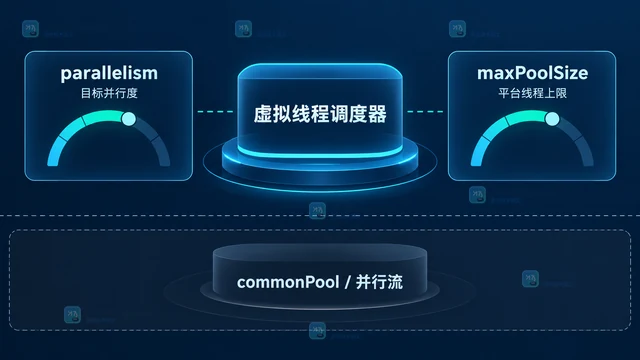
- 文章 · java教程 | 1天前 | Java · 并发编程 · 虚拟线程 · Java虚拟线程 ForkJoinPool Virtual Threads 调度器并行度 jdk.virtualThreadScheduler.parallelism
- Java 虚拟线程调度器并行度怎么单独配置
- 459浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 356次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 416次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 424次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 378次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 201次使用
-
- Java try-with-resources 多个资源关闭顺序是什么
- 2026-09-10 501浏览
-
- 矩阵主副对角线快速定位技巧
- 2026-05-31 501浏览
-
- Java多态优化流程代码与行为分发改进
- 2026-05-26 501浏览
-
- JVM 类元数据双亲委派链表深度解析
- 2026-05-21 501浏览
-
- 反射异常处理:InvocationTargetException解析与应用
- 2026-05-16 501浏览


