
Python高效特征抽取技巧详解
2025-12-27 20:48:49
0浏览
收藏
在文章实战开发的过程中,我们经常会遇到一些这样那样的问题,然后要卡好半天,等问题解决了才发现原来一些细节知识点还是没有掌握好。今天golang学习网就整理分享《Python大规模特征抽取技巧全解析》,聊聊,希望可以帮助到正在努力赚钱的你。
大规模特征抽取的核心是分层处理以用更少资源覆盖更多信号:清洗→结构化→高阶构造→筛选压缩;文本特征需轻量预处理、限词表、用HashingVectorizer;类别特征对高基数字段应频次截断+TargetEncoder或哈希分桶;时序特征按业务节奏提取多粒度时间特征与自然日聚合;特征筛选用互信息或排列重要性,存储改用parquet/feather并加前缀。

大规模特征抽取的核心思路
大规模特征抽取不是堆砌更多特征,而是用更少计算资源覆盖更多业务信号。关键在“分层处理”:原始数据清洗 → 结构化特征生成 → 高阶特征构造 → 特征筛选压缩。尤其当样本超千万、字段上百时,盲目用sklearn.Pipeline套所有步骤,容易内存爆炸或训练卡死。
文本类特征:别急着TF-IDF,先做轻量预处理
面对海量日志、评论、商品标题,直接调TfidfVectorizer会把稀疏矩阵撑爆内存。建议分三步走:
- 用pandas.Series.str.replace批量清理噪声(如URL、重复标点、控制字符),比正则逐行快5–10倍
- 限制词表大小:max_features=50000 + min_df=10(过滤低频词),避免百万级无意义n-gram
- 改用HashingVectorizer替代TF-IDF——不存词汇表,固定维度,适合分布式或流式场景
类别型特征:高基数字段要“降维+编码”双管齐下
用户ID、商品SKU、IP地址这类字段动辄几十万唯一值,OneHotEncoder直接报错。实用解法:
- 统计频次,保留Top N(如前1000)高频值,其余归为“other”再one-hot
- 用TargetEncoder(需防数据泄露!训练集内k折平滑)替代LabelEncoder,对点击率、转化率等目标敏感的场景更稳定
- 对超长ID,可截取后4位+MD5取模(如hash(sku) % 64)做哈希分桶,再嵌入或one-hot,兼顾泛化与内存
时间与序列特征:按业务节奏提取,拒绝硬切窗口
订单/行为日志含强时序性,但“过去7天均值”这种固定窗口常忽略业务周期。更有效做法:
- 提取多粒度时间特征:小时段(是否晚高峰)、星期几(周末效应)、距节假日天数(大促前置行为)
- 用pd.Grouper(key='ts', freq='D')按自然日聚合,而非rolling(7)——避免跨月/跨年计算偏差
- 对用户行为序列,优先用aggregation + shift(如“上一次下单间隔小时数”),比LSTM类模型轻量且可解释
特征筛选与存储:省掉90%无效特征的关键动作
特征越多≠效果越好。上线前务必做两件事:
- 用SelectKBest(score_func=mutual_info_classif)或PermutationImportance(树模型后)筛掉低信息量特征,通常能砍掉30–60%冗余列
- 存储不用pickle——改用parquet(支持列裁剪、压缩比高)或feather(内存映射快),读取速度提升3–5倍
- 特征名加前缀(如usr__age_bucket、item__price_log),方便后续pipeline定位和AB实验分流
好了,本文到此结束,带大家了解了《Python高效特征抽取技巧详解》,希望本文对你有所帮助!关注golang学习网公众号,给大家分享更多文章知识!
 QQ邮箱改密码方法及安全建议
- 上一篇
- QQ邮箱改密码方法及安全建议

- 下一篇
- Win10NTFS.sys蓝屏怎么解决
查看更多
最新文章
-
- 文章 · python教程 | 2小时前 |
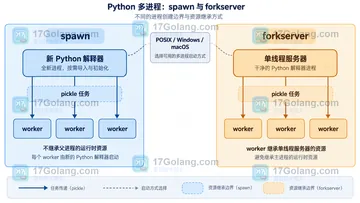
- Python multiprocessing forkserver 何时比 spawn 合适
- 271浏览 收藏
-
- 文章 · python教程 | 3小时前 |
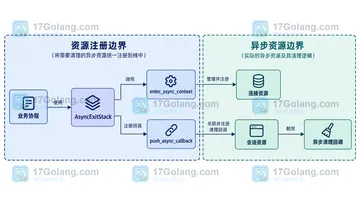
- Python contextlib.AsyncExitStack 如何清理异步资源
- 369浏览 收藏
-
- 文章 · python教程 | 4小时前 |
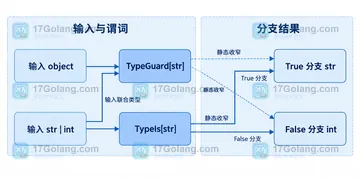
- Python typing.TypeGuard 和 TypeIs 的收窄差异
- 295浏览 收藏
-
- 文章 · python教程 | 9小时前 | csv · python · DictWriter ·
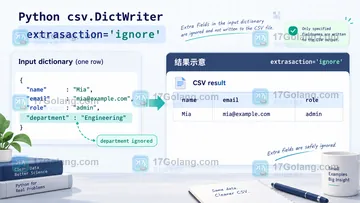
- Python csv.DictWriter 缺少字段时如何设置 extrasaction
- 274浏览 收藏
-
- 文章 · python教程 | 10小时前 |
- Python pathlib Path.resolve 遇到不存在路径如何处理
- 278浏览 收藏
-
- 文章 · python教程 | 11小时前 |
- Python asyncio.timeout_at 如何用绝对截止时间包住任务
- 470浏览 收藏
-
- 文章 · python教程 | 13小时前 | 异常处理 · Python教程 · 兼容性 · ExceptionGroup · contextlib · ExceptionGroup Python contextlib.suppress BaseExceptionGroup except*
- Python contextlib.suppress 能否处理 ExceptionGroup 中的部分异常
- 431浏览 收藏
-
- 文章 · python教程 | 15小时前 | 资源管理 · python · memoryview · 缓冲区协议 · 性能编程 · Python memoryview memoryview.release Python 缓冲区协议 bytearray BufferError mmap 资源释放
- Python memoryview 使用后如何释放底层资源
- 275浏览 收藏
-
- 文章 · python教程 | 16小时前 |
- Python array 类型码不匹配时怎样安全转换数值
- 311浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 33次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 135次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 72次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 28次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 18次使用
查看更多
相关文章
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览


