
自然语言处理项目模型调优的核心实现方案【教程】
知识点掌握了,还需要不断练习才能熟练运用。下面golang学习网给大家带来一个文章开发实战,手把手教大家学习《自然语言处理项目模型调优的核心实现方案【教程】》,在实现功能的过程中也带大家重新温习相关知识点,温故而知新,回头看看说不定又有不一样的感悟!
模型调优是围绕数据、特征、结构和训练四主线系统性做减法与校准,目标为真实场景中稳定、轻量、可解释。数据重清理与定向增强;特征分阶段验证;结构优先剪枝冻结;训练关注指标分布而非仅loss。
模型调优不是“多试几个超参”,而是围绕数据、特征、结构和训练过程四条主线系统性地做减法与校准——目标是让模型在真实场景中稳定、轻量、可解释地工作。
数据层面:先清理,再增强,不盲目扩量
多数性能瓶颈其实来自数据噪声或分布偏移。重点检查三类问题:标签不一致(如同一类样本被标成不同ID)、文本预处理不统一(繁简混用、空格/换行残留)、长尾类别样本过少但强行 oversample 导致过拟合。
建议操作:
- 用 spaCy 或 jieba 对原始文本做标准化分词+停用词过滤,再统计词频-逆文档频(TF-IDF)热力图,快速定位异常高频噪声词(如乱码、广告短语)
- 对少于5条的类别,不直接复制粘贴增强,改用回译(Chinese → English → Chinese)+ 同义词替换(基于同义词词林或 WordNet)生成语义合理的新样本
- 划分验证集时按“时间戳”或“来源域”切分,而非随机打乱,避免训练集泄露未来信息或跨平台偏差
特征工程:从规则到嵌入,分阶段验证有效性
别一上来就上 BERT。先用传统特征锚定基线:字符 n-gram(尤其对短文本分类有效)、句法依存路径(用于关系抽取)、领域关键词匹配得分(可用 TF-IDF 加权求和)。这些特征计算快、可解释强,能帮你快速判断任务本质是否适合深度学习。
建议操作:
- 把原始文本 + 规则特征(如“是否含疑问词”、“句末标点类型”)一起输入浅层 MLP,若 F1 提升超过 3%,说明规则信号强,后续微调预训练模型时可将这些特征作为额外输入通道
- 用 Sentence-BERT 得到句向量后,不做直接拼接,先用 PCA 降到 64 维,再通过 t-SNE 可视化验证聚类边界是否与业务逻辑一致(比如客服投诉应天然聚成几簇,而非均匀散落)
模型结构:剪枝比加宽更有效,冻结比重训更稳妥
在资源受限或上线延迟敏感的场景下,“小而准”优于“大而全”。BERT-base 有 12 层,但实际任务常只需前6–8层就能捕获足够语义;中文任务中,底层更关注字粒度,顶层偏向句法与语义整合,可针对性保留。
建议操作:
- 用 torch-pruning 工具对 Hugging Face 模型做结构化剪枝:按注意力头重要性排序,逐层裁掉 bottom-20% 的 head,再微调 1–2 轮,参数量降 15% 通常不影响精度
- 下游任务微调时,先冻结全部 transformer 层(只训 classifier head),待 loss 稳定后再解冻最后2层,用 1/5 原始学习率继续训练——避免底层表征被破坏
- 部署前用 ONNX Runtime 转换模型,并开启 FP16 推理,实测在 CPU 上提速 1.8–2.3 倍,显存占用下降约 40%
训练策略:早停看趋势,梯度看分布,不只盯 loss
loss 下降≠模型变好。重点关注验证集上各类别的 precision/recall 平衡、预测置信度分布(理想情况应呈双峰:高置信正例 + 高置信负例,中间低置信区越窄越好)、以及梯度范数变化曲线(突增往往意味着 batch 内样本冲突或标签错误)。
建议操作:
- 早停条件设为“连续3轮 val_f1 无提升且 confidence_gap(正负例平均置信差)缩小”,比单纯看 f1 更鲁棒
- 每100步记录一次各层梯度 L2 范数,用 matplotlib 绘制热力图;若某几层梯度长期接近 0,说明该部分未被有效激活,可考虑替换为适配器(Adapter)结构替代全参数微调
- 用 Weights & Biases 或 TensorBoard 记录 learning rate、grad_norm、label_entropy(batch 内标签信息熵),三者联动分析训练健康度
基本上就这些。调优不是炫技,是不断问自己:这个改动是否解决了我真正卡住的问题?有没有更轻、更稳、更容易说清原因的替代方案?
终于介绍完啦!小伙伴们,这篇关于《自然语言处理项目模型调优的核心实现方案【教程】》的介绍应该让你收获多多了吧!欢迎大家收藏或分享给更多需要学习的朋友吧~golang学习网公众号也会发布文章相关知识,快来关注吧!
 麦克风有回音或啸叫怎么办 调整麦克风音量并开启降噪功能【消除】
- 上一篇
- 麦克风有回音或啸叫怎么办 调整麦克风音量并开启降噪功能【消除】
- 下一篇
- 包子漫画免费下载_包子漫画免费下载官方无广告阅读更畅快
-
- 文章 · python教程 | 1小时前 |
- Python logging Formatter 统一结构化字段输出
- 185浏览 收藏
-
- 文章 · python教程 | 2小时前 | 配置 · python · Python教程 · 配置管理 Python 3.15 frozendict 不可变映射
- Python 3.15 frozendict 内置类型的配置使用场景
- 192浏览 收藏
-
- 文章 · python教程 | 5小时前 | 序列化 · python · Python pickle 进程池 multiprocessing Pool
- Python multiprocessing 进程池传递不可序列化对象
- 255浏览 收藏
-
- 文章 · python教程 | 6小时前 | 数据一致性 · Python教程 · Python 事务 自动提交 sqlite3 autocommit isolation_level
- Python sqlite3 事务模式与自动提交边界
- 197浏览 收藏
-
- 文章 · python教程 | 7小时前 |
- Python contextlib.nullcontext 统一同步异步入口
- 316浏览 收藏
-
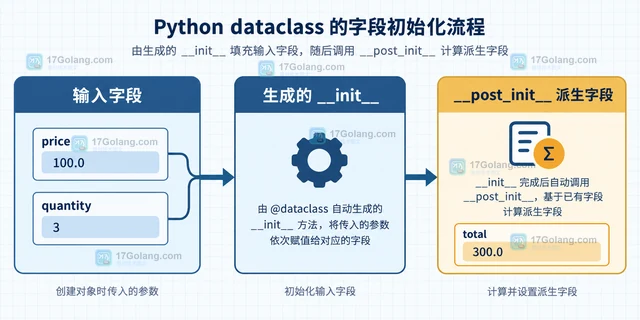
- 文章 · python教程 | 8小时前 | 面向对象 · python · Python教程 · InitVar __post_init__ Python dataclass 派生字段 field(init=False)
- Python dataclass __post_init__ 计算派生字段
- 303浏览 收藏
-
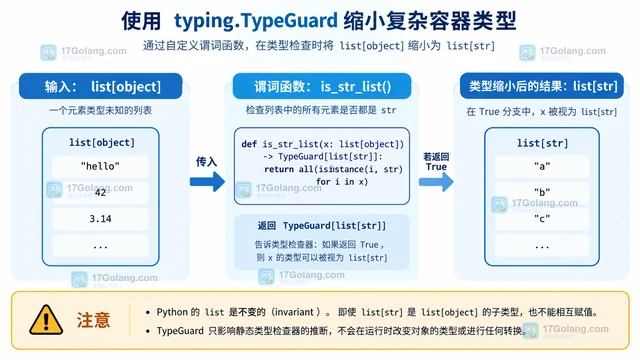
- 文章 · python教程 | 9小时前 |
- Python typing.TypeGuard 处理复杂容器类型收窄
- 437浏览 收藏
-
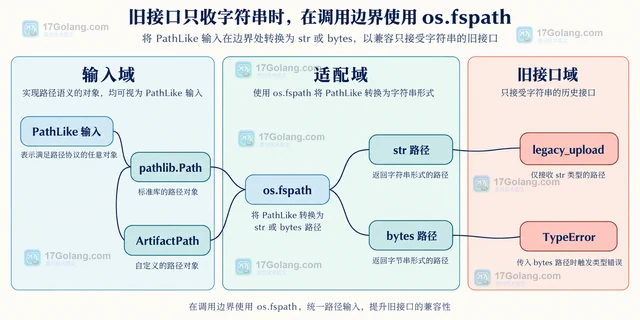
- 文章 · python教程 | 10小时前 |
- Python os.fspath 支持自定义路径对象
- 214浏览 收藏
-
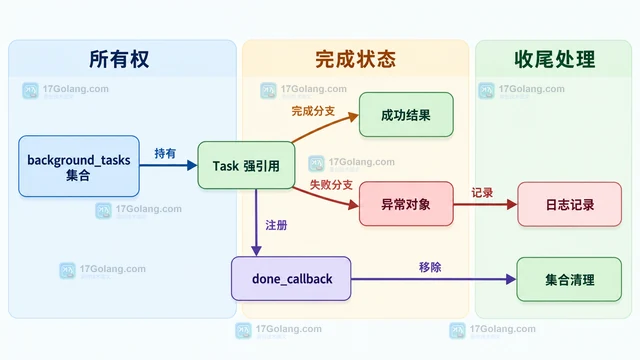
- 文章 · python教程 | 13小时前 | 异常处理 · 异步编程 · Python教程 · asyncio · 后台任务 任务取消 CancelledError Python asyncio asyncio.shield
- Python asyncio.shield 保护后台任务免受外层取消
- 407浏览 收藏
-
- 文章 · python教程 | 15小时前 |
- Python configparser ExtendedInterpolation 组织分层配置
- 480浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 409次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 487次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 495次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 443次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 271次使用
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览


