
Mongoose高效字符串匹配与过滤技巧
小伙伴们对文章编程感兴趣吗?是否正在学习相关知识点?如果是,那么本文《Mongoose聚合管道高效字符串匹配与过滤技巧》,就很适合你,本篇文章讲解的知识点主要包括。在之后的文章中也会多多分享相关知识点,希望对大家的知识积累有所帮助!

本文详细介绍了在Mongoose聚合管道中,如何利用`$match`操作符结合`$regex`实现对分组(grouped)数据进行高效、大小写不敏感的字符串匹配与过滤。通过将过滤逻辑集成到数据库层,避免了客户端处理的性能开销,提供了清晰的示例代码和最佳实践,帮助开发者优化Mongoose查询性能。
在构建现代Web应用程序时,搜索功能是不可或缺的一部分。当数据量庞大且需要对聚合后的结果进行进一步筛选时,如何高效地在数据库层面完成这一操作,而不是将所有数据拉取到应用层再进行处理,成为了一个关键的性能优化点。Mongoose的聚合管道(Aggregation Pipeline)提供了强大的工具来解决这类问题。
传统方法的问题
在处理聚合后的数据进行字符串匹配时,一种常见的初步尝试是先完成数据库的聚合操作,然后将结果返回到应用层,在JavaScript代码中使用filter等数组方法进行筛选。例如,原始问题中展示的代码:
const uniqueQuoteAuthors = await QuoteModel.aggregate().group({
  _id: "$author",
  count: { $sum: 1 },
});

const filteredData = await uniqueQuoteAuthors.filter((value) => {
  return value._id.toLowerCase().includes(searchWord.toLowerCase());
});
这种方法虽然能实现功能,但存在显著的性能瓶颈。当uniqueQuoteAuthors数组非常大时,将其全部从数据库传输到应用服务器,并在服务器内存中进行遍历筛选,会消耗大量的网络带宽、内存和CPU资源。这在生产环境中是不可接受的。
Mongoose聚合管道解决方案:$match与$regex
为了解决上述问题,我们应该将过滤逻辑直接集成到Mongoose的聚合管道中。MongoDB提供了$match操作符用于过滤文档,而$regex操作符则用于实现强大的正则表达式匹配。结合这两个操作符,我们可以在聚合流程的早期或中期阶段就剔除不符合条件的文档,从而大大减少后续处理的数据量。
核心概念解析
$match操作符: $match阶段用于根据指定的查询条件过滤文档。它位于聚合管道的任何阶段,可以像find()方法一样使用标准的MongoDB查询语法。将其放置在$group之后,可以对$group阶段产生的文档进行过滤。
$regex查询操作符: $regex操作符允许您使用正则表达式来匹配字符串字段。它是实现模糊搜索和复杂模式匹配的关键。
$options: 'i'实现大小写不敏感: 在$regex操作符中,$options: 'i'是一个非常实用的选项。它指示MongoDB执行大小写不敏感的匹配。这意味着无论搜索词是大写、小写还是混合大小写,都能匹配到对应的结果,极大地提升了用户体验。
实战案例:在分组结果中搜索
假设我们有一个QuoteModel,其中包含author字段,我们希望统计每位作者的引用次数,并在这些作者中搜索包含特定字符串的作者名。
首先,定义Mongoose模型和一些示例数据:
import mongoose from 'mongoose';

// 假设配置已加载
const MONGODB_URI = 'mongodb://localhost:27017/mydatabase'; // 替换为你的MongoDB URI

// 定义Schema和Model
const quoteSchema = new mongoose.Schema({
    author: String,
    quote: String, // 假设还有引用内容
});
const QuoteModel = mongoose.model('quote', quoteSchema);

// 辅助函数:连接数据库
async function connectDB() {
    if (mongoose.connection.readyState === 0) {
        await mongoose.connect(MONGODB_URI);
        console.log('MongoDB connected.');
    }
}

// 辅助函数:断开数据库
async function disconnectDB() {
    if (mongoose.connection.readyState === 1) {
        await mongoose.connection.close();
        console.log('MongoDB disconnected.');
    }
}

// 辅助函数:清空并填充数据
async function seedData() {
    await QuoteModel.collection.drop().catch(() => console.log('Collection not found, skipping drop.')); // 忽略collection不存在的错误
    await QuoteModel.create([
        { author: 'Nick', quote: 'Quote 1' },
        { author: 'nick', quote: 'Quote 2' }, // 测试大小写
        { author: 'Jack', quote: 'Quote 3' },
        { author: 'John', quote: 'Quote 4' },
        { author: 'Alex', quote: 'Quote 5' },
        { author: 'Nick', quote: 'Quote 6' },
        { author: 'jack', quote: 'Quote 7' }, // 测试大小写
    ]);
    console.log('Data seeded.');
}
现在,我们将搜索逻辑集成到聚合管道中:
async function getQuoteAuthorSearchedResult(searchWord) {
    try {
        await connectDB();
        await seedData(); // 每次运行时清空并填充数据,方便测试

        console.log(`Searching for authors containing: "${searchWord}"`);

        const uniqueQuoteAuthors = await QuoteModel.aggregate()
            .group({
                _id: '$author', // 按作者名分组
                count: { $sum: 1 }, // 计算每个作者的引用数量
            })
            .match({
                _id: {
                    $regex: searchWord, // 使用$regex匹配搜索词
                    $options: 'i'      // 忽略大小写
                }
            });

        console.log('Filtered unique quote authors:', uniqueQuoteAuthors);
        return uniqueQuoteAuthors;

    } catch (error) {
        console.error('Error during aggregation:', error);
        throw error;
    } finally {
        await disconnectDB();
    }
}

// 示例调用
(async () => {
    try {
        await getQuoteAuthorSearchedResult('CK');
        await getQuoteAuthorSearchedResult('Ni');
        await getQuoteAuthorSearchedResult('john'); // 测试大小写不敏感
    } catch (e) {
        // 错误处理
    }
})();
代码解析:
- QuoteModel.aggregate(): 启动一个聚合管道。
- .group({ _id: '$author', count: { $sum: 1 } }): 这是聚合管道的第一个阶段。它将文档按author字段进行分组,并计算每个作者出现的次数,结果文档的结构为{ _id: "作者名", count: 引用次数 }。
- .match({ _id: { $regex: searchWord, $options: 'i' } }): 这是关键的过滤阶段。它作用于group阶段的输出结果。
- _id: 指的是group阶段输出文档中的_id字段(即作者名)。
- $regex: searchWord: 使用searchWord作为正则表达式模式进行匹配。
- $options: 'i': 确保匹配是大小写不敏感的。
输出示例:
当searchWord为'CK'时:
Searching for authors containing: "CK"
Filtered unique quote authors: [ { _id: 'Jack', count: 2 }, { _id: 'Nick', count: 3 } ]
当searchWord为'Ni'时:
Searching for authors containing: "Ni"
Filtered unique quote authors: [ { _id: 'Nick', count: 3 } ]
当searchWord为'john'时:
Searching for authors containing: "john"
Filtered unique quote authors: [ { _id: 'John', count: 1 } ]
注意事项与最佳实践
- 性能优化: 将$match阶段尽可能地放在聚合管道的早期。如果$match可以应用于原始文档,那么在$group之前进行匹配会进一步减少进入$group阶段的文档数量,从而提高整体性能。然而,在本例中,我们是在_id(即author)字段上进行匹配,而这个_id是$group阶段生成的,所以$match必须放在$group之后。
- 索引考量: 对于$regex查询,如果模式是前缀匹配(例如^searchWord),并且_id字段(或任何被查询的字段)上有索引,MongoDB可以利用索引来加速查询。然而,如果$regex模式是中间匹配(例如searchWord或.*searchWord.*),即使有索引,通常也无法完全利用索引,可能会导致全集合扫描。因此,在设计搜索功能时,应权衡用户体验和查询性能。
- 输入安全: 永远不要直接将用户输入的搜索字符串未经处理地传递给$regex。用户输入可能包含特殊的正则表达式字符,这可能导致意外的行为或潜在的ReDoS(正则表达式拒绝服务)攻击。在将用户输入用于$regex之前,应进行适当的转义处理。例如,使用lodash.escapeRegExp或手动转义特殊字符。
- $regex的替代方案: 对于简单的前缀匹配,$text操作符配合文本索引可能提供更好的性能,但它需要创建文本索引并有其自身的限制(例如,不能与$regex同时使用,且对语言敏感)。对于更复杂的全文搜索需求,可能需要考虑Elasticsearch等专门的搜索引擎。
总结
通过将字符串匹配和过滤逻辑直接嵌入到Mongoose的聚合管道中,利用$match和$regex操作符,我们可以实现高效、灵活且大小写不敏感的数据库层搜索功能。这种方法不仅减少了应用服务器的负担,提高了查询性能,也使得代码更加简洁和易于维护。在实际开发中,理解并善用Mongoose聚合管道的强大功能,是构建高性能MERN栈应用的关键。
今天关于《Mongoose高效字符串匹配与过滤技巧》的内容就介绍到这里了,是不是学起来一目了然!想要了解更多关于的内容请关注golang学习网公众号!
 响应式卡片墙:flex-basis与媒体查询应用
- 上一篇
- 响应式卡片墙:flex-basis与媒体查询应用

- 下一篇
- 豆包网页版使用教程及操作指南
-
- 文章 · 前端 | 15小时前 | 前端交互 · CSS布局 · 横向滚动 · 移动端体验 · Scroll Snap · scroll-snap-type scroll-snap-align CSS scroll snap 横向卡片滚动 前端卡片边界对齐
- CSS scroll snap让横向卡片滚动停在卡片边界的实现方法
- 403浏览 收藏
-
- 文章 · 前端 | 16小时前 | 前端 · css · 响应式布局 · CSS 响应式布局 container queries container-type @container
- CSS container queries按容器宽度切换组件布局的实现方法
- 387浏览 收藏
-
- 文章 · 前端 | 18小时前 | 前端 · javascript · Fetch API · 异步取消 · AbortController AbortSignal Fetch API abort reason
- Fetch AbortController传递取消原因并区分异常来源的实现方法
- 351浏览 收藏
-
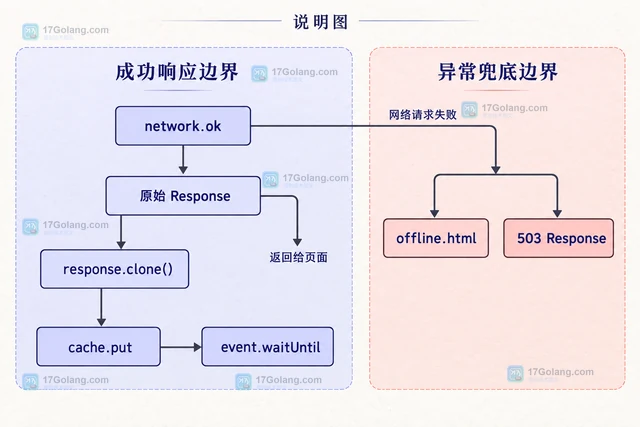
- 文章 · 前端 | 19小时前 | pwa · fetch · Service Worker · 前端缓存 · 离线回退 · 离线缓存 fetch事件 Service Worker caches.match event.respondWith 网络回退
- Service Worker设计缓存失败后的网络回退的实现方法
- 448浏览 收藏
-
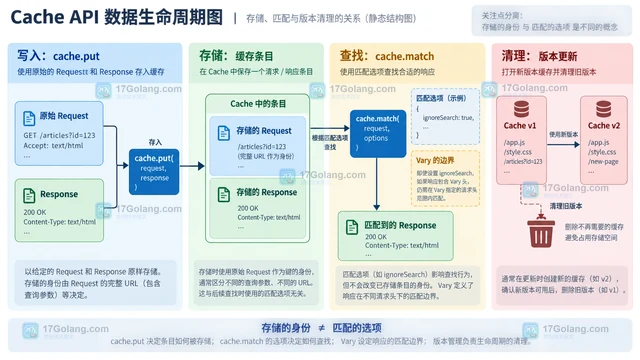
- 文章 · 前端 | 20小时前 | 前端 · pwa · Service Worker · 浏览器缓存 · Service Worker Cache API Cache.match ignoreSearch 前端缓存
- Cache API用 match 选项控制查询参数是否参与缓存键的实现方法
- 409浏览 收藏
-
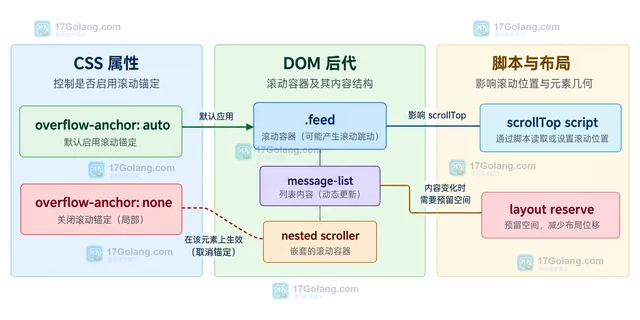
- 文章 · 前端 | 22小时前 |
- CSS scroll anchoring 造成滚动跳动时如何关闭
- 313浏览 收藏
-
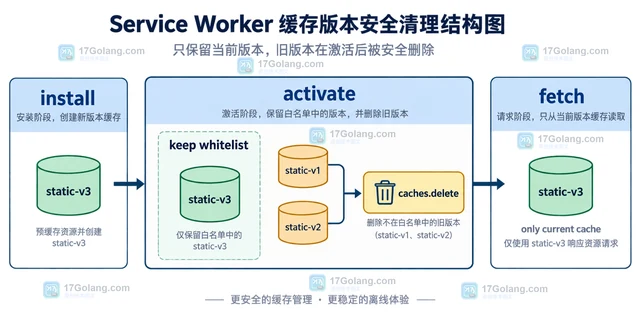
- 文章 · 前端 | 22小时前 | 前端 · Service Worker · 浏览器缓存 · 浏览器 缓存更新 Service Worker Cache API
- 浏览器 Cache API 更新资源时如何清理旧版本
- 220浏览 收藏
-
- 文章 · 前端 | 1天前 |
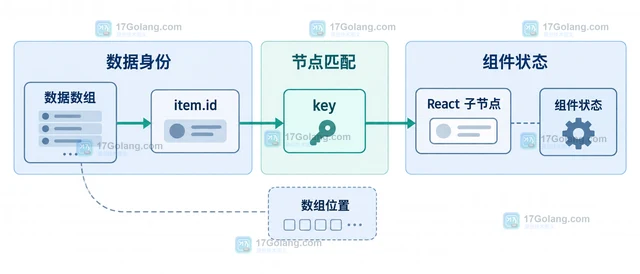
- React key 使用数组索引时哪些更新会错位
- 264浏览 收藏
-
- 文章 · 前端 | 1天前 |
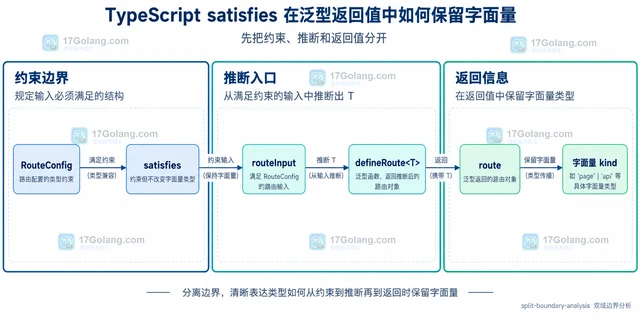
- TypeScript satisfies 在泛型返回值中如何保留字面量
- 368浏览 收藏
-
- 文章 · 前端 | 1天前 |
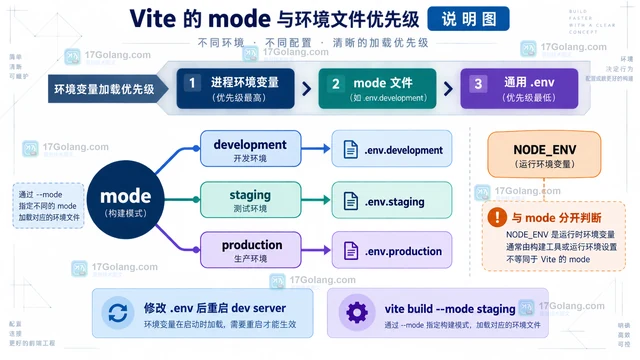
- Vite 环境变量前缀不生效时如何区分模式
- 196浏览 收藏
-
- 文章 · 前端 | 1天前 | javascript · 前端性能 · IntersectionObserver · ResizeObserver · IntersectionObserver ResizeObserver 前端性能 长列表
- ResizeObserver 如何只观察可见组件避免重复计算
- 373浏览 收藏
-
- 文章 · 前端 | 1天前 | dom · javascript · 前端性能 · IntersectionObserver · JavaScript IntersectionObserver 前端性能
- IntersectionObserver 观察大量元素时如何拆分
- 276浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 49次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 149次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 82次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 52次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 37次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览


