
递归优化技巧:JavaScript高效实现方法
IT行业相对于一般传统行业,发展更新速度更快,一旦停止了学习,很快就会被行业所淘汰。所以我们需要踏踏实实的不断学习,精进自己的技术,尤其是初学者。今天golang学习网给大家整理了《递归优化技巧:JavaScript高效实现方法》,聊聊,我们一起来看看吧!
优化JavaScript递归函数需通过记忆化避免重复计算,并将递归转换为迭代以防止栈溢出,从而提升性能与健壮性。

优化JavaScript中的递归函数,核心在于两点:避免重复计算(通过缓存)和防止栈溢出(通过迭代化或尾调用优化)。这不仅仅是提升性能,更是在面对复杂算法时确保代码健壮性的关键。
解决方案
在我看来,处理JavaScript中的递归优化,我们主要有两条路径可以走,而且它们往往是互补的。
路径一:利用Memoization(记忆化)避免重复计算
很多递归问题,尤其是那些带有重叠子问题特性的,比如斐波那契数列、阶乘等,会反复计算相同参数的值。这就导致了指数级的性能下降。Memoization的核心思想就是把每次函数调用的结果缓存起来,下次再遇到相同参数时,直接返回缓存结果,而不是重新计算。
一个简单的实现方式是使用一个JavaScript对象或Map来存储结果:
function fibonacci(n, memo = {}) {
  if (n in memo) {
    return memo[n];
  }
  if (n <= 1) {
    return n;
  }
  memo[n] = fibonacci(n - 1, memo) + fibonacci(n - 2, memo);
  return memo[n];
}

// 举个例子,如果没有memo,fibonacci(40)可能要算很久
// console.time('fib_no_memo');
// console.log(fibonacciNoMemo(40)); // 假设有个没有memo的版本
// console.timeEnd('fib_no_memo');

console.time('fib_with_memo');
console.log(fibonacci(40)); // 会快很多
console.timeEnd('fib_with_memo');
这种方式极大地减少了函数的实际执行次数,将时间复杂度从指数级优化到线性级。当然,代价是额外的内存开销,但对于大多数场景来说,这个权衡是值得的。
路径二:将递归转换为迭代以避免栈溢出
JavaScript引擎对调用栈的深度是有限制的,当我们进行深度很大的递归调用时,很容易遇到“Maximum call stack size exceeded”的错误。尤其是在处理树结构遍历或某些深度优先搜索时,这个问题尤为突出。虽然ES6引入了尾调用优化(TCO)的概念,但在实际的V8引擎(Chrome, Node.js)中并没有完全实现,所以我们不能完全依赖它。
最稳妥的办法就是将递归逻辑手动转换为迭代逻辑,也就是使用循环(for或while)。这通常需要我们自己维护一个“栈”来模拟递归调用的状态。
以一个简单的阶乘函数为例:
// 递归版本
function factorialRecursive(n) {
  if (n === 0) {
    return 1;
  }
  return n * factorialRecursive(n - 1);
}

// 迭代版本
function factorialIterative(n) {
  let result = 1;
  for (let i = 2; i <= n; i++) {
    result *= i;
  }
  return result;
}

console.log(factorialRecursive(5)); // 120
console.log(factorialIterative(5)); // 120

// 对于更深度的场景,比如遍历一个深度很大的链表或树,迭代版本就能避免栈溢出
// 假设有一个深度为100000的链表,递归遍历会栈溢出,但迭代不会。
对于更复杂的递归,比如深度优先搜索(DFS),我们可以用一个显式的栈(数组)来存储待处理的节点,从而将递归转换为迭代。这虽然增加了代码的复杂性,但却彻底规避了栈溢出的风险。
为什么JavaScript中的递归函数需要特别优化?
说实话,这个问题我个人觉得挺核心的,因为很多人在初学递归时,往往只关注其优雅的表达力,却忽略了它在实际运行环境中的一些“脾气”。JavaScript作为一门单线程语言,其执行环境对调用栈的深度有着严格的限制。当你写一个递归函数,每一次函数调用都会在调用栈上压入一个新的栈帧,保存当前的执行上下文。一旦递归深度过大,超出了引擎设定的最大栈帧数,就会抛出那个经典的RangeError: Maximum call stack size exceeded。这就像是你的书桌就那么大,你非要堆上几百本书,结果就是书桌塌了。
而且,很多递归算法,尤其是那些没有经过优化的,比如未经记忆化的斐波那契数列,会产生大量的重复计算。想象一下,为了计算fib(5),你需要fib(4)和fib(3);为了fib(4),又需要fib(3)和fib(2)……你会发现fib(3)被计算了不止一次。这种重复劳动在小规模数据时可能不明显,但一旦数据量上去,性能会急剧下降,从可接受的毫秒级飙升到秒级甚至更长,这对于用户体验来说是灾难性的。所以,优化不仅仅是“锦上添花”,在很多场景下,它直接决定了你的代码能不能跑起来,能不能用。
缓存计算结果:Memoization在递归优化中的应用
Memoization,我更喜欢称之为“记忆化”,它就是一种空间换时间的策略,通过将函数的计算结果缓存起来,避免对相同的输入重复计算。这就像是你做了一道数学题,把答案记在草稿纸上,下次遇到一样的题型,直接看草稿纸就行,不用再从头算一遍。
在JavaScript中实现Memoization通常有两种常见方式:
闭包 + Map/Object: 这是最灵活也最常用的方式。你可以创建一个高阶函数,它接受一个函数作为参数,并返回一个带有缓存逻辑的新函数。
function memoize(fn) {
  const cache = new Map(); // 使用Map比Object更好,因为键可以是任何类型
  return function(...args) {
    const key = JSON.stringify(args); // 简单的键生成方式,对于复杂对象可能需要更精细的处理
    if (cache.has(key)) {
      return cache.get(key);
    }
    const result = fn.apply(this, args);
    cache.set(key, result);
    return result;
  };
}

// 应用到斐波那契函数
const fibonacciMemoized = memoize(function(n) {
  if (n <= 1) {
    return n;
  }
  return fibonacciMemoized(n - 1) + fibonacciMemoized(n - 2);
});

console.time('fib_memoized_generic');
console.log(fibonacciMemoized(40));
console.timeEnd('fib_memoized_generic');
这里需要注意
JSON.stringify(args)作为键的局限性,如果参数是对象且顺序不固定,或者有循环引用,可能需要更复杂的键生成策略。直接在函数内部维护缓存: 这种方式更直接,但耦合度稍高。就像我们之前在
fibonacci函数中直接传入memo对象一样。
Memoization最适合那些:
- 计算开销大: 函数执行起来很慢。
- 输入参数有限且重复: 函数会被相同的参数多次调用。
- 纯函数: 对于相同的输入总是产生相同的输出,没有副作用。
虽然它会增加内存消耗,但对于大部分需要优化性能的递归场景,这种投入是非常值得的。
避免栈溢出:将递归转换为迭代的策略与实践
栈溢出,这个错误提示相信每个JavaScript开发者都或多或少遇到过。它不是性能问题,而是代码运行的“生死存亡”问题。当递归深度超过了JavaScript引擎的限制时,程序就直接崩溃了。所以,当你知道你的递归可能会很深时,比如处理一个用户上传的、深度未知的JSON对象,或者遍历一个大型文件系统的目录结构,转换为迭代就是你的“救命稻草”。
将递归转换为迭代的核心思想是,我们不再依赖语言的调用栈来管理状态,而是自己显式地用数据结构(通常是数组,模拟栈或队列)来管理。
1. 简单尾递归的迭代化: 对于像阶乘这种简单的尾递归(最后一步操作是调用自身,且没有其他操作),转换非常直接:
// 递归:
// function sumRecursive(n, acc = 0) {
//   if (n === 0) return acc;
//   return sumRecursive(n - 1, acc + n);
// }

// 迭代化:
function sumIterative(n) {
  let acc = 0;
  while (n > 0) {
    acc += n;
    n--;
  }
  return acc;
}
console.log(sumIterative(100000)); // 不会栈溢出
2. 深度优先搜索(DFS)的迭代化: 这是将递归转换为迭代的典型场景。递归版的DFS非常直观,但遇到深层图或树时就会出问题。迭代版DFS通常使用一个栈(数组)来存储待访问的节点。
// 假设有一个简单的树结构
const tree = {
  value: 'A',
  children: [
    { value: 'B', children: [{ value: 'D', children: [] }] },
    { value: 'C', children: [{ value: 'E', children: [] }, { value: 'F', children: [] }] }
  ]
};

// 递归DFS
function dfsRecursive(node) {
  console.log(node.value);
  if (node.children) {
    for (const child of node.children) {
      dfsRecursive(child);
    }
  }
}
// console.log('Recursive DFS:');
// dfsRecursive(tree);

// 迭代DFS
function dfsIterative(root) {
  const stack = [root]; // 初始化栈,放入根节点

  while (stack.length > 0) {
    const node = stack.pop(); // 弹出栈顶节点
    console.log(node.value);

    // 将子节点从右到左压入栈,确保左边的子节点先被处理(因为栈是LIFO)
    if (node.children) {
      for (let i = node.children.length - 1; i >= 0; i--) {
        stack.push(node.children[i]);
      }
    }
  }
}
console.log('Iterative DFS:');
dfsIterative(tree);
通过这种方式,我们完全掌控了状态的流转,不再受限于引擎的调用栈深度。虽然代码可能看起来没有递归那么“优雅”,但它提供了更高的鲁棒性和可预测性,尤其是在处理大规模或深度不可控的数据结构时,这是至关重要的。在实际工作中,我发现这种迭代化的思维方式,对于编写高性能和稳定性的代码,真的是不可或缺的。
以上就是本文的全部内容了,是否有顺利帮助你解决问题?若是能给你带来学习上的帮助,请大家多多支持golang学习网!更多关于文章的相关知识,也可关注golang学习网公众号。
 PHPCMS安装教程与常见问题解决
- 上一篇
- PHPCMS安装教程与常见问题解决

- 下一篇
- Golang结构体转JSON方法全解析
-
- 文章 · 前端 | 6小时前 |
- 前端状态更新频繁时,批处理与去抖分别解决什么
- 227浏览 收藏
-
- 文章 · 前端 | 8小时前 | 前端 · 可访问性 · 焦点陷阱 HTML dialog 焦点恢复 inert 无障碍弹窗
- 可访问弹窗的焦点陷阱、关闭恢复与背景隔离
- 309浏览 收藏
-
- 文章 · 前端 | 10小时前 | 前端 · 性能优化 · javascript · ArrayBuffer postMessage 前端性能 Web Worker Transferable structured clone
- Web Worker 传大数据为何卡顿:复制与 Transferable 对比
- 220浏览 收藏
-
- 文章 · 前端 | 13小时前 | 请求超时 Fetch AbortController AbortSignal 用户取消 前端异常处理
- Fetch 请求取消后,超时与用户中断要怎样区分
- 466浏览 收藏
-
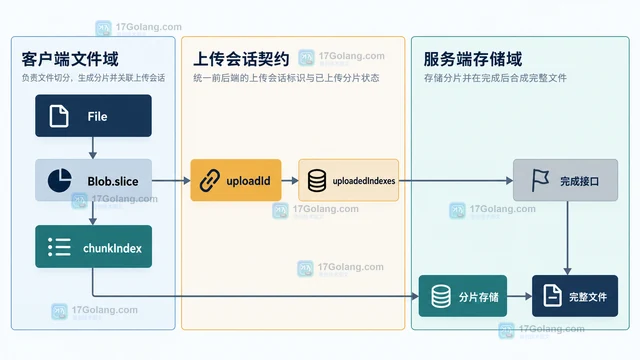
- 文章 · 前端 | 15小时前 | 文件上传 · javascript · 前端开发 · 大文件上传 断点续传 XMLHttpRequest Blob.slice 前端分片上传 暂停上传
- 前端上传大文件:分片、暂停与失败续传怎样协作
- 371浏览 收藏
-
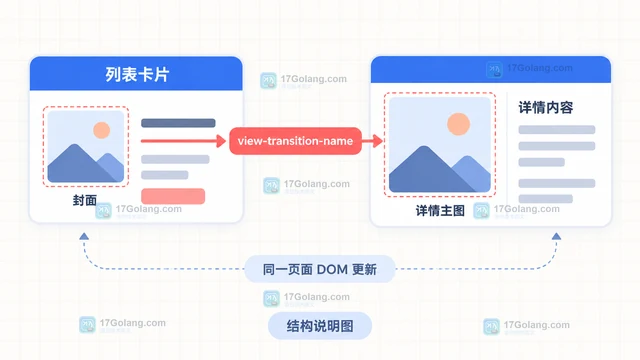
- 文章 · 前端 | 17小时前 | 列表详情 View Transition API 前端渐进增强
- View Transition API 做列表到详情过渡的渐进增强
- 385浏览 收藏
-
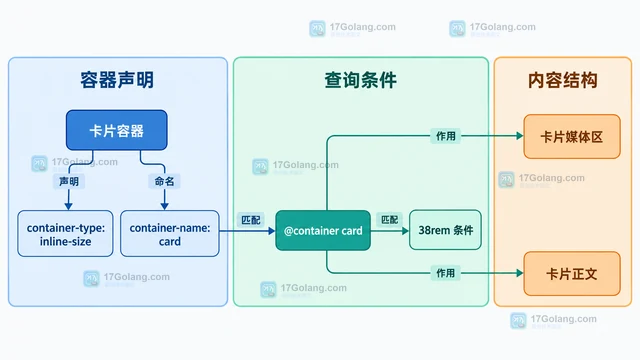
- 文章 · 前端 | 19小时前 |
- 用 CSS Container Query 让卡片按容器而不是视口响应
- 289浏览 收藏
-
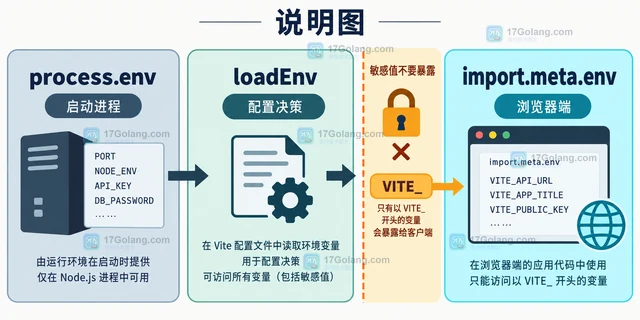
- 文章 · 前端 | 22小时前 | 环境变量 vite loadEnv vite.config
- Vite 环境变量为什么在配置加载时取不到
- 133浏览 收藏
-
- 文章 · 前端 | 23小时前 |
- React useOptimistic 怎么在请求失败时回滚列表
- 153浏览 收藏
-
- 文章 · 前端 | 1天前 | 前端开发 · 前端路由 hostname URLPattern pathname
- URLPattern 怎么同时匹配域名和路径参数
- 108浏览 收藏
-
- 文章 · 前端 | 1天前 | javascript · JavaScript Intl.DurationFormat 前端国际化 持续时间格式化
- Intl.DurationFormat 怎么本地化显示持续时间
- 141浏览 收藏
-
- 文章 · 前端 | 1天前 | 前端开发 · 浏览器API · postMessage MessageChannel Web Worker MessagePort
- postMessage 转移 MessagePort 后原端口还能用吗
- 477浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 370次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 427次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 445次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 392次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 217次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览


