
一文浅谈深度学习泛化能力
小伙伴们对科技周边编程感兴趣吗?是否正在学习相关知识点?如果是,那么本文《一文浅谈深度学习泛化能力》,就很适合你,本篇文章讲解的知识点主要包括。在之后的文章中也会多多分享相关知识点,希望对大家的知识积累有所帮助!
一、DNN泛化能力的问题
论文主要探讨的是, 为什么过参数的神经网络模型还能有不错的泛化性?即并不是简单记忆训练集,而是从训练集中总结出一个通用的规律,从而可以适配于测试集(泛化能力)。
以经典的决策树模型为例, 当树模型学习数据集的通用规律时:一种好的情况,假如树第一个分裂节点时,刚好就可以良好区分开不同标签的样本,深度很小,相应的各叶子上面的样本数是够的(即统计规律的数据量的依据也是比较多的),那这会得到的规律就更有可能泛化到其他数据。(即:拟合良好, 有泛化能力)。
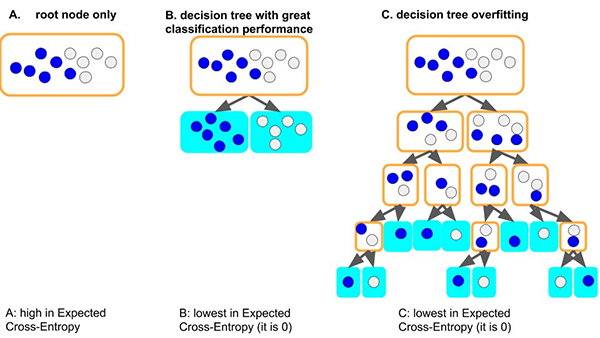
另外一种较差的情况,如果树学习不好一些通用的规律,为了学习这个数据集,那树就会越来越深,可能每个叶子节点分别对应着少数样本(少数据带来统计信息可能只是噪音),最后,死记硬背地记住所有数据(即:过拟合 无泛化能力)。我们可以看到过深(depth)的树模型很容易过拟合。
那么过参数化的神经网络如何达到良好的泛化性呢?
二、 DNN泛化能力的原因
本文是从一个简单通用的角度解释——在神经网络的梯度下降优化过程上,探索泛化能力的原因:
我们总结了梯度相干理论 :来自不同样本的梯度产生相干性,是神经网络能有良好的泛化能力原因。当不同样本的梯度在训练过程中对齐良好,即当它们相干时,梯度下降是稳定的,可以很快收敛,并且由此产生的模型可以有良好的泛化性。否则,如果样本太少或训练时间过长,可能无法泛化。
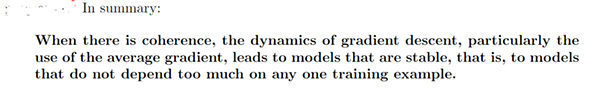
基于该理论,我们可以做出如下解释。
2.1 宽度神经网络的泛化性
更宽的神经网络模型具有良好的泛化能力。这是因为,更宽的网络都有更多的子网络,对比小网络更有产生梯度相干的可能,从而有更好的泛化性。换句话说,梯度下降是一个优先考虑泛化(相干性)梯度的特征选择器,更广泛的网络可能仅仅因为它们有更多的特征而具有更好的特征。
- 论文原文:Generalization and width. Neyshabur et al. [2018b] found that wider networks generalize better. Can we now explain this? Intuitively, wider networks have more sub-networks at any given level, and so the sub-network with maximum coherence in a wider network may be more coherent than its counterpart in a thinner network, and hence generalize better. In other words, since—as discussed in Section 10—gradient descent is a feature selector that prioritizes well-generalizing (coherent) features, wider networks are likely to have better features simply because they have more features. In this connection, see also the Lottery Ticket Hypothesis [Frankle and Carbin, 2018]
- 论文链接:https://github.com/aialgorithm/Blog
但是个人觉得,这还是要区分下网络输入层/隐藏层的宽度。特别对于数据挖掘任务的输入层,由于输入特征是通常是人工设计的,需要考虑下做下特征选择(即减少输入层宽度),不然直接输入特征噪音,对于梯度相干性影响不也是有干扰的。
2.2 深度神经网络的泛化性
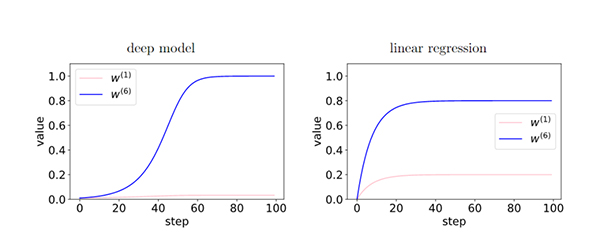
越深的网络,梯度相干现象被放大,有更好的泛化能力。
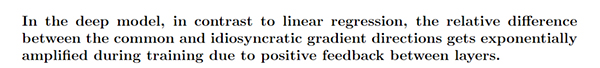
在深度模型中,由于层之间的反馈加强了有相干性的梯度,存在相干性梯度的特征(W6)和非相干梯度的特征(W1)之间的相对差异在训练过程中呈指数放大。从而使得更深的网络更偏好相干梯度,从而更好泛化能力。
2.3 早停(early-stopping)
通过早停我们可以减少非相干梯度的过多影响,提高泛化性。
在训练的时候,一些容易样本比其他样本(困难样本)更早地拟合。训练前期,这些容易样本的相干梯度做主导,并很容易拟合好。训练后期,以困难样本的非相干梯度主导了平均梯度g(wt),从而导致泛化能力变差,这个时候就需要早停。
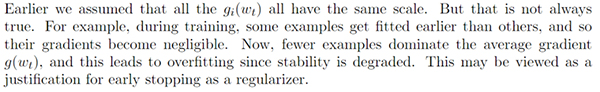
- (注:简单的样本,是那些在数据集里面有很多梯度共同点的样本,正由于这个原因,大多数梯度对它有益,收敛也比较快。)
2.4 全梯度下降 VS 学习率
我们发现全梯度下降也可以有很好的泛化能力。此外,仔细的实验表明随机梯度下降并不一定有更优的泛化,但这并不排除随机梯度更易跳出局部最小值、起着正则化等的可能性。
- Based on our theory, finite learning rate, and mini-batch stochasticity are not necessary for generalization
我们认为较低的学习率可能无法降低泛化误差,因为较低的学习率意味着更多的迭代次数(与早停相反)。
- Assuming a small enough learning rate, as training progresses, the generalization gap cannot decrease. This follows from the iterative stability analysis of training: with 40 more steps, stability can only degrade. If this is violated in a practical setting, it would point to an interesting limitation of the theory
2.5 L2、L1正则化
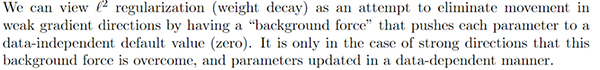
目标函数加入L2、L1正则化,相应的梯度计算, L1正则项需增加的梯度为sign(w) ,L2梯度为w。以L2正则为例,相应的梯度W(i+1)更新公式为:图片
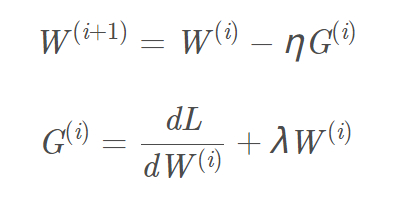
我们可以把“L2正则化(权重衰减)”看作是一种“背景力”,可将每个参数推近于数据无关的零值 ( L1容易得到稀疏解,L2容易得到趋近0的平滑解) ,来消除在弱梯度方向上影响。只有在相干梯度方向的情况下,参数才比较能脱离“背景力”,基于数据完成梯度更新。
2.6 梯度下降算法的进阶
- Momentum 、Adam等梯度下降算法
Momentum 、Adam等梯度下降算法,其参数W更新方向不仅由当前的梯度决定,也与此前累积的梯度方向有关(即,保留累积的相干梯度的作用)。这使得参数中那些梯度方向变化不大的维度可以加速更新,并减少梯度方向变化较大的维度上的更新幅度,由此产生了加速收敛和减小震荡的效果。
- 抑制弱梯度方向的梯度下降
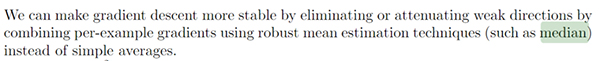
我们可以通过优化批次梯度下降算法,来抑制弱梯度方向的梯度更新,进一步提高了泛化能力。比如,我们可以使用梯度截断(winsorized gradient descent),排除梯度异常值后的再取平均值。或者取梯度的中位数代替平均值,以减少梯度异常值的影响。
小结
文末说两句,对于深度学习的理论,有兴趣可以看下论文提及的相关研究。
文中关于深度学习,神经网络的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《一文浅谈深度学习泛化能力》文章吧,也可关注golang学习网公众号了解相关技术文章。
 新型口罩可检测周边有无新冠病毒,10分钟内发出预警
- 上一篇
- 新型口罩可检测周边有无新冠病毒,10分钟内发出预警
- 下一篇
- 机器学习正在赋能制药行业
-
- 热心的玫瑰
- 写的不错,一直没懂这个问题,但其实工作中常常有遇到...不过今天到这,帮助很大,总算是懂了,感谢作者分享文章内容!
- 2023-05-23 07:59:50
-
- 坚定的棒棒糖
- 这篇博文真及时,太全面了,受益颇多,mark,关注大佬了!希望大佬能多写科技周边相关的文章。
- 2023-05-02 14:52:37
-
- 科技周边 · 人工智能 | 2小时前 | python · 人工智能 · Transformers apply_chat_template 聊天模板 chat_template 角色标签
- Transformers聊天模板与手写角色标签有什么兼容性差异
- 492浏览 收藏
-
- 科技周边 · 人工智能 | 2小时前 | PyTorch checkpoint Accelerate 随机数状态 恢复训练
- Accelerate恢复训练时如何保存随机数状态
- 326浏览 收藏
-
- 科技周边 · 人工智能 | 2小时前 |
- Diffusers怎样使用Generator复现同一张生成图
- 118浏览 收藏
-
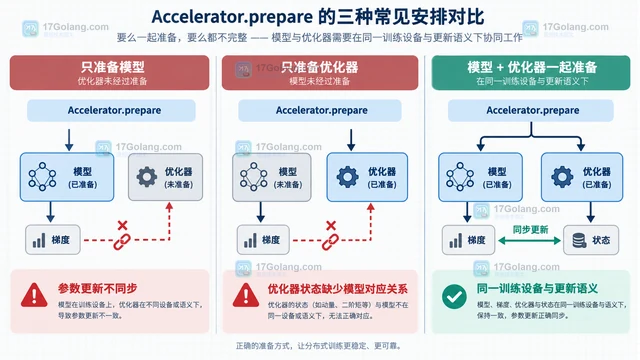
- 科技周边 · 人工智能 | 2小时前 | 模型 混合精度 优化器 分布式训练 Accelerate Accelerator.prepare
- Accelerate prepare为什么要同时接收模型与优化器
- 386浏览 收藏
-
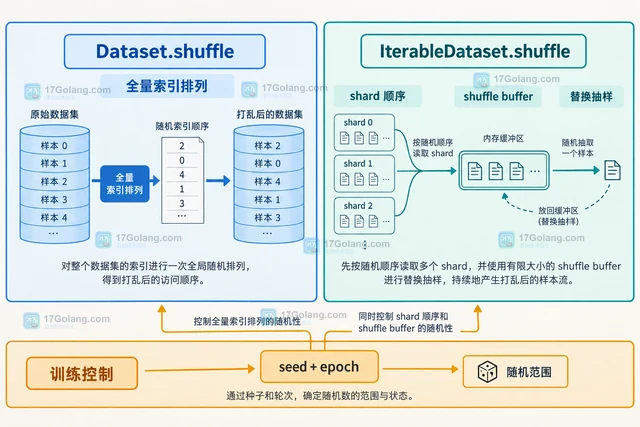
- 科技周边 · 人工智能 | 2小时前 | 人工智能 · Hugging Face Datasets streaming IterableDataset Dataset.shuffle shuffle buffer
- Datasets流式读取与内存数据集的shuffle有什么区别
- 130浏览 收藏
-
- 科技周边 · 人工智能 | 2小时前 |
- Hugging Face Datasets map怎样同时删除旧字段
- 421浏览 收藏
-
- 科技周边 · 人工智能 | 2小时前 |
- PEFT适配器检查点为什么不包含完整基础模型
- 301浏览 收藏
-
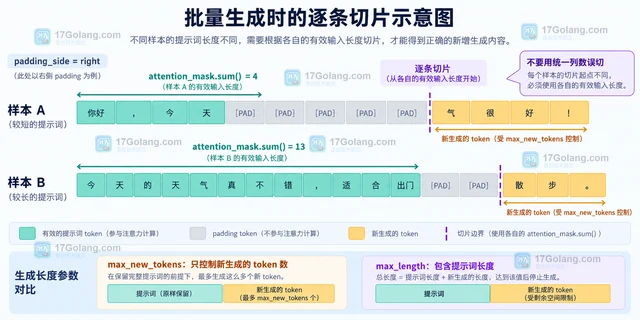
- 科技周边 · 人工智能 | 2小时前 | python · Hugging Face 提示词 Transformers generate input_ids
- Transformers生成结果为什么包含输入提示词
- 111浏览 收藏
-
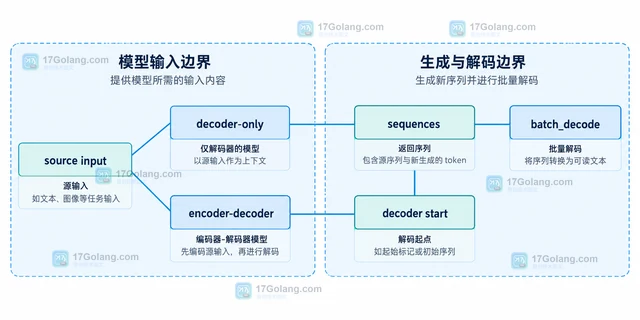
- 科技周边 · 人工智能 | 2小时前 | 解码 token Transformers generate 新生成内容
- Transformers怎样只解码新生成的token
- 461浏览 收藏
-
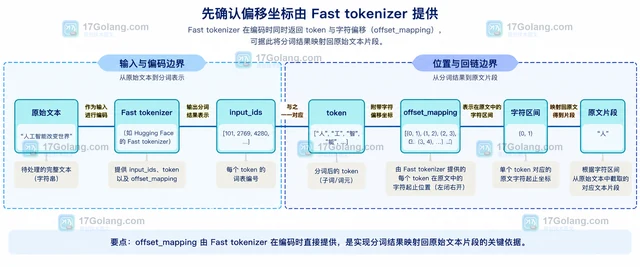
- 科技周边 · 人工智能 | 2小时前 | python · 人工智能 · Transformers offset_mapping 原始文本 Fast tokenizer 文本偏移
- Transformers分词偏移怎样映射回原始文本片段
- 330浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 463次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 526次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 544次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 493次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 311次使用
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览
-
- Canva手机闪退解决方法及适配指南
- 2026-05-25 501浏览


