
Golang优化S3高性能客户端实现
本文深入探讨了如何使用 Golang 构建高性能的云存储 S3 客户端,以优化云存储操作。核心在于充分利用 Golang 的并发特性,精细化 HTTP 传输层的配置,并采用 S3 分段上传/下载机制处理大文件。文章分析了 Golang S3 客户端常见的性能瓶颈,如网络延迟、缺乏并发利用、不恰当的数据传输方式以及默认 SDK 配置的局限性。针对这些问题,详细阐述了如何通过 `s3manager` 包实现高效的分段上传与下载,并给出了具体的代码示例,包括关键参数 `PartSize` 和 `Concurrency` 的调优建议。此外,还介绍了 HTTP 连接池的配置、工作池模式的应用以及 `context` 包的合理使用等 Golang 技术,旨在帮助开发者构建健壮且高效的 S3 客户端,从而应对复杂的云存储场景。
在Golang中优化S3云存储操作,构建一个高性能客户端,核心在于深度利用并发、智能地管理连接与数据流,并充分发挥S3自身的特性。这不仅仅是简单地调用SDK函数,更是一种对系统资源和网络行为的精妙调控。在我看来,一个真正高性能的S3客户端,它懂得何时并行、何时等待,以及如何以最经济的方式传输数据。
解决方案
要实现S3高性能客户端,你需要从以下几个关键点着手:充分利用Golang的并发模型(goroutines),精细化HTTP传输层的配置,以及最重要的——对大文件采用S3的分段上传/下载机制。此外,合理的错误重试策略和内存管理也至关重要。这些措施共同作用,才能突破单线程或默认配置下的性能瓶颈,让你的应用在与S3交互时如行云流水。
Golang中S3客户端性能瓶颈的常见原因是什么?
在实际开发中,我发现Golang S3客户端的性能瓶颈往往出乎意料,但归根结底,它们通常围绕着几个核心问题。首先,也是最直观的,是网络延迟和带宽限制。S3毕竟是远程服务,每次API调用都有网络往返开销。如果你的应用频繁进行小文件操作,或者网络环境不佳,这些累积的延迟会非常显著。
其次,缺乏并发利用是一个常见但容易被忽视的问题。很多开发者习惯于顺序执行操作,例如在一个循环中逐个上传或下载文件。这在处理少量数据时问题不大,但面对海量文件或大型文件时,单线程的I/O操作会成为巨大的瓶颈。Golang的goroutine机制为我们提供了天然的并发优势,如果未能充分利用,无疑是浪费了其核心能力。
再者,不恰当的数据传输方式,尤其是对于大文件。如果你尝试一次性将一个几GB甚至几十GB的文件读入内存再上传,或者不使用S3的分段(Multipart)特性,那么不仅内存压力巨大,传输效率也会非常低下。S3设计之初就考虑到了大文件的分段传输,这是其高性能的基石之一。
还有,默认的AWS SDK配置可能并非总是最优。SDK为了普适性,其HTTP连接池、超时、重试策略等都有默认值。但在高并发、高吞吐量的场景下,这些默认值可能无法满足需求,导致连接频繁建立、关闭,或者因短暂的网络抖动而频繁失败。
最后,不恰当的错误处理和重试逻辑也可能拖慢整体性能。过于激进的重试可能导致S3限流,而过于保守的重试又可能让操作长时间挂起。此外,一些细微的内存分配模式,比如频繁创建和销毁大块字节切片,也可能导致GC压力增大,间接影响性能。
如何在Golang中实现高效的S3分段上传与下载?
S3的分段上传(Multipart Upload)和分段下载(Byte-Range Fetches)是处理大文件的核心策略,它们将大文件拆分成小块并行传输,极大地提升了效率和可靠性。在Golang中,AWS SDK v2的s3manager包为我们提供了非常便捷的封装,让这一复杂过程变得触手可及。
对于分段上传,s3manager.Uploader是你的首选。它会自动处理文件的分块、并行上传以及最终的合并。你只需要配置好PartSize(每个分段的大小,通常建议至少5MB)和Concurrency(并行上传的分段数量)。
一个典型的上传流程可能看起来像这样:
import (
    "context"
    "fmt"
    "io"
    "os"
    "time"

    "github.com/aws/aws-sdk-go-v2/aws"
    "github.com/aws/aws-sdk-go-v2/feature/s3/manager"
    "github.com/aws/aws-sdk-go-v2/service/s3"
)

// Assume cfg is your aws.Config loaded with credentials and region
func uploadFileToS3(ctx context.Context, s3Client *s3.Client, bucket, key, filePath string) error {
    file, err := os.Open(filePath)
    if err != nil {
        return fmt.Errorf("failed to open file %s: %w", filePath, err)
    }
    defer file.Close()

    uploader := manager.NewUploader(s3Client, func(u *manager.Uploader) {
        u.PartSize = 64 * 1024 * 1024 // 64MB per part, adjust based on network
        u.Concurrency = 10            // Upload 10 parts concurrently
        u.BufferProvider = manager.NewBufferedReadFromProvider(32 * 1024 * 1024) // Buffer for each part
    })

    fmt.Printf("Starting multipart upload for %s to s3://%s/%s\n", filePath, bucket, key)
    start := time.Now()

    _, err = uploader.Upload(ctx, &s3.PutObjectInput{
        Bucket: aws.String(bucket),
        Key:    aws.String(key),
        Body:   file,
    })

    if err != nil {
        return fmt.Errorf("failed to upload file %s: %w", filePath, err)
    }

    fmt.Printf("Successfully uploaded %s in %s\n", filePath, time.Since(start))
    return nil
}这里,PartSize和Concurrency是调优的关键。较小的分段可能导致过多的API调用,而过大的分段在网络中断时重试成本较高。BufferProvider可以进一步优化内存使用。
对于分段下载,s3manager.Downloader同样提供了类似的便利。它会根据你指定的分段大小和并发数,并行地从S3拉取文件的不同部分,并将它们按顺序写入到io.WriterAt接口中。
// Assume cfg is your aws.Config loaded with credentials and region
func downloadFileFromS3(ctx context.Context, s3Client *s3.Client, bucket, key, outputPath string) error {
    file, err := os.Create(outputPath)
    if err != nil {
        return fmt.Errorf("failed to create file %s: %w", outputPath, err)
    }
    defer file.Close()

    downloader := manager.NewDownloader(s3Client, func(d *manager.Downloader) {
        d.PartSize = 64 * 1024 * 1024 // 64MB per part, same logic as upload
        d.Concurrency = 10            // Download 10 parts concurrently
    })

    fmt.Printf("Starting multipart download for s3://%s/%s to %s\n", bucket, key, outputPath)
    start := time.Now()

    // Downloader writes to io.WriterAt
    numBytes, err := downloader.Download(ctx, file, &s3.GetObjectInput{
        Bucket: aws.String(bucket),
        Key:    aws.String(key),
    })

    if err != nil {
        return fmt.Errorf("failed to download file %s: %w", outputPath, err)
    }

    fmt.Printf("Successfully downloaded %d bytes to %s in %s\n", numBytes, outputPath, time.Since(start))
    return nil
}
分段传输不仅提升了速度,还增强了操作的健壮性。即使某个分段传输失败,S3也只会重试该分段,而不是整个文件,这对于不稳定的网络环境尤其重要。
除了分段传输,还有哪些Golang技术可以进一步提升S3操作性能?
除了分段传输这个大杀器,还有一些Golang层面的优化技巧,它们虽然可能不如分段传输那么立竿见影,但对于构建一个真正健壮且高效的S3客户端至关重要。
首先是HTTP连接池的精细化配置。AWS SDK for Go v2底层使用的是Go标准库的net/http包。默认的http.DefaultTransport配置可能并不适合高并发场景。我们可以通过自定义http.Client和http.Transport来优化连接复用。MaxIdleConns、MaxIdleConnsPerHost和IdleConnTimeout是关键参数。增大MaxIdleConnsPerHost可以确保在与S3的单个端点之间保持足够的空闲连接,减少TCP握手和TLS协商的开销。
import (
    "net/http"
    "time"

    "github.com/aws/aws-sdk-go-v2/aws"
    "github.com/aws/aws-sdk-go-v2/config"
    "github.com/aws/aws-sdk-go-v2/service/s3"
)

func createOptimizedS3Client(ctx context.Context, region string) (*s3.Client, error) {
    // Custom HTTP client with optimized transport settings
    tr := &http.Transport{
        MaxIdleConns:        100,              // Total maximum idle connections across all hosts
        MaxIdleConnsPerHost: 20,               // Maximum idle connections to a single host (S3 endpoint)
        IdleConnTimeout:     90 * time.Second, // How long an idle connection is kept alive
        DisableKeepAlives:   false,            // Ensure keep-alives are enabled
        // You might also consider ResponseHeaderTimeout, ExpectContinueTimeout for specific scenarios
    }
    httpClient := &http.Client{
        Transport: tr,
        Timeout:   30 * time.Second, // Overall request timeout
    }

    cfg, err := config.LoadDefaultAWSConfig(ctx, config.WithRegion(region))
    if err != nil {
        return nil, fmt.Errorf("failed to load AWS config: %w", err)
    }

    // Override the default HTTP client in the AWS SDK
    s3Client := s3.NewFromConfig(cfg, func(o *s3.Options) {
        o.HTTPClient = httpClient
    })

    return s3Client, nil
}其次,工作池(Worker Pool)模式。当你需要处理大量独立的小文件操作(例如,列出桶内所有文件并对每个文件执行一个操作),或者需要限制并发请求的数量以避免S3限流时,一个自定义的Goroutine工作池会非常有用。这比简单地为每个操作启动一个Goroutine更可控。
// Simplified worker pool example for processing S3 objects
func processS3ObjectsConcurrently(ctx context.Context, s3Client *s3.Client, bucket string, objectKeys []string, numWorkers int) {
    jobs := make(chan string, len(objectKeys))
    results := make(chan error, len(objectKeys))

    // Start workers
    for i := 0; i < numWorkers; i++ {
        go func() {
            for key := range jobs {
                // Simulate an S3 operation, e.g., get object metadata
                _, err := s3Client.HeadObject(ctx, &s3.HeadObjectInput{
                    Bucket: aws.String(bucket),
                    Key:    aws.String(key),
                })
                if err != nil {
                    results <- fmt.Errorf("failed to head object %s: %w", key, err)
                    continue
                }
                results <- nil // Success
            }
        }()
    }

    // Send jobs
    for _, key := range objectKeys {
        jobs <- key
    }
    close(jobs)

    // Collect results
    for i := 0; i < len(objectKeys); i++ {
        err := <-results
        if err != nil {
            fmt.Printf("Error processing object: %v\n", err)
        }
    }
    fmt.Println("All objects processed.")
}再次,context包的合理使用。对于所有S3操作,都应该传入一个带有超时或取消功能的context.Context。这能有效避免长时间挂起的请求,尤其是在网络不稳定或S3服务暂时不可用时。它允许你在外部控制请求的生命周期,避免资源泄露。
// Example with timeout context
ctx, cancel := context.WithTimeout(context.Background(), 5*time.Second)
defer cancel() // Always call cancel to release resources

// Use this ctx in your S3 operations
_, err := s3Client.GetObject(ctx, &s3.GetObjectInput{...})
if err != nil {
    if errors.Is(ctx.Err(), context.DeadlineExceeded) {
        fmt.Println("S3 GetObject timed out!")
    } else {
        fmt.Printf("S3 GetObject failed: %v\n", err)
    }
}最后,字节切片([]byte)的复用。在处理大量数据时,如果频繁地创建和销毁大的字节切片,会给Go的垃圾回收器带来不小的压力,导致GC暂停,从而影响性能。sync.Pool可以帮助你复用这些缓冲区。虽然S3 SDK内部可能已经做了部分优化,但对于自定义的数据处理流程,这仍然是一个值得考虑的策略。
这些技术结合起来,可以让你在Golang中构建一个既高性能又健壮的S3客户端,应对各种复杂的云存储场景。
文中关于的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《Golang优化S3高性能客户端实现》文章吧,也可关注golang学习网公众号了解相关技术文章。
 上班族AI工具夜校学习指南与课程推荐
- 上一篇
- 上班族AI工具夜校学习指南与课程推荐

- 下一篇
- B站未成年直播时间限制详解
-
- Golang · Go教程 | 49分钟前 |
- 用类型约束实现数值聚合而不牺牲可读性
- 182浏览 收藏
-
- Golang · Go教程 | 1小时前 | go · 分页查询 · database/sql ·
- 批量查询时按页扫描并及时检查 Rows 的最终错误
- 270浏览 收藏
-
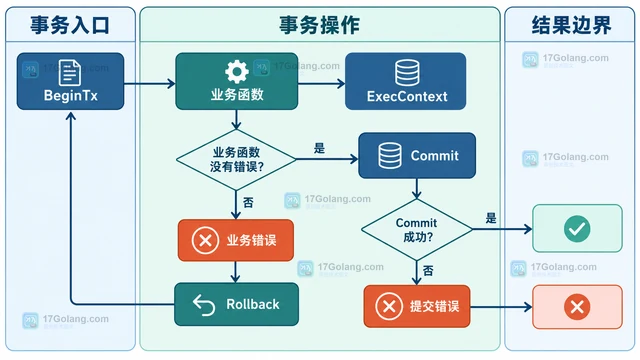
- Golang · Go教程 | 1小时前 | go · database/sql ·
- 在事务函数中保证提交失败也能返回准确错误
- 495浏览 收藏
-
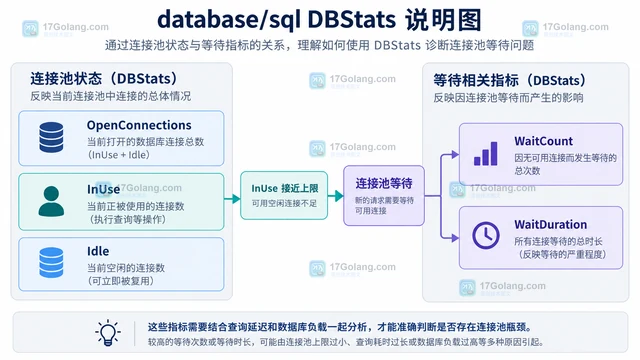
- Golang · Go教程 | 1小时前 | go · 连接池 · database/sql ·
- 为连接池设置上限、空闲数与生命周期并观察等待指标
- 171浏览 收藏
-
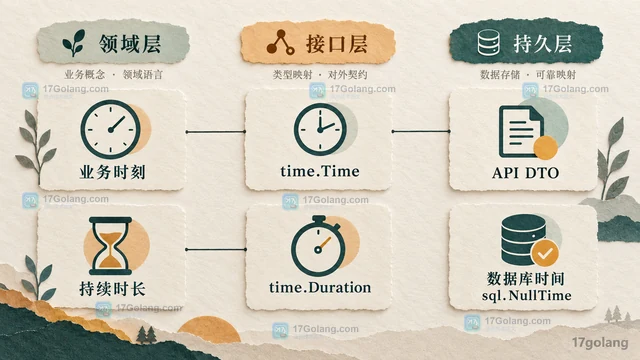
- Golang · Go教程 | 2小时前 | JSON · 时间处理 · Go教程 · database/sql · 后端开发 · RFC3339 Go时间序列化 time.Duration JSON 数据库时间戳 sql.NullTime
- 统一序列化业务时间、持续时长与数据库时间戳
- 212浏览 收藏
-
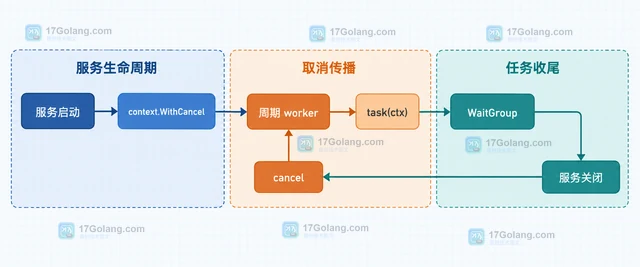
- Golang · Go教程 | 2小时前 |
- 用 Ticker 驱动周期任务并确保停止后资源释放
- 491浏览 收藏
-
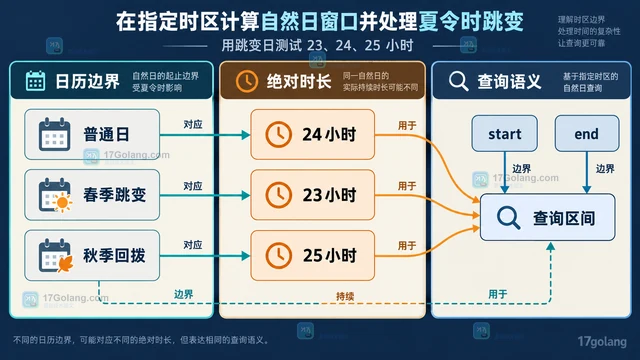
- Golang · Go教程 | 2小时前 | 时区 · 时间处理 · Go教程 · Go 夏令时 time.LoadLocation time.AddDate 自然日窗口
- 在指定时区计算自然日窗口并处理夏令时跳变
- 260浏览 收藏
-
- Golang · Go教程 | 3小时前 | 错误处理 · Go教程 · 文件系统 · Go 文件权限 目录遍历 filepath.WalkDir fs.SkipDir
- 遍历目录时跳过无权限分支并汇总可读文件
- 325浏览 收藏
-
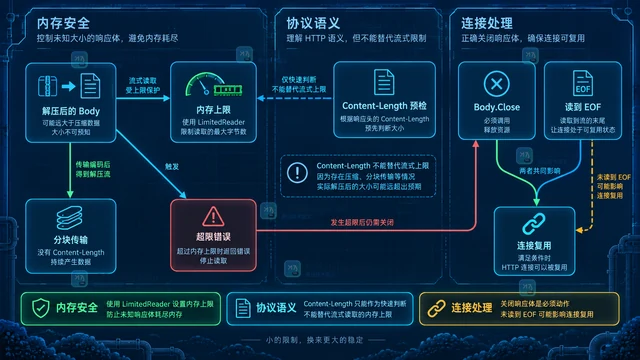
- Golang · Go教程 | 21小时前 | Go教程 · HTTP客户端 · 后端开发 · io.ReadAll io.LimitReader Go HTTP客户端 Go LimitedReader 响应体大小限制
- 通过 LimitedReader 防止未知响应体耗尽内存
- 166浏览 收藏
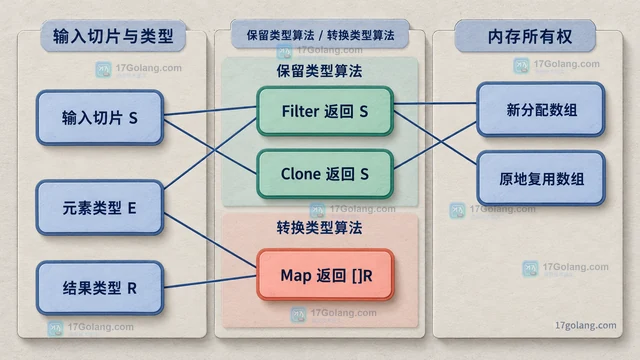
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 375次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 446次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 454次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 399次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 226次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览