
本地部署大模型测试,DeepSeek-R1性能依然出色
欢迎各位小伙伴来到golang学习网,相聚于此都是缘哈哈哈!今天我给大家带来《本地部署大模型测试,DeepSeek-R1-0528-Qwen-8B 性能依旧强劲》,这篇文章主要讲到等等知识,如果你对文章相关的知识非常感兴趣或者正在自学,都可以关注我,我会持续更新相关文章!当然,有什么建议也欢迎在评论留言提出!一起学习!
 图片大家好,我是 ai 学习的老章
今天分享一个我最近频繁使用的大模型并发压力测试工具,并实测一下我在双 4090 显卡上本地部署的 DeepSeek-R1-0528-Qwen-8B 模型的实际表现。
这是我目前最钟爱的三个 DeepSeek 蒸馏版本之一
DeepSeek-R1-0528 基于 Qwen3:8B 进行知识蒸馏优化,配合双 4090 实现本地高效推理,性能与效果兼备,深得我心
LLM-Benchmark 工具介绍
项目地址:https://github.com/lework/llm-benchmark
LLM-Benchmark 是一款专为大语言模型设计的自动化并发性能压测工具,适用于开发者和运维人员对本地或远程 LLM 服务进行系统性性能评估。它支持从低负载到高并发的多阶段测试,帮助定位瓶颈、优化部署策略。
核心功能亮点:
- 多阶段压力测试:支持从 1 到 300 并发逐步加压,观察模型在不同负载下的表现。
- 自动化数据采集:自动记录每轮测试的响应时间、吞吐量、错误率等关键指标。
- 可视化性能报告:生成结构化报告,直观展示 RPS、延迟、TPS 等趋势变化。
- 长短文本双模式测试:覆盖短问答与长上下文生成场景,贴近真实应用。
- 高度可配置:通过命令行灵活设置模型名、URL、并发数、请求数等参数。
- JSON 输出支持:便于后续分析或集成至 CI/CD 流程。
主要文件说明:
run_benchmarks.py:主测试脚本,执行全量多轮测试,自动生成汇总报告。
llm_benchmark.py:核心压测逻辑,处理并发请求、连接池管理及流式响应测试。
assets/:存放测试用资源文件。
README.md:详细使用文档与参数说明。
使用方式
1. 执行完整性能测试(推荐)
运行以下命令进行全量多并发测试,适合全面评估模型服务能力:
python run_benchmarks.py \ --llm_url "http://your-llm-server" \ --api_key "your-api-key" \ --model "your-model-name" \ --use_long_context
参数说明:
- --llm_url:目标 LLM 服务地址(必填)
- --api_key:认证密钥(可选)
- --model:模型名称(默认为 deepseek-r1)
- --use_long_context:启用长文本测试模式(默认关闭)
2. 单次并发测试(按需定制)
若只想测试特定并发级别,可使用单测脚本:
python llm_benchmark.py \ --llm_url "http://your-llm-server" \ --api_key "your-api-key" \ --model "your-model-name" \ --num_requests \ --concurrency
参数说明:
- --num_requests:总请求数(必填)
- --concurrency:并发数量(必填)
还可自定义输出 token 数、超时时间、输出格式等。
实测结果展示
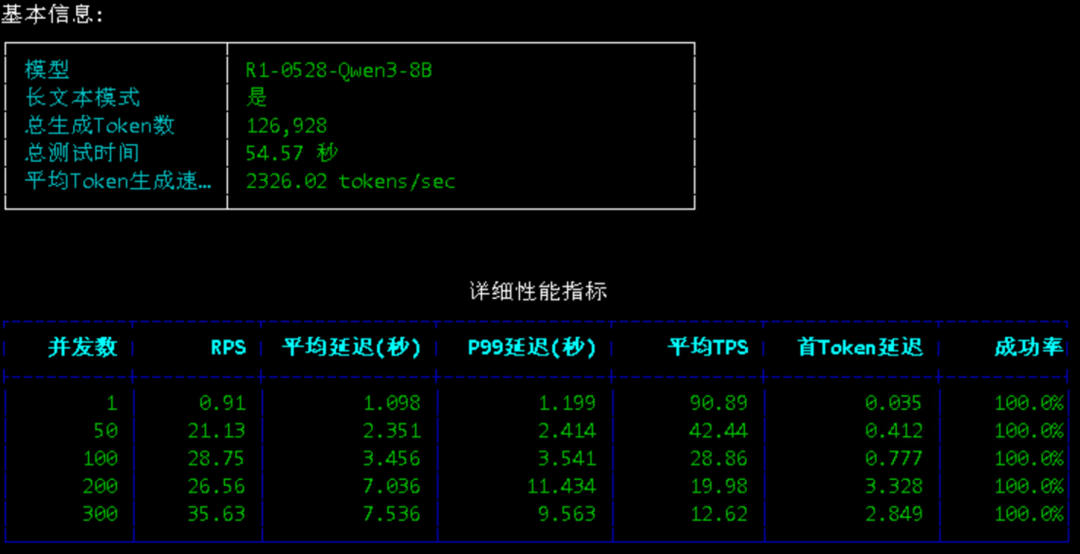
我使用如下命令对本地部署的模型进行全量长上下文测试:
python run_benchmarks.py \ --llm_url "http://localhost:8001/v1" \ --api_key "123" \ --model "R1-0528-Qwen3-8B" \ --use_long_context
测试结果如下图所示:
 图片
性能指标解读
RPS(每秒请求数)
衡量系统吞吐能力,RPS 越高,并发处理能力越强。测试中从单并发 0.91 提升至 300 并发下的 43.53,表现出色。平均延迟(秒)
用户体验的关键指标。低并发时仅 1.098 秒,300 并发上升至 12.62 秒,符合预期增长趋势。P99 延迟(秒)
反映极端情况下的响应稳定性。随着并发增加略有上升,但整体可控。平均 TPS(每秒生成 token 数)
衡量模型生成效率。峰值达 90.89 tokens/s,在 50 并发下仍保持 42.44,表现优异。首 Token 延迟(秒)
影响交互即时感。低并发下低至 0.035 秒,但在 200/300 并发时升至约 2.85 秒,说明高负载下启动响应略有延迟。成功率
所有测试场景下均为 100%,无请求失败,稳定性极佳。
对比主流平台 DeepSeek API 实际生成速度
| 平台 | 生成速度(tokens/s) | 备注 |
|---|---|---|
| DeepSeek-V3 官方宣称 | 60 | 官方数据 |
| DeepSeek-R1 实测(Content部分) | 37.76 | 118 tokens / 3.12s |
| DeepSeek-R1 总体实测 | 33.01 | 436 tokens / 13.21s |
| 深圳本地测试 DeepSeek 官方服务 | 37.117(生成),25.378(推理) | —— |
| 火山引擎(深圳) | 65.673 | 成都节点高达 72.276 |
| 火山引擎(六平台评测均值) | 32(生成),29(推理) | 稳定性突出 |
| 硅基流动(深圳) | 16.966 | —— |
| 阿里云百炼(深圳) | 11.813 | 存在明显时段波动 |
| 讯飞开放平台 | 1.2(推理均值) | 表现较弱 |
| Meta Llama API(Cerebras) | 高达 2600 | Llama 4 Cerebras |
| Groq(Llama 4 Scout) | 460 | 极速推理硬件支持 |
总结
在本地资源有限的前提下,DeepSeek-R1-0528-Qwen-8B 配合双 4090 显卡部署方案,依然是我心中最均衡、最实用的选择。
无论是吞吐能力、响应速度还是稳定性,实测表现都令人满意,尤其在中等并发下兼顾了效率与体验。相比部分公有云 API 的波动性,本地部署更可控、更安全、成本更低。
如果你也在寻找一款适合本地运行的高性能蒸馏模型,强烈推荐尝试这个组合!
今天关于《本地部署大模型测试,DeepSeek-R1性能依然出色》的内容介绍就到此结束,如果有什么疑问或者建议,可以在golang学习网公众号下多多回复交流;文中若有不正之处,也希望回复留言以告知!
 HTML表单默认值设置及value属性详解
- 上一篇
- HTML表单默认值设置及value属性详解
- 下一篇
- HTML地理定位实现与GeolocationAPI使用详解
-
- 文章 · 软件教程 | 1天前 | 软件教程 · VS Code 自定义指令 GitHub Copilot 项目作用域
- GitHub Copilot 自定义指令文件的项目作用域
- 404浏览 收藏
-
- 文章 · 软件教程 | 1天前 |
- VS Code Tasks 组合前后端命令的依赖关系
- 308浏览 收藏
-
- 文章 · 软件教程 | 1天前 | 容器 · docker · 软件教程 · docker 构建缓存 buildx registry cache cache-to cache-from
- Docker Buildx 缓存导出到注册表的配置方法
- 425浏览 收藏
-
- 文章 · 软件教程 | 1天前 | 开发环境 · 软件教程 · devcontainer.json GitHub Codespaces 预构建
- GitHub Codespaces 预构建配置减少启动等待
- 324浏览 收藏
-
- 文章 · 软件教程 | 1天前 | figma · 设计系统 多主题 Figma Variables 颜色 token Light mode Dark mode
- Figma Variables 组织多主题界面颜色 token
- 115浏览 收藏
-
- 文章 · 软件教程 | 2天前 |
- Postman 环境变量分层管理测试凭据占位符
- 143浏览 收藏
-
- 文章 · 软件教程 | 2天前 |
- JetBrains Structural Search 批量定位 API 调用模式
- 459浏览 收藏
-
- 文章 · 软件教程 | 2天前 | docker · 软件教程 · 多环境配置 env_file Docker Compose include Compose 文件拆分 compose.override.yaml
- Docker Compose include 拆分多环境服务定义
- 129浏览 收藏
-
- 文章 · 软件教程 | 2天前 |
- GitHub Actions reusable workflow 传递矩阵参数
- 449浏览 收藏
-
- 文章 · 软件教程 | 2天前 | Git rebase 交互式变基 保留合并提交 rebase merges
- Git 交互式变基保留合并提交的操作路径
- 477浏览 收藏
-
- 文章 · 软件教程 | 2天前 | 开发环境 · vs code · 软件教程 · devcontainer.json VS Code Dev Containers Dev Container Features 容器开发环境 开发工具复用
- VS Code Dev Containers 复用 Features 的开发环境配置
- 378浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 441次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 513次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 529次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 471次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 299次使用
-
- VS Code 怎么给 Go 项目配置测试任务:tasks.json 运行与结果验收
- 2026-07-09 501浏览
-
- Windows 11 如何开启 HEIF 图片支持
- 2026-05-31 501浏览
-
- TikTok用户画像与付费订阅变现方法
- 2026-05-27 501浏览
-
- 学信网学历翻译件申请方法
- 2026-05-27 501浏览
-
- Windows 11 24H2 更新失败0x80070005解决方法
- 2026-05-26 501浏览


