
HTML表单防欺诈提交方法有哪些
小伙伴们有没有觉得学习文章很有意思?有意思就对了!今天就给大家带来《HTML表单如何防欺诈提交?》,以下内容将会涉及到,若是在学习中对其中部分知识点有疑问,或许看了本文就能帮到你!
HTML表单欺诈检测的核心是构建从前端到后端再到行为分析的多层防御体系,以识别并阻断虚假或恶意提交。首先,前端验证通过HTML5属性和JavaScript实现即时反馈,提升用户体验并过滤明显错误,但因其可被轻易绕过,仅作为初步筛选而非安全屏障。真正关键的是后端验证,它必须对所有数据进行严格校验,包括格式、类型、业务逻辑一致性,并实施蜜罐陷阱、时间戳校验、CSRF Token、IP与用户代理分析等机制,确保数据真实可信。在此基础上,高级策略进一步增强识别能力:通过行为指纹分析鼠标轨迹、输入节奏等用户行为模式,识别非人类操作;结合IP信誉库和地理位置判断来源风险;利用浏览器指纹技术追踪设备特征;引入机器学习模型从海量历史数据中挖掘潜在欺诈规律;并集成Google reCAPTCHA Enterprise等第三方专业服务,提升整体防御精度。最终,该体系需以前端为门卫、后端为堡垒、行为分析为雷达,形成闭环,持续迭代应对不断进化的欺诈手段,确保业务安全与数据纯净。

HTML表单的欺诈检测,核心在于建立一套多层次的验证与识别机制,从用户行为到数据内容,全方位地捕捉异常。这并非单一技术可以解决的问题,而是前端、后端乃至更高级的行为分析手段的综合运用,目的是识别那些非正常、非人类或带有恶意意图的提交。简单来说,就是让坏家伙无处遁形,或者至少,让他们付出的代价远超收益。
解决方案
要有效识别并防范HTML表单的虚假提交或欺诈行为,我们需要构建一个从前端到后端,再结合行为分析的立体防御体系。这不仅仅是技术层面的堆砌,更是一种安全意识的渗透,确保数据的纯净与业务的正常运行。
首先,前端验证是第一道防线,它能快速筛掉一些明显不合规的数据,比如格式错误、必填项缺失等。但这更多是为了提升用户体验和减轻服务器压力,因为前端的任何校验逻辑都可以被绕过。所以,真正的战场在后端。
在服务器端,我们需要对所有接收到的数据进行严格的二次验证。这包括但不限于数据类型、长度、格式、业务逻辑的合法性检查。比如,一个邮箱地址必须符合邮箱的正则规则,年龄必须在合理范围内。同时,加入一些“反欺诈”的特定机制至关关重要,例如:
- 蜜罐陷阱 (Honeypot Fields): 在表单中设置一个对普通用户不可见,但对机器人可见的隐藏字段。如果这个字段被填写了,那么基本可以断定这是一次机器人提交。
- 时间戳校验 (Timestamp Verification): 记录表单加载的时间和服务端接收到提交的时间。如果提交时间过短(比如几毫秒),远低于人类正常填写表单所需的时间,那么很可能就是机器自动提交。
- CSRF Token (跨站请求伪造令牌): 为每个表单生成一个唯一的、随机的令牌,并将其存储在用户的会话中。提交时,服务器验证提交的令牌是否与会话中的匹配。这能有效防止未经授权的跨站提交。
- 验证码 (CAPTCHA/reCAPTCHA): 通过图像、文字识别或行为分析(如Google reCAPTCHA v3的风险评分)来区分人类用户和机器人。虽然有时会影响用户体验,但在关键场景下仍是有效手段。
- IP与用户代理分析 (IP & User Agent Analysis): 检查提交请求的IP地址和用户代理字符串。异常的IP(如来自黑名单、代理服务器、异常地理位置)或非标准的用户代理都可能是可疑的信号。
最终,所有这些验证都应该在后端进行,并且任何一项验证失败,都应该直接拒绝该次提交,而不是仅仅给出警告。
如何利用前端技术初步筛选可疑提交?
前端技术在表单欺诈检测中,扮演的角色更像是“门卫”而非“保安队长”。它的主要职责是提供即时反馈,提升用户体验,并过滤掉一些粗糙的、非恶意的输入错误。你可以用HTML5的内置验证属性,比如required, type="email", pattern, minlength, maxlength等,这些能让浏览器在用户提交前就进行基础检查。
举个例子,一个简单的就能在客户端层面确保输入的邮箱格式大致正确且不为空。JavaScript也可以用来实现更复杂的实时验证,比如密码强度检查,或者两次密码输入是否一致。我个人习惯在用户输入时就给出提示,这样能减少提交后的错误信息。
但需要特别强调的是,前端的任何校验,包括JavaScript,都可以被熟练的用户或自动化脚本轻易绕过。他们可以直接修改HTML、禁用JavaScript,甚至通过API工具直接发送请求到后端,完全跳过前端界面。所以,你不能指望前端验证能阻止任何有恶意意图的提交。它更像是一个友好的提醒,告诉用户“嘿,你是不是输错了?”而不是一个坚固的防线。因此,它的主要价值在于用户体验和减轻后端服务器的负担,而不是作为安全保障。
后端验证在防范表单欺诈中扮演了什么关键角色?
后端验证,毫无疑问,是防范表单欺诈的最后一道、也是最坚固的防线。你可以把前端想象成一个敞开的迎宾大厅,后端才是那个有重兵把守的保险库。任何数据,无论前端是否通过,都必须在后端进行严格的重新审查。
这不仅仅是重复前端的那些校验。后端验证需要深入到业务逻辑层面。比如,一个注册表单,后端不仅要检查邮箱格式,还要查询数据库,确保这个邮箱地址尚未被注册。这就是业务逻辑验证。再比如,一个订单提交,后端需要验证库存是否充足,价格是否被篡改。
除了基础的数据类型、长度、格式、必填项校验之外,后端还必须处理更复杂、更隐蔽的欺诈模式:
- 数据完整性与一致性校验: 确保提交的数据没有被篡改,并且字段之间逻辑自洽。例如,如果表单中包含一个下拉菜单选择的商品ID和对应的价格,后端需要根据商品ID去数据库查询真实价格,而不是直接信任前端提交的价格。
- 反爬虫与反批量提交:
- 蜜罐字段检测: 这是非常有效且对用户无感的反机器人手段。在表单中偷偷放一个
display:none或opacity:0的隐藏输入框。正常用户看不到,也不会填写。但自动化脚本可能会“尽职尽责”地填充所有可见和不可见的字段。后端只需要检查这个隐藏字段是否有值,有值则直接判断为机器人提交。 - 时间戳间隔检查: 记录用户会话开始时间或表单加载时间,与表单提交时间进行对比。如果提交速度快得不合常理(比如0.5秒就填完一个复杂表单),则可能是机器人。
- 会话跟踪与提交频率限制: 限制单个IP或单个用户会话在特定时间内的提交次数。例如,一个IP地址每分钟只能提交一次注册表单。
- 蜜罐字段检测: 这是非常有效且对用户无感的反机器人手段。在表单中偷偷放一个
- 安全令牌验证 (CSRF Token): 这是防止跨站请求伪造的关键。服务器在渲染表单时生成一个随机的、唯一的CSRF token,嵌入到表单的隐藏字段中,并存储在用户的会话里。当表单提交时,后端会验证提交上来的token是否与会话中的匹配。如果不匹配,则拒绝请求。这能有效防止攻击者诱骗用户在其他网站上提交恶意请求到你的应用。
- 输入消毒与编码: 这虽然不是直接的“欺诈检测”,但却是防止恶意提交(如SQL注入、XSS攻击)的基础。所有用户输入的数据在被存储或显示之前,都必须进行适当的消毒(sanitization)和编码(encoding),移除或转义潜在的恶意代码。
后端验证是构建安全Web应用的核心,它确保了即使前端被绕过,恶意数据也无法进入你的系统。
除了基础验证,还有哪些高级策略能提升欺诈识别能力?
当基础的前后端验证已经部署到位后,我们还可以考虑一些更高级的策略来进一步提升欺诈识别的精准度,尤其是在面对更复杂的、模拟人类行为的欺诈时。这些方法往往涉及对用户行为模式的分析和外部数据的利用。
- 行为指纹与异常检测: 这是一个更宏观的层面。我们可以收集用户的行为数据,比如鼠标移动轨迹、键盘输入速度、页面停留时间、滚动行为等。正常人类的行为模式与机器人或自动化脚本有显著差异。例如,机器人通常会以极快的速度、直线路径填充表单,而人类则会有犹豫、修正、不规则的鼠标移动。通过分析这些“行为指纹”,可以建立用户行为模型,一旦发现与正常模式显著偏离的行为,就标记为可疑。当然,这通常需要借助专门的第三方服务或复杂的内部系统。
- IP信誉度与地理位置分析: 不仅仅是简单地记录IP,还可以利用IP信誉度数据库(如Spamhaus、MaxMind等)来判断某个IP是否来自已知的恶意IP池、代理服务器、VPN或Tor网络。如果一个表单提交来自一个高风险的IP,即使其他验证都通过了,也应该提高警惕。结合地理位置信息,如果一个用户声称来自北京,但其IP却显示在美国,这显然是一个可疑点。
- 用户代理(User Agent)与浏览器特征分析: 除了简单的User Agent字符串,还可以分析其更深层的特征。有些自动化工具或爬虫会使用非标准或伪造的User Agent。通过检测这些异常,或者更进一步,通过Canvas指纹、WebGL指纹等浏览器指纹技术,来识别同一浏览器(或机器人)的多次访问,即使IP地址发生变化。
- 机器学习与模式识别: 对于大规模的表单提交,人工分析会变得不切实际。这时,机器学习模型就能派上用场。通过收集大量的历史提交数据(包括正常和已知的欺诈数据),训练模型去识别欺诈模式。例如,模型可以学习到,来自特定IP段、使用特定邮箱后缀、并在非工作时间提交的表单,其欺诈概率更高。这种方法能够发现人工难以察觉的复杂关联和潜在模式。
- 第三方验证服务集成: 许多专业的第三方服务(如Google reCAPTCHA Enterprise, Akismet for spam detection, Sift Science for fraud prevention)提供了更强大的欺诈识别能力。它们通常拥有庞大的全球数据网络和先进的算法,能够更有效地识别和阻止各种类型的欺诈行为,同时尽量减少对正常用户的干扰。
实施这些高级策略,往往需要更多的技术投入和数据积累,但它们能够显著提升欺诈识别的深度和广度,让你的HTML表单防御体系更加坚不可摧。记住,欺诈者总在进化,我们的防御也必须持续迭代。
今天带大家了解了的相关知识,希望对你有所帮助;关于文章的技术知识我们会一点点深入介绍,欢迎大家关注golang学习网公众号,一起学习编程~
 Golang指针运算vsC语言指针对比解析
- 上一篇
- Golang指针运算vsC语言指针对比解析

- 下一篇
- K6函数会等待异步方法完成吗?
-
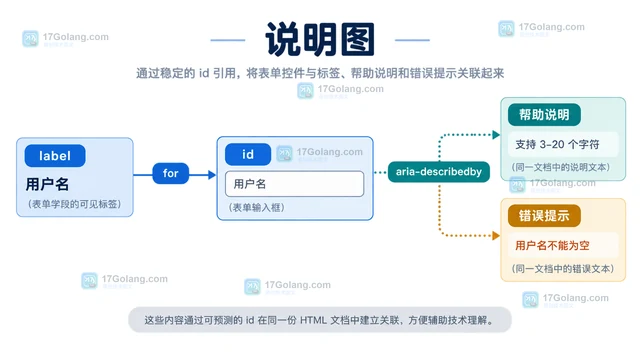
- 文章 · 前端 | 21小时前 |
- 表单 aria-describedby 关联错误提示的可访问设计
- 349浏览 收藏
-
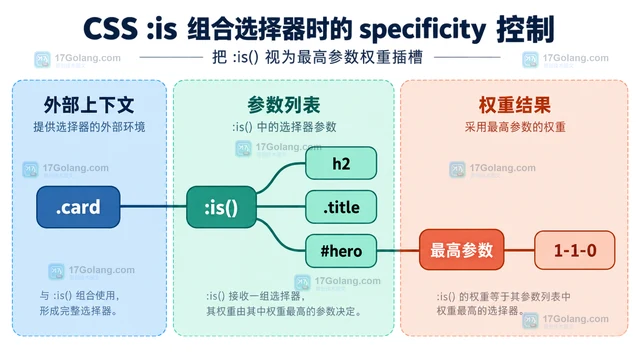
- 文章 · 前端 | 1天前 | 前端 · css · 组合选择器 CSS :is specificity :where 级联层
- CSS :is 组合选择器时的 specificity 控制
- 327浏览 收藏
-
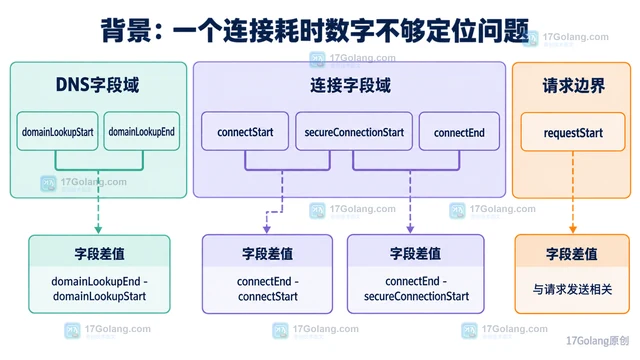
- 文章 · 前端 | 1天前 | javascript · DNS耗时 PerformanceResourceTiming TLS耗时
- PerformanceResourceTiming 拆分 DNS 与 TLS 耗时
- 108浏览 收藏
-
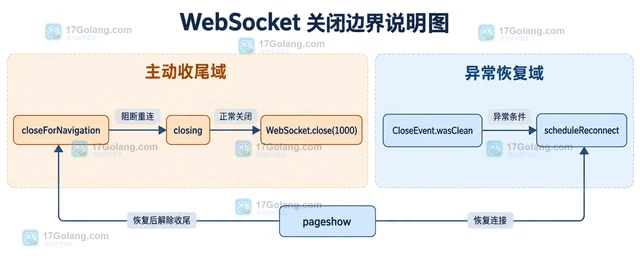
- 文章 · 前端 | 4天前 | 前端 · websocket ·
- WebSocket 重连退避与页面卸载的收尾
- 381浏览 收藏
-
- 文章 · 前端 | 4天前 |
- Fetch keepalive 处理页面卸载前的小请求
- 291浏览 收藏
-
- 文章 · 前端 | 4天前 |
- CSS @scope 限定组件样式作用域的迁移方法
- 294浏览 收藏
-
- 文章 · 前端 | 4天前 |
- View Transition API 在 SPA 状态切换中的降级方案
- 142浏览 收藏
-
- 文章 · 前端 | 4天前 | javascript · 表单 · FormData FormDataEvent formdata事件 原生表单
- FormDataEvent 统一拦截原生表单数据的实现
- 288浏览 收藏
-
- 文章 · 前端 | 5天前 | html · javascript · 表单 · requestSubmit form.submit HTML表单校验
- requestSubmit 与 form.submit 有什么区别
- 392浏览 收藏
-
- 文章 · 前端 | 5天前 |
- scheduler.yield 怎么把长任务拆开又保持优先级
- 110浏览 收藏
-
- 文章 · 前端 | 5天前 | CSS 滚动动画 animation-timeline scroll-timeline
- CSS scroll-timeline 怎么驱动滚动进度动画
- 251浏览 收藏
-
- 文章 · 前端 | 5天前 |
- IntersectionObserver scrollMargin 怎么处理嵌套滚动容器
- 380浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 312次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 370次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 364次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 333次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 155次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览


