
只要模型够大、样本够多,AI就可以变得更智能!
今日不肯埋头,明日何以抬头!每日一句努力自己的话哈哈~哈喽,今天我将给大家带来一篇《只要模型够大、样本够多,AI就可以变得更智能!》,主要内容是讲解等等,感兴趣的朋友可以收藏或者有更好的建议在评论提出,我都会认真看的!大家一起进步,一起学习!
AI模型与人脑在数学机制上并没有什么区别。
只要模型够大、样本够多,AI就可以变得更智能!
chatGPT的出现,实际上已经证明了这点。
1,AI和人脑的底层细节都是基于if else语句
逻辑运算,是产生智能的基础运算。
编程语言的基本逻辑是if else,它会根据条件表达式把代码分成两个分支。
在这个基础上,程序员可以写出非常复杂的代码,实现各种各样的业务逻辑。
人脑的基本逻辑也是if else,if else这两个词就来自英语,对应的中文词汇是如果...否则...
人脑在思考问题时也是这么一个逻辑思路,这点上跟电脑没有区别。

if else语句,逻辑的核心
AI模型的“if else语句”就是激活函数!
AI模型的一个运算节点,我们也可以叫它“神经元”。
它有一个输入向量X,一个权值矩阵W,一个偏置向量b,还有一个激活函数。
激活函数的作用实际就是if else语句,而WX + b这个线性运算就是条件表达式。
在激活之后,AI模型的代码相当于运行在 if分支,而不激活时相当于运行在else分支。
多层神经网络的不同激活状态,实际上也是对样本信息的二进制编码。

深度学习也是对样本信息的二进制编码
AI模型对样本信息的编码是动态的、并行的,而不是和CPU代码一样是静态的、串行的,但它们的底层基础都是if else。
在电路层面要实现if else并不难,一个三极管就可以实现。
2,人脑比电脑聪明,是因为人类获得的信息更多
人脑每时每刻都在获取外界的信息,每时每刻都在更新自己的“样本数据库”,但程序代码没法自我更新,这是很多人能做到的事而电脑做不到的原因。
人脑的代码是活的,电脑的代码是死的。
“死代码”当然不可能比“活代码”更聪明,因为“活代码”可以主动查找“死代码”的BUG。
而根据实数的连续性,只要“死代码”编码的信息是可数的,那么它就总存在编码不到的BUG点。
这在数学上可以用康托三分集来佐证。
不管我们用多少位的三进制小数去编码[0, 1]区间上的实数,总有至少1个点是没法编码进去的。
所以当两个人抬杠的时候,总是能找到可抬杠的点
但是电脑的代码一旦写好就没法主动更新了,所以程序员可以想出各种办法去欺骗CPU。
例如,intel的CPU本来要求在进程切换时要切换任务门的,但Linux就想出了一个办法只切换页目录和RSP寄存器
在intel CPU看来,Linux系统一直在运行同一个进程,但实际上不是。这就是所谓的进程软切换。
所以,只要CPU的电路固定了,那么CPU编码的信息也就固定了。
CPU编码的信息固定了,那么它编码不到的信息就是无限的,就是可以被程序员利用的。
而程序员之所以可以利用这种信息,是因为程序员的大脑是活的,可以动态的更新样本。
3,神经网络的出现改变了这种情况
神经网络真是一个伟大的发明,它在固定的电路上实现了动态的信息更新。
所有写好的程序能处理的信息都是固定的,包括CPU电路,也包括各种系统的代码。
但神经网络不是这样,它的代码虽然是写好的,但它只需要更新权值数据,就可以改变模型的逻辑脉络。
实际上只要不断地输入新样本,AI模型就可以不断地用BP算法(梯度下降算法)更新权值数据,从而适应新的业务场景。
AI模型的更新不需要修改代码,而只需要修改数据,所以同样的CNN模型用不同的样本训练,它就可以识别不同的物体。
在这个过程中,不管是tensorflow框架的代码,还是AI模型的网络结构都是不变的,变的是每个节点的权值数据。
理论上来说,只要AI模型可以通过网络抓取数据,它就可以变得更智能。
这跟人们通过浏览器看东西(从而变得更聪明),有本质的区别吗?好像也没有。
4,只要模型够大、样本够多,或许ChatGPT真可以挑战人脑
人脑有150亿个神经元,而且人的眼睛和耳朵每时每刻都在给它提供新的数据,AI模型当然也可以做到这点。
或许比起AI来,人类的优势在于“产业链”更短
一个婴儿的出生只需要Ta父母,但一个AI模型的诞生显然不是一两个程序员可以做到的。
仅仅是GPU的制造就不止几万人。
GPU上的CUDA程序并不难写,但GPU制造的产业链太长了,远不如人类的出生和成长。
这或许是AI相对于人的真正劣势。
到这里,我们也就讲完了《只要模型够大、样本够多,AI就可以变得更智能!》的内容了。个人认为,基础知识的学习和巩固,是为了更好的将其运用到项目中,欢迎关注golang学习网公众号,带你了解更多关于模型,语言,编程的知识点!
 首个千亿模型压缩算法 SparseGPT 来了,降低算力成本的同时保持高精度
- 上一篇
- 首个千亿模型压缩算法 SparseGPT 来了,降低算力成本的同时保持高精度

- 下一篇
- 下一代人工智能将在医疗保健领域开辟新天地
-
- 儒雅的宝马
- 这篇文章太及时了,好细啊,赞 ??,码住,关注作者大大了!希望作者大大能多写科技周边相关的文章。
- 2023-06-05 01:55:16
-
- 还单身的摩托
- 真优秀,一直没懂这个问题,但其实工作中常常有遇到...不过今天到这,帮助很大,总算是懂了,感谢楼主分享文章内容!
- 2023-05-02 11:24:04
-
- 科技周边 · 人工智能 | 13小时前 |
- MCP区分资源读取与工具调用的实现方法
- 359浏览 收藏
-
- 科技周边 · 人工智能 | 17小时前 | 错误处理 · 参数校验 · agent · openai api · AI工程 · Tool calling · 函数调用 业务错误 JSON Schema Tool calling strict 工具参数校验 模型错误
- Tool calling校验工具参数并区分模型与业务错误的实现方法
- 380浏览 收藏
-
- 科技周边 · 人工智能 | 18小时前 | openai api · 结构化输出 · AI工程 · Pydantic JSON Schema Structured Outputs
- Structured Outputs让模型结果贴合 JSON Schema的实现方法
- 191浏览 收藏
-
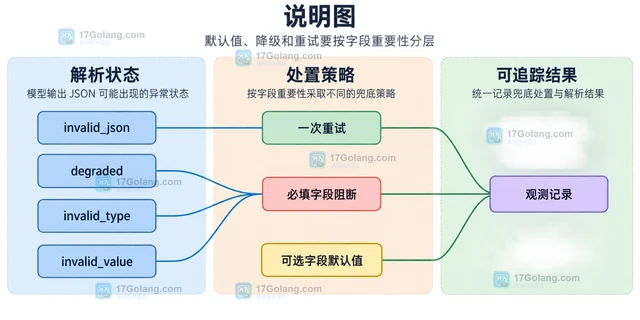
- 科技周边 · 人工智能 | 20小时前 | 人工智能 · 结构化输出 · JSON解析 · 模型输出 · 接口容错 · 大模型结构化输出 模型输出JSON缺字段 JSON兜底解析 JSON Schema校验 AI接口异常处理
- 模型输出 JSON 缺字段时如何设计兜底解析
- 272浏览 收藏
-
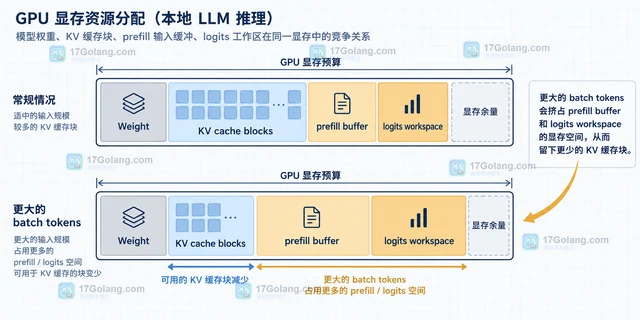
- 科技周边 · 人工智能 | 22小时前 | 人工智能 · 显存管理 · 推理优化 · 本地推理 KV Cache batch size
- 本地推理 KV cache 和 batch size 如何做取舍
- 251浏览 收藏
-
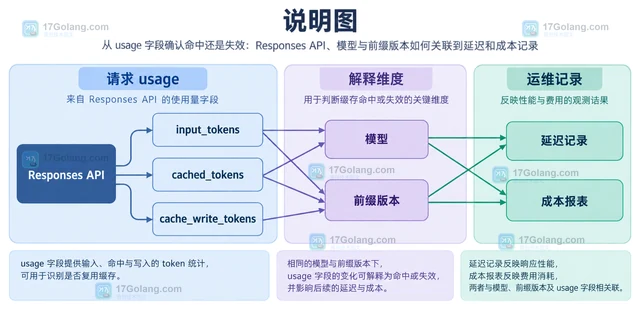
- 科技周边 · 人工智能 | 23小时前 | API · 性能优化 · ai · AI 提示词缓存 Responses API Prompt Caching
- AI 提示词缓存如何按稳定前缀组织请求
- 357浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- 分类评测集不均衡时如何比较 macro 与 micro 指标
- 473浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- Agent 工具返回文件路径时如何限制工作区范围
- 381浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- AI 流式响应中的 finish_reason 如何决定持久化时机
- 195浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- LoRA adapter 合并后 tokenizer 配置如何核对
- 162浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 49次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 146次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 81次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 51次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 31次使用
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览
-
- Canva手机闪退解决方法及适配指南
- 2026-05-25 501浏览


