
PythonDataclass嵌套序列化解决方法
在IT行业这个发展更新速度很快的行业,只有不停止的学习,才不会被行业所淘汰。如果你是文章学习者,那么本文《Python Dataclass 嵌套序列化难题解析》就很适合你!本篇内容主要包括##content_title##,希望对大家的知识积累有所帮助,助力实战开发!
引言:Dataclass 与序列化
Python 的 dataclasses 模块为创建结构化数据类提供了便利,极大地简化了数据模型的定义。通过装饰器 @dataclass,我们可以快速定义带有类型提示的类,并自动获得 __init__, __repr__, __eq__ 等方法。在数据处理中,将这些 dataclass 实例序列化为通用格式(如字典或 JSON)是常见的需求。dataclasses 模块提供了一个名为 asdict() 的函数,用于将 dataclass 实例递归地转换为字典。
考虑以下两个 dataclass 定义,它们描述了位置信息和一组位置信息:
from dataclasses import dataclass
from typing import Optional, Set, List

@dataclass(frozen=True)
class Location:
    x: int
    y: int

    # 为了方便排序或比较,这里添加了 __lt__ 方法,但与序列化问题无关
    def __lt__(self, other):
        return self.x < other.x and self.y < other.y

@dataclass
class Group:
    locations: Set[Location] # 注意这里使用了 Set
    name: str
问题剖析:set 类型与深度转换的冲突
当我们尝试将一个 Group 实例序列化为字典时,期望 locations 字段中的 Location 对象也能被递归地转换为字典。例如,对于以下 Group 实例:
import dataclasses

group = Group(locations={Location(x=0, y=1), Location(x=0, y=0)}, name='foo')
puzzle_dict = dataclasses.asdict(group)
print(puzzle_dict)
我们可能会期望得到如下的字典结构:
{'locations': {{'x': 1, 'y': 0}, {'x': 0, 'y': 0}}, 'name': 'foo'}然而,实际输出却是:
{'locations': {Location(x=0, y=1), Location(x=0, y=0)}, 'name': 'foo'}这表明 dataclasses.asdict() 并未对 set 内部的 Location 对象进行深度转换。更重要的是,即使 asdict() 尝试了深度转换,期望的输出结构本身在 Python 中也是无效的。
根本原因在于 Python 的哈希性(Hashability)规则。 set 是一种无序且元素唯一的集合类型,它要求其所有元素都必须是可哈希的 (hashable)。可哈希的对象在其生命周期内哈希值不变,并且可以与其他对象进行比较。Python 中的基本不可变类型(如整数、浮点数、字符串、元组)都是可哈希的。然而,字典 (dict) 是可变类型,因此它们是不可哈希的。
这意味着,即使 dataclasses.asdict() 能够将 Location 实例转换为字典,这些字典也无法作为 set 的元素。尝试手动创建一个包含字典的 set 会立即引发 TypeError:
>>> {{'x': 1, 'y': 0}, {'x': 0, 'y': 0}}
Traceback (most recent call last):
  File "", line 1, in
TypeError: unhashable type: 'dict'
因此,dataclasses.asdict() 在处理 set[Dataclass] 时,不会尝试将内部的 Dataclass 实例转换为字典,因为这样做会导致最终的 set 无法容纳这些不可哈希的字典,从而引发错误。它选择保留原始的 Dataclass 实例在 set 中。
解决方案:采用 list 类型
如果数据元素的顺序不重要,且需要支持 asdict() 的深度转换,最直接且有效的解决方案是将 set 类型替换为 list 类型。list 是一种有序且元素可重复的序列类型,它不要求其元素是可哈希的,因此可以包含字典。
修改 Group dataclass 的定义如下:
from dataclasses import dataclass
from typing import Optional, List # 将 Set 改为 List

@dataclass(frozen=True)
class Location:
    x: int
    y: int

    def __lt__(self, other):
        return self.x < other.x and self.y < other.y

@dataclass
class Group:
    locations: List[Location] # 现在是 List[Location]
    name: str
现在,当我们使用 dataclasses.asdict() 对修改后的 Group 实例进行序列化时,它将能够正确地递归转换 locations 列表中的每个 Location 实例:
import dataclasses

group = Group(locations=[Location(x=0, y=1), Location(x=0, y=0)], name='foo')
puzzle_dict = dataclasses.asdict(group)
print(puzzle_dict)
输出结果将是:
{'locations': [{'x': 0, 'y': 1}, {'x': 0, 'y': 0}], 'name': 'foo'}这正是我们期望的深度转换结果,其中 locations 字段现在是一个包含字典的列表。
总结与最佳实践
在 Python 中使用 dataclasses.asdict() 进行深度序列化时,理解底层数据结构的特性至关重要。
- 哈希性限制: Python 的 set 要求其元素必须是可哈希的。由于字典是可变类型,它们不可哈希,因此不能直接作为 set 的元素。
- asdict() 的行为: dataclasses.asdict() 在遇到 set 类型的字段时,不会尝试将内部的 dataclass 实例转换为字典,以避免产生一个包含不可哈希元素的 set。
- 解决方案: 如果你的数据模型中包含嵌套的 dataclass 集合,并且希望 asdict() 能够进行深度转换,同时对元素的顺序没有严格要求,那么将容器类型从 set 更改为 list 是最直接且推荐的解决方案。
- 特殊情况: 如果你确实需要保持集合的唯一性特性(即不允许重复元素),并且序列化后的结果必须是某种集合形式,你可能需要考虑更复杂的自定义序列化逻辑。例如,可以将 list[dict] 转换为 frozenset[frozendict](如果存在可哈希的字典实现)或在序列化后对列表进行排序并移除重复项。然而,对于大多数常见用例,list 类型足以满足 asdict() 的深度序列化需求。
通过理解这些核心概念,你可以更有效地设计和序列化你的 Python dataclass 模型。
理论要掌握,实操不能落!以上关于《PythonDataclass嵌套序列化解决方法》的详细介绍,大家都掌握了吧!如果想要继续提升自己的能力,那么就来关注golang学习网公众号吧!
 Golang自动Benchmark配置与分析教程
- 上一篇
- Golang自动Benchmark配置与分析教程
- 下一篇
- 戴尔笔记本0x0000009F故障解决方法
-
- 文章 · python教程 | 7小时前 |
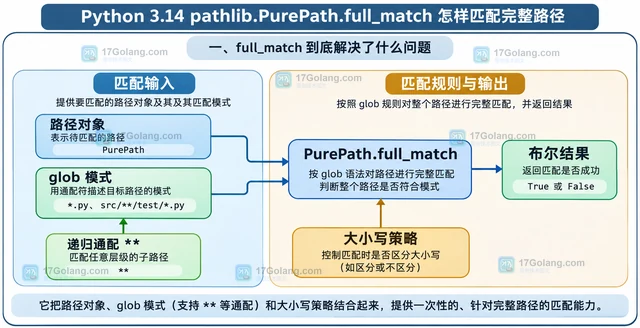
- Python 3.14 pathlib.PurePath.full_match怎样匹配完整路径
- 443浏览 收藏
-
- 文章 · python教程 | 7小时前 |
- Python os.reload_environ为什么读取不到外部环境变量
- 283浏览 收藏
-
- 文章 · python教程 | 7小时前 |
- Python operator.is_none 怎样判断值是否为 None
- 229浏览 收藏
-
- 文章 · python教程 | 7小时前 | 标准库 · csv · python · Python csv csv.field_size_limit CSV超长字段
- Python csv.field_size_limit 怎样处理超长字段
- 301浏览 收藏
-
- 文章 · python教程 | 7小时前 | python · pathlib · Python 硬链接 pathlib Path.hardlink_to
- Python pathlib.Path.hardlink_to 创建硬链接的跨设备报错处理
- 486浏览 收藏
-
- 文章 · python教程 | 7小时前 | 线程池 · Python gil threadpoolexecutor Python 3.14 free-threading CPU并发
- Python免费线程模式评估CPU并发
- 200浏览 收藏
-
- 文章 · python教程 | 7小时前 | 兼容性 · Python API迁移 DeprecationWarning Python 3.14 warnings.deprecated 类型检查器
- Python warnings.deprecated怎样标记即将移除的API
- 334浏览 收藏
-
- 文章 · python教程 | 7小时前 |
- Python 3.14 fnmatch.filterfalse怎样筛掉匹配文件
- 133浏览 收藏
-
- 文章 · python教程 | 7小时前 | 兼容性 · Python 类型注解 循环引用 延迟求值 Python 3.14 annotationlib ForwardRef
- Python 3.14延迟求值注解解决循环引用
- 282浏览 收藏
-
- 文章 · python教程 | 7小时前 | python · Python Template 模板字符串 Python 3.14
- Python 3.14模板字符串处理动态文本
- 344浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1043次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1041次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1193次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1143次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 989次使用
-
- Python TaskGroup 怎样让子任务失败统一收敛
- 2026-11-12 501浏览
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览


