
HadoopLinux分布式计算实现方法
大家好,今天本人给大家带来文章《Hadoop如何在Linux实现分布式计算》,文中内容主要涉及到,如果你对文章方面的知识点感兴趣,那就请各位朋友继续看下去吧~希望能真正帮到你们,谢谢!
Hadoop是一个开源的分布式计算框架,它支持用户利用简化的编程模型来存储和处理分布在计算机集群中的大量数据。Hadoop的关键组成部分包括Hadoop分布式文件系统(HDFS)以及MapReduce计算框架。下面是在Linux系统中搭建Hadoop分布式计算环境的主要步骤:
1. 准备工作
安装Java环境:Hadoop依赖于Java,所以要保证每个节点都安装了同一版本的Java。
sudo apt-get update sudo apt-get install openjdk-8-jdk设置SSH免密登录:这有助于简化集群内的管理工作。
  ssh-keygen -t rsa
  ssh-copy-id user@node2
  ssh-copy-id user@node3
2. 获取并解压Hadoop
下载Hadoop:从Apache Hadoop官方网站获取最新版的Hadoop。
wget https://archive.apache.org/dist/hadoop/common/hadoop-3.3.1/hadoop-3.3.1.tar.gz解压缩Hadoop:
tar -xzvf hadoop-3.3.1.tar.gz -C /usr/local/设定环境变量:修改/etc/profile或者~/.bashrc文件,加入Hadoop路径。
  export HADOOP_HOME=/usr/local/hadoop-3.3.1
  export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin
  source /etc/profile
3. 配置Hadoop集群
调整core-site.xml:定义HDFS的URI。
fs.defaultFS hdfs://namenode:9000 修改hdfs-site.xml:设置HDFS的副本数量及其他参数。
dfs.replication 3 dfs.namenode.name.dir /path/to/namenode/data dfs.datanode.data.dir /path/to/datanode/data 更新mapred-site.xml:配置MapReduce框架。
mapreduce.framework.name yarn 更改yarn-site.xml:配置YARN资源管理器。
yarn.nodemanager.aux-services mapreduce_shuffle yarn.nodemanager.aux-services.mapreduce.shuffle.class org.apache.hadoop.mapred.ShuffleHandler
4. 初始化HDFS
在NameNode服务器上运行以下命令以初始化HDFS:
hdfs namenode -format5. 开启Hadoop集群
启动NameNode和SecondaryNameNode:
start-dfs.sh激活YARN ResourceManager和NodeManager:
start-yarn.sh
6. 检查集群状况
核查HDFS状态:
hdfs dfsadmin -report确认YARN状态:
yarn node -list
7. 执行MapReduce任务
创建一个基础的MapReduce应用程序,并将其部署到集群运行。比如,可以使用Hadoop自带的WordCount实例:
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class WordCount {
    public static void main(String[] args) throws Exception {
        Configuration conf = new Configuration();
        Job job = Job.getInstance(conf, "word count");
        job.setJarByClass(WordCount.class);
        job.setMapperClass(TokenizerMapper.class);
        job.setCombinerClass(IntSumReducer.class);
        job.setReducerClass(IntSumReducer.class);
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(IntWritable.class);
        FileInputFormat.addInputPath(job, new Path(args[0]));
        FileOutputFormat.setOutputPath(job, new Path(args[1]));
        System.exit(job.waitForCompletion(true) ? 0 : 1);
    }
}
构建并打包后,使用如下命令提交任务:
hadoop jar WordCount.jar WordCount input output遵循上述流程,你便能在Linux平台上建立起一个有效的Hadoop分布式计算集群。
本篇关于《HadoopLinux分布式计算实现方法》的介绍就到此结束啦,但是学无止境,想要了解学习更多关于文章的相关知识,请关注golang学习网公众号!
 JavaScript如何创建链表?
- 上一篇
- JavaScript如何创建链表?
- 下一篇
- Golang文件IO测试:fstest模拟文件系统
-
- 文章 · linux | 6小时前 | Linux · 运维 · GNU tar 增量归档 listed-incremental exclude-from CACHEDIR.TAG
- tar 增量归档排除缓存目录的参数组合
- 324浏览 收藏
-
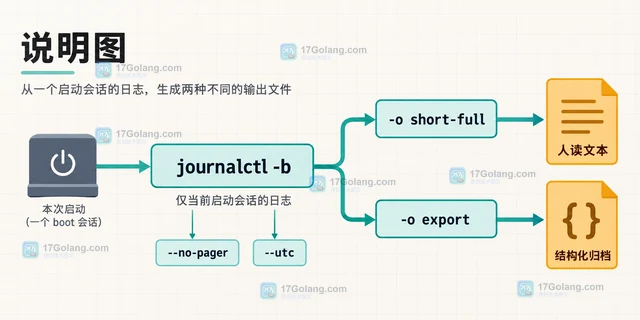
- 文章 · linux | 3天前 | Linux · 运维 · 日志排查 · journalctl 启动日志 Boot ID --list-boots systemd日志导出
- journalctl 按启动会话筛选并导出日志
- 369浏览 收藏
-
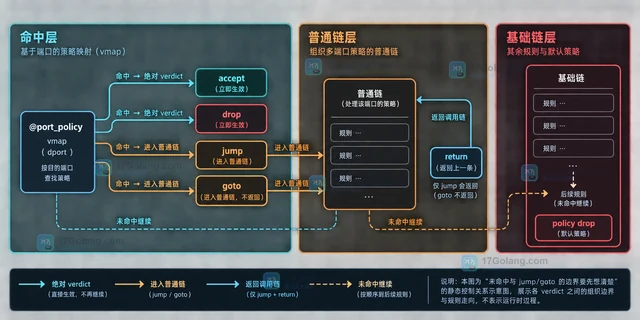
- 文章 · linux | 3天前 | Linux · Linux防火墙 nftables verdict map 多端口策略
- nftables verdict map 组织多端口策略的规则设计
- 475浏览 收藏
-
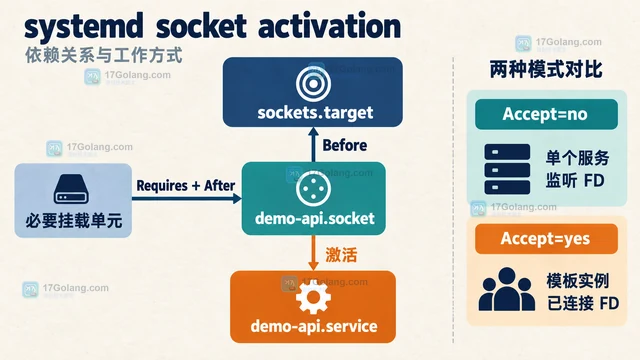
- 文章 · linux | 3天前 | 权限控制 · 服务管理 · systemd socket激活 systemd.socket ListenStream Accept
- systemd socket 激活服务的依赖与监听配置
- 229浏览 收藏
-
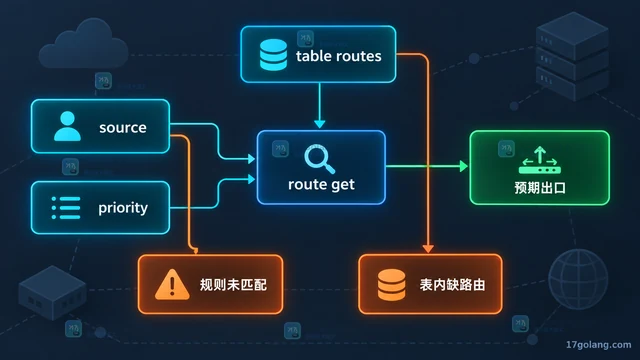
- 文章 · linux | 4天前 |
- Linux ip rule 怎么按来源地址选择路由表
- 347浏览 收藏
-
- 文章 · linux | 4天前 | Linux · 文件系统 · Linux mount bind mount remount
- Linux bind mount 怎么二次挂载为只读
- 116浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 291次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 344次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 347次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 310次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 131次使用
-
- Linux vmstat 如何分辨内存抖动与磁盘等待:si、so、wa 与复测顺序
- 2026-08-30 501浏览
-
- Linux搭建vsftpdFTP服务器教程
- 2026-04-30 501浏览
-
- Shell脚本安装教程:.sh一键安装指南
- 2026-03-16 501浏览
-
- Linux清空文件内容的几种方法
- 2025-12-01 501浏览
-
- Linux命令行下载文件技巧
- 2025-11-23 501浏览