
Go语言实现简易日志分析器教程
“纵有疾风来,人生不言弃”,这句话送给正在学习Golang的朋友们,也希望在阅读本文《Go语言实现简单日志分析器教程》后,能够真的帮助到大家。我也会在后续的文章中,陆续更新Golang相关的技术文章,有好的建议欢迎大家在评论留言,非常感谢!
使用Go语言实现简单日志分析器的核心在于读取日志文件、提取关键信息并进行统计分析。2. 处理大型日志文件时应避免一次性加载内存,可采用分块读取、bufio.Scanner、mmap或流式处理等策略。3. 提取日志信息可通过正则表达式实现,使用regexp.MustCompile编译表达式,并通过FindStringSubmatch提取子匹配内容。4. 日志分析结果可视化可通过图表库、Grafana、Elasticsearch+Kibana、Prometheus+Grafana或自定义Web界面实现。5. 性能优化包括并发处理、使用正则表达式池、减少内存分配、使用strings.Builder、避免类型转换、pprof性能分析及选择合适算法和数据结构。

Go语言实现简单日志分析器,核心在于读取日志文件,利用正则表达式或字符串匹配提取关键信息,并进行统计或展示。这需要一定的Go语言基础,以及对日志格式的理解。

解决方案:

- 读取日志文件: 使用
os.Open打开日志文件,然后通过bufio.NewReader逐行读取。这是基础,也是性能的关键。如果日志文件巨大,考虑使用io.Reader接口进行分块读取,避免一次性加载到内存。
package main

import (
    "bufio"
    "fmt"
    "os"
    "regexp"
)

func main() {
    file, err := os.Open("example.log")
    if err != nil {
        fmt.Println("Error opening file:", err)
        return
    }
    defer file.Close()

    reader := bufio.NewReader(file)
    for {
        line, err := reader.ReadString('\n')
        if err != nil {
            break // 结束读取
        }
        // 处理每一行日志
        processLogLine(line)
    }
}

func processLogLine(line string) {
    // 这里进行日志行的处理,例如提取信息
    fmt.Println(line)
}
定义日志格式: 了解你的日志格式至关重要。常见的日志格式包括时间戳、日志级别、模块名、消息内容等。你需要根据实际情况定义正则表达式或字符串匹配规则。例如,如果你的日志格式是
[2023-10-27 10:00:00] INFO: ...,那么你需要一个正则表达式来提取时间戳和日志级别。提取关键信息: 使用正则表达式或字符串匹配提取关键信息。Go语言的
regexp包提供了强大的正则表达式支持。例如,你可以使用regexp.Compile编译正则表达式,然后使用FindStringSubmatch提取匹配的子字符串。
// 在processLogLine函数中加入正则表达式提取
func processLogLine(line string) {
    re := regexp.MustCompile(`\[(.*?)\]\s(.*?):\s(.*)`) // 提取时间戳、日志级别和消息
    match := re.FindStringSubmatch(line)
    if len(match) > 0 {
        timestamp := match[1]
        logLevel := match[2]
        message := match[3]

        fmt.Printf("Timestamp: %s, Level: %s, Message: %s\n", timestamp, logLevel, message)
    }
}
统计分析: 将提取的信息进行统计分析。例如,你可以统计不同日志级别的数量,或者统计特定模块的错误信息。可以使用
map来存储统计结果。输出结果: 将统计结果输出到控制台或文件中。可以使用
fmt.Println或log.Printf输出结果。错误处理: 在读取文件、编译正则表达式等过程中,可能会出现错误。需要进行适当的错误处理,例如使用
if err != nil判断是否出错,并使用log.Println记录错误信息。并发处理: 如果日志文件巨大,可以考虑使用并发处理来提高性能。可以使用
goroutine和channel来实现并发读取和处理日志。但要注意控制并发数量,避免过度消耗系统资源。
如何处理大型日志文件以避免内存溢出?
对于大型日志文件,避免一次性加载到内存是关键。可以采用以下策略:
- 分块读取: 使用
io.Reader接口的Read方法分块读取文件内容。每次读取固定大小的块,例如4KB或8KB。
package main

import (
    "fmt"
    "io"
    "os"
)

const bufferSize = 4096

func main() {
    file, err := os.Open("large.log")
    if err != nil {
        fmt.Println("Error opening file:", err)
        return
    }
    defer file.Close()

    buffer := make([]byte, bufferSize)
    for {
        bytesRead, err := file.Read(buffer)
        if err != nil {
            if err != io.EOF {
                fmt.Println("Error reading file:", err)
            }
            break
        }
        // 处理读取到的数据块
        processBuffer(buffer[:bytesRead])
    }
}

func processBuffer(buffer []byte) {
    // 在这里处理buffer中的数据,例如分割成行
    fmt.Println(string(buffer))
}- 使用
bufio.Scanner:bufio.Scanner可以逐行扫描文件,而无需将整个文件加载到内存中。这是处理文本文件的常用方法。
package main

import (
    "bufio"
    "fmt"
    "os"
)

func main() {
    file, err := os.Open("large.log")
    if err != nil {
        fmt.Println("Error opening file:", err)
        return
    }
    defer file.Close()

    scanner := bufio.NewScanner(file)
    for scanner.Scan() {
        line := scanner.Text()
        // 处理每一行
        processLine(line)
    }

    if err := scanner.Err(); err != nil {
        fmt.Println("Error scanning file:", err)
    }
}

func processLine(line string) {
    // 处理单行日志
    fmt.Println(line)
}
使用
mmap(内存映射):mmap可以将文件映射到内存中,但实际上并没有将整个文件加载到内存中。操作系统会根据需要将文件内容加载到内存中。这可以提高读取文件的效率。但需要注意,mmap可能会导致一些问题,例如文件被修改时可能会导致程序崩溃。流式处理: 采用流式处理的方式,例如使用管道(
pipe)将日志数据传递给分析器。这样可以避免将整个日志文件加载到内存中。并发处理: 将日志文件分割成多个小文件,然后使用并发处理来分析这些小文件。这可以提高分析速度,但需要注意控制并发数量,避免过度消耗系统资源。
如何使用正则表达式提取不同格式的日志信息?
正则表达式是提取日志信息的强大工具。以下是一些使用正则表达式提取不同格式日志信息的示例:
- 提取时间戳、日志级别和消息:
package main

import (
    "fmt"
    "regexp"
)

func main() {
    logLine := "[2023-10-27 10:00:00] INFO: This is a log message."
    re := regexp.MustCompile(`\[(.*?)\]\s(.*?):\s(.*)`)
    match := re.FindStringSubmatch(logLine)

    if len(match) > 0 {
        timestamp := match[1]
        logLevel := match[2]
        message := match[3]

        fmt.Printf("Timestamp: %s, Level: %s, Message: %s\n", timestamp, logLevel, message)
    }
}- 提取IP地址和请求路径:
package main

import (
    "fmt"
    "regexp"
)

func main() {
    logLine := "192.168.1.1 - - [27/Oct/2023:10:00:00 +0000] \"GET /index.html HTTP/1.1\" 200 1234"
    re := regexp.MustCompile(`(\d{1,3}\.\d{1,3}\.\d{1,3}\.\d{1,3}).*?"(GET|POST)\s(.*?)\sHTTP`)
    match := re.FindStringSubmatch(logLine)

    if len(match) > 0 {
        ipAddress := match[1]
        requestMethod := match[2]
        requestPath := match[3]

        fmt.Printf("IP Address: %s, Method: %s, Path: %s\n", ipAddress, requestMethod, requestPath)
    }
}- 提取错误代码和错误消息:
package main

import (
    "fmt"
    "regexp"
)

func main() {
    logLine := "ERROR: [Error Code: 500] Internal Server Error"
    re := regexp.MustCompile(`ERROR:\s\[Error Code:\s(\d+)\]\s(.*?)$`)
    match := re.FindStringSubmatch(logLine)

    if len(match) > 0 {
        errorCode := match[1]
        errorMessage := match[2]

        fmt.Printf("Error Code: %s, Message: %s\n", errorCode, errorMessage)
    }
}
关键点:
- 编译正则表达式: 使用
regexp.MustCompile编译正则表达式。MustCompile会在编译失败时panic,这可以帮助你在程序启动时发现问题。 - 使用
FindStringSubmatch:FindStringSubmatch返回一个字符串切片,其中第一个元素是整个匹配的字符串,后面的元素是匹配的子字符串。 - 注意转义特殊字符: 正则表达式中有很多特殊字符,例如
.、*、+、?、[]、()、{}、$、^。如果要在正则表达式中匹配这些字符,需要使用反斜杠\进行转义。
如何将日志分析结果可视化?
将日志分析结果可视化可以更直观地了解系统的运行状态。以下是一些将日志分析结果可视化的方法:
使用图表库: Go语言有很多图表库,例如
gonum/plot、go-echarts、chart等。可以使用这些图表库生成各种图表,例如折线图、柱状图、饼图等。使用Grafana: Grafana是一个流行的开源数据可视化工具。可以将日志分析结果存储到数据库中,然后使用Grafana连接到数据库,并创建各种仪表盘来展示数据。
使用Elasticsearch和Kibana: Elasticsearch是一个强大的搜索引擎,Kibana是一个数据可视化工具。可以将日志数据导入到Elasticsearch中,然后使用Kibana创建各种仪表盘来展示数据。这是ELK stack (Elasticsearch, Logstash, Kibana) 的一部分,非常适合大型日志分析。
使用Prometheus和Grafana: Prometheus是一个流行的开源监控系统。可以将日志分析结果作为指标暴露给Prometheus,然后使用Grafana连接到Prometheus,并创建各种仪表盘来展示数据。
自定义Web界面: 可以使用Go语言的Web框架(例如
net/http、gin、echo)创建一个自定义的Web界面,并将日志分析结果展示在Web界面上。
选择哪种方法取决于你的需求和技术栈。如果需要快速生成简单的图表,可以使用图表库。如果需要构建复杂的仪表盘,可以使用Grafana或Kibana。如果需要监控系统的运行状态,可以使用Prometheus和Grafana。
如何优化日志分析器的性能?
日志分析器的性能至关重要,尤其是在处理大型日志文件时。以下是一些优化日志分析器性能的方法:
并发处理: 使用
goroutine和channel来实现并发读取和处理日志。这可以充分利用多核CPU的优势,提高分析速度。但要注意控制并发数量,避免过度消耗系统资源。使用
bufio.Scanner:bufio.Scanner可以逐行扫描文件,而无需将整个文件加载到内存中。这可以减少内存消耗,提高分析速度。使用正则表达式池: 编译正则表达式是一个耗时的操作。可以使用正则表达式池来缓存编译好的正则表达式,避免重复编译。
package main

import (
    "fmt"
    "regexp"
    "sync"
)

var (
    rePool sync.Pool
)

func init() {
    rePool = sync.Pool{
        New: func() interface{} {
            re, err := regexp.Compile(`\[(.*?)\]\s(.*?):\s(.*)`)
            if err != nil {
                panic(err) // 处理编译错误
            }
            return re
        },
    }
}

func processLogLine(line string) {
    re := rePool.Get().(*regexp.Regexp)
    defer rePool.Put(re)

    match := re.FindStringSubmatch(line)
    if len(match) > 0 {
        timestamp := match[1]
        logLevel := match[2]
        message := match[3]

        fmt.Printf("Timestamp: %s, Level: %s, Message: %s\n", timestamp, logLevel, message)
    }
}

func main() {
    // 示例调用
    processLogLine("[2023-10-27 10:00:00] INFO: This is a log message.")
}
使用
mmap(内存映射):mmap可以将文件映射到内存中,但实际上并没有将整个文件加载到内存中。操作系统会根据需要将文件内容加载到内存中。这可以提高读取文件的效率。减少内存分配: 频繁的内存分配会导致性能下降。可以尽量重用内存,例如使用
sync.Pool来缓存对象。使用
strings.Builder: 在拼接字符串时,使用strings.Builder可以避免频繁的内存分配。避免不必要的类型转换: 类型转换是一个耗时的操作。可以尽量避免不必要的类型转换。
使用
pprof进行性能分析: Go语言的pprof工具可以帮助你分析程序的性能瓶颈。可以使用pprof来找出性能瓶颈,并进行优化。选择合适的算法和数据结构: 选择合适的算法和数据结构可以提高程序的效率。例如,如果需要频繁查找字符串,可以使用
map或set。预处理日志文件: 如果日志文件很大,可以先对日志文件进行预处理,例如过滤掉不需要的日志行,或者将日志文件分割成多个小文件。
记住,性能优化是一个迭代的过程。需要不断地测试和分析,才能找到最佳的优化方案。
以上就是本文的全部内容了,是否有顺利帮助你解决问题?若是能给你带来学习上的帮助,请大家多多支持golang学习网!更多关于Golang的相关知识,也可关注golang学习网公众号。
 Win7黑屏怎么恢复设置
- 上一篇
- Win7黑屏怎么恢复设置

- 下一篇
- 豆包AI生成合同技巧详解
-
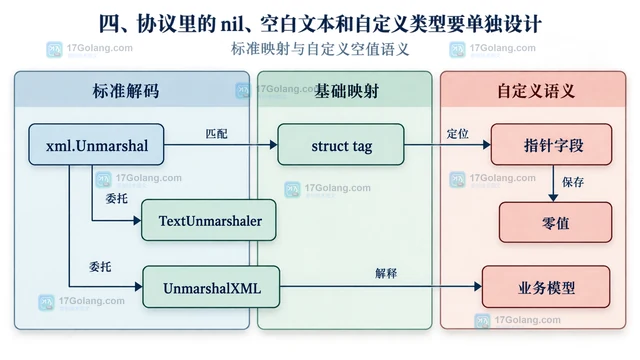
- Golang · Go教程 | 2天前 | Go教程 · Go encoding/xml 空元素 指针字段
- Go encoding/xml 空元素与指针字段的处理方式
- 142浏览 收藏
-
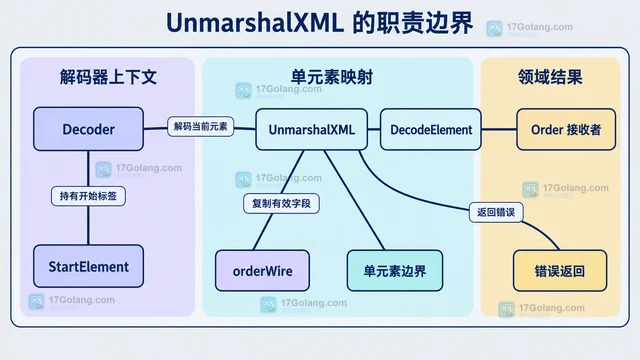
- Golang · Go教程 | 2天前 | Go教程 · Go encoding/xml 字段映射 Unmarshaler
- Go encoding/xml 自定义 Unmarshaler 的字段映射
- 189浏览 收藏
-
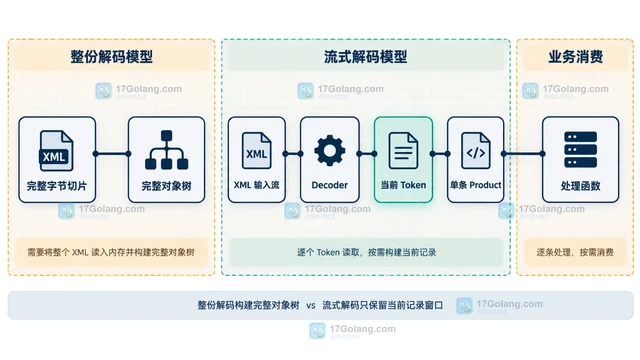
- Golang · Go教程 | 2天前 |
- Go encoding/xml Token 流式读取大型 XML
- 424浏览 收藏
-
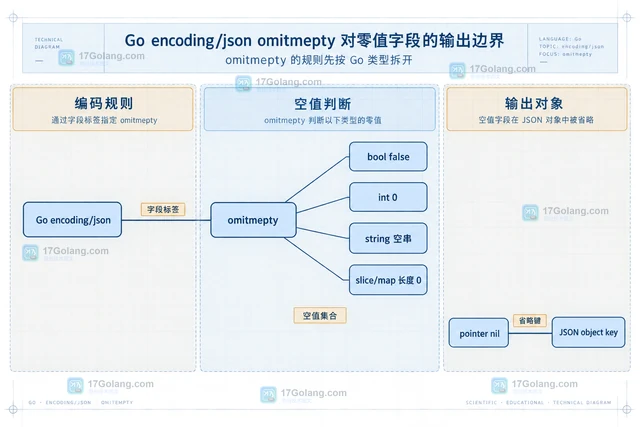
- Golang · Go教程 | 2天前 | go · encoding/json · JSON Go encoding/json omitempty
- Go encoding/json omitempty 对零值字段的输出边界
- 192浏览 收藏
-
- Golang · Go教程 | 2天前 |
- Go encoding/json Decoder Token 流式读取嵌套结构
- 364浏览 收藏
-
- Golang · Go教程 | 2天前 |
- Go encoding/json Decoder UseNumber 保留大整数精度
- 328浏览 收藏
-
- Golang · Go教程 | 2天前 |
- Go fmt.Scanner 自定义扫描规则的实现要点
- 182浏览 收藏
-
- Golang · Go教程 | 2天前 |
- Go fmt.Appendf 追加格式化结果的低分配写法
- 478浏览 收藏
-
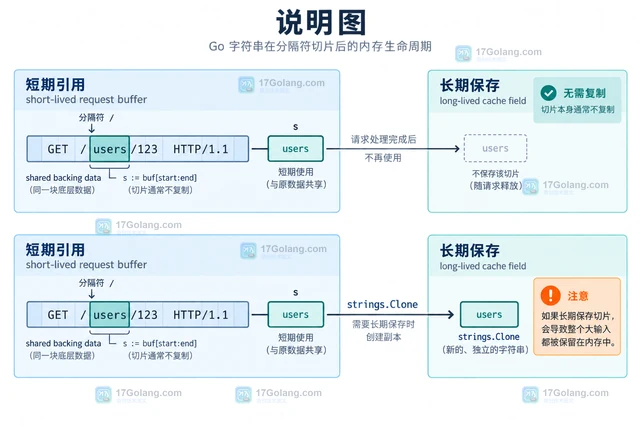
- Golang · Go教程 | 2天前 |
- Go strings.IndexByte 定位协议分隔符的低分配写法
- 413浏览 收藏
-
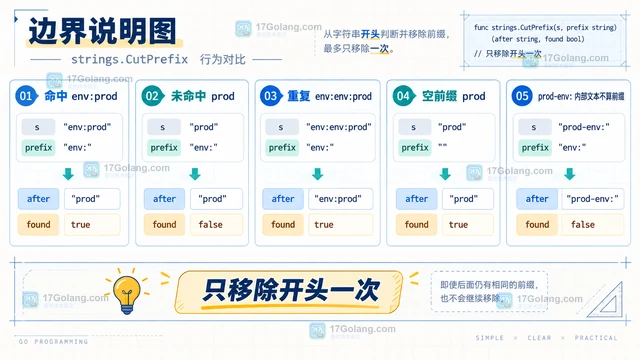
- Golang · Go教程 | 2天前 | go · Strings · Go 字符串前缀 strings.CutPrefix
- Go strings.CutPrefix 处理可选前缀的分支设计
- 165浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 287次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 340次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 341次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 306次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 129次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览