
解析Mysql索引设计原则(附测试过程)
对于一个数据库开发者来说,牢固扎实的基础是十分重要的,golang学习网就来带大家一点点的掌握基础知识点。今天本篇文章带大家了解《解析Mysql索引设计原则(附测试过程)》,主要介绍了MySQL、索引、测试、高频查询,希望对大家的知识积累有所帮助,快点收藏起来吧,否则需要时就找不到了!
推荐书籍:http://pan.baidu.com/s/1sjJIyRV
任务描述:
假设一高频查询如下
SELECT * FROM user WHERE area='amoy' AND sex=0 ORDER BY last_login DESC limit 30;
如何建立索引?描述考虑的过程
user表如下:
初始化100W条数据,其中,area要通过IP查询生成,sex为 0,1 随机
CREATE TABLE
user(
idint(10) NOT NULL AUTO_INCREMENT COMMENT '自增编号',
usernamevarchar(30) NOT NULL DEFAULT '0' COMMENT '用户名',
passwordvarchar(30) NOT NULL DEFAULT '0' COMMENT '密码',
areavarchar(30) NOT NULL COMMENT '地址',
sexint(10) NOT NULL COMMENT '性别1,男;2,女。',
last_loginint(10) NOT NULL COMMENT '最近一次登录时间戳',
PRIMARY KEY (
id)
) ENGINE=InnoDB AUTO_INCREMENT=892013 DEFAULT CHARSET=latin1
最终我的索引
(last_login,area)
索引原则:
1.where和order by等的字段建立索引
2.使用唯一索引:对于last_login,area等字段重复的次数比较少,可以使用索引;而sex无非就两个值:性别1,男;2,不值得索引
3.多列索引:不要为每一个列单独建立索引,这样并不能将mysql索引的效率最大化。使用“索引合并策略”
4.选择合理的索引列顺序:索引列的顺序意味着索引首先按照最左列进行排序,然后是第二列,以此类推。如(last_login,area)会先按照 last_login 进行排序,然后才是area。
5.将选择性最高的索引放到前面,也就是会所按照这个条件搜索到的数据最少,选择性就越高,比如选择性:last_login> area> sex。
6.索引不是越多越好,适合的索引可以提高查询效率,但是会降低写入效率,根据项目保持两者的平衡性最好了。
总结上面,首先sex不适合建立索引,有没有索引对于效率的提升意义不大,其次索引会按照最左列进行排序,因此将last_login放到最前面
测试过程:
user表
没有任何索引的查询相关日志:
SELECT * FROM user WHERE area='美国ATT用户' AND sex=0 ORDER BY last_login DESC limit 30; 0.57s
SELECT * FROM user WHERE area='泰国' AND sex=0 ORDER BY last_login DESC limit 30; 0.56s
SELECT * FROM user WHERE area='台湾省台湾大宽频' AND sex=0 ORDER BY last_login DESC limit 30; 0.55s
SELECT * FROM user WHERE area='美国弗吉尼亚州' AND sex=0 ORDER BY last_login DESC limit 30; 0.59s
SELECT * FROM user WHERE area='德国奔驰汽车' AND sex=0 ORDER BY last_login DESC limit 30; 0.55s
SELECT * FROM user WHERE area='台湾省中华电信' AND sex=0 ORDER BY last_login DESC limit 30; 0.55s
SELECT * FROM user WHERE area='韩国' AND sex=0 ORDER BY last_login DESC limit 30; 0.57s
SELECT * FROM user WHERE area='拉美地区' AND sex=0 ORDER BY last_login DESC limit 30; 0.58s
SELECT * FROM user WHERE area='美国纽约(Prudential)' AND sex=0 ORDER BY last_login DESC limit 30; 0.57s
SELECT * FROM user WHERE area='印度尼西亚' AND sex=0 ORDER BY last_login DESC limit 30; 0.57s
共花费时间:5.66s
建立索引area:
ALTER TABLE
userADD INDEX
index_area(
area) ;
SELECT * FROM user WHERE area='美国ATT用户' AND sex=0 ORDER BY last_login DESC limit 30; 0.06s
SELECT * FROM user WHERE area='泰国' AND sex=0 ORDER BY last_login DESC limit 30; 0.02s
SELECT * FROM user WHERE area='台湾省台湾大宽频' AND sex=0 ORDER BY last_login DESC limit 30; 0.00s
SELECT * FROM user WHERE area='美国弗吉尼亚州' AND sex=0 ORDER BY last_login DESC limit 30; 0.10s
SELECT * FROM user WHERE area='德国奔驰汽车' AND sex=0 ORDER BY last_login DESC limit 30; 0.04s
SELECT * FROM user WHERE area='台湾省中华电信' AND sex=0 ORDER BY last_login DESC limit 30; 0.02s
SELECT * FROM user WHERE area='韩国' AND sex=0 ORDER BY last_login DESC limit 30; 0.11s
SELECT * FROM user WHERE area='拉美地区' AND sex=0 ORDER BY last_login DESC limit 30; 0.20s
SELECT * FROM user WHERE area='美国纽约(Prudential)' AND sex=0 ORDER BY last_login DESC limit 30; 0.07s
SELECT * FROM user WHERE area='印度尼西亚' AND sex=0 ORDER BY last_login DESC limit 30; 0.04s
共花费时间:0.66s
可见,建立area以后对性能的影响是巨大的(5.66/0.66 约为8.5758倍)
删除索引:ALTER TABLE
userDROP INDEX
index_area;
删除area索引发现时间又变成了0.57s
建立last_login索引:
SELECT * FROM user WHERE area='美国ATT用户' AND sex=0 ORDER BY last_login DESC limit 30; 0.03s
SELECT * FROM user WHERE area='泰国' AND sex=0 ORDER BY last_login DESC limit 30; 0.09s
SELECT * FROM user WHERE area='台湾省台湾大宽频' AND sex=0 ORDER BY last_login DESC limit 30; 0.51s
SELECT * FROM user WHERE area='美国弗吉尼亚州' AND sex=0 ORDER BY last_login DESC limit 30; 0.01s
SELECT * FROM user WHERE area='德国奔驰汽车' AND sex=0 ORDER BY last_login DESC limit 30; 0.04s
SELECT * FROM user WHERE area='台湾省中华电信' AND sex=0 ORDER BY last_login DESC limit 30; 0.07s
SELECT * FROM user WHERE area='韩国' AND sex=0 ORDER BY last_login DESC limit 30; 0.01s
SELECT * FROM user WHERE area='拉美地区' AND sex=0 ORDER BY last_login DESC limit 30; 0.01s
SELECT * FROM user WHERE area='美国纽约(Prudential)' AND sex=0 ORDER BY last_login DESC limit 30; 0.04s
SELECT * FROM user WHERE area='印度尼西亚' AND sex=0 ORDER BY last_login DESC limit 30; 0.06s
共花费时间:0.87s
同样能够提升性能(5.66/0.87 约为6.5057倍)
建立sex索引:
ALTER TABLE
userADD INDEX
index_sex(
sex) ;
SELECT * FROM user WHERE area='美国ATT用户' AND sex=0 ORDER BY last_login DESC limit 30; 0.87s
SELECT * FROM user WHERE area='泰国' AND sex=0 ORDER BY last_login DESC limit 30; 0.87s
SELECT * FROM user WHERE area='台湾省台湾大宽频' AND sex=0 ORDER BY last_login DESC limit 30; 0.87s
SELECT * FROM user WHERE area='美国弗吉尼亚州' AND sex=0 ORDER BY last_login DESC limit 30; 0.89s
SELECT * FROM user WHERE area='德国奔驰汽车' AND sex=0 ORDER BY last_login DESC limit 30; 0.88s
SELECT * FROM user WHERE area='台湾省中华电信' AND sex=0 ORDER BY last_login DESC limit 30; 0.87s
SELECT * FROM user WHERE area='韩国' AND sex=0 ORDER BY last_login DESC limit 30; 0.86s
SELECT * FROM user WHERE area='拉美地区' AND sex=0 ORDER BY last_login DESC limit 30; 0.88s
SELECT * FROM user WHERE area='美国纽约(Prudential)' AND sex=0 ORDER BY last_login DESC limit 30; 0.87s
SELECT * FROM user WHERE area='印度尼西亚' AND sex=0 ORDER BY last_login DESC limit 30; 0.87s
共花费时间:8.73s
同样能够提升性能(5.66s/8.73 约为0.6483倍)效率反而降低了??求解?
建立这个sex索引还不如不建。
删除索引:
ALTER TABLE
userDROP INDEX
index_sex;
发现时间又变成了0.57s左右,
建立两个单独的索引:
ALTER TABLE
user
ADD INDEX
index_area(
area) ,
ADD INDEX
index_last_login(
last_login) ;
SELECT * FROM user WHERE area='美国ATT用户' AND sex=0 ORDER BY last_login DESC limit 30; 0.09s
SELECT * FROM user WHERE area='泰国' AND sex=0 ORDER BY last_login DESC limit 30; 0.33s
SELECT * FROM user WHERE area='台湾省台湾大宽频' AND sex=0 ORDER BY last_login DESC limit 30; 0.21s
SELECT * FROM user WHERE area='美国弗吉尼亚州' AND sex=0 ORDER BY last_login DESC limit 30; 0.01s
SELECT * FROM user WHERE area='德国奔驰汽车' AND sex=0 ORDER BY last_login DESC limit 30; 0.28s
SELECT * FROM user WHERE area='台湾省中华电信' AND sex=0 ORDER BY last_login DESC limit 30; 0.02s
SELECT * FROM user WHERE area='韩国' AND sex=0 ORDER BY last_login DESC limit 30; 0.02s
SELECT * FROM user WHERE area='拉美地区' AND sex=0 ORDER BY last_login DESC limit 30; 0.02s
SELECT * FROM user WHERE area='美国纽约(Prudential)' AND sex=0 ORDER BY last_login DESC limit 30; 0.03s
SELECT * FROM user WHERE area='印度尼西亚' AND sex=0 ORDER BY last_login DESC limit 30; 0.67s
发现建立两个单独的索引还不如只建立一个索引
删除索引:
发现时间又变成了0.57s左右,
建立一个的联合索引:
ALTER TABLE
user
ADD INDEX
index_last_login_area(
last_login,
area) ,
SELECT * FROM user WHERE area='美国ATT用户' AND sex=0 ORDER BY last_login DESC limit 30; 0.00s
SELECT * FROM user WHERE area='泰国' AND sex=0 ORDER BY last_login DESC limit 30; 0.00s
SELECT * FROM user WHERE area='台湾省台湾大宽频' AND sex=0 ORDER BY last_login DESC limit 30; 0.00s
SELECT * FROM user WHERE area='美国弗吉尼亚州' AND sex=0 ORDER BY last_login DESC limit 30; 0.00s
SELECT * FROM user WHERE area='德国奔驰汽车' AND sex=0 ORDER BY last_login DESC limit 30; 0.00s
SELECT * FROM user WHERE area='台湾省中华电信' AND sex=0 ORDER BY last_login DESC limit 30; 0.00s
SELECT * FROM user WHERE area='韩国' AND sex=0 ORDER BY last_login DESC limit 30; 0.00s
SELECT * FROM user WHERE area='拉美地区' AND sex=0 ORDER BY last_login DESC limit 30; 0.00s
SELECT * FROM user WHERE area='美国纽约(Prudential)' AND sex=0 ORDER BY last_login DESC limit 30; 0.00s
SELECT * FROM user WHERE area='印度尼西亚' AND sex=0 ORDER BY last_login DESC limit 30; 0.00s
额,第二条数据这是怎么了,我测试了5次都在这附近晃悠哈!
这尼玛,找对索引啦!就该这么建立,查询不出来需要的时间啦!估计就是我们需要的索引啦!!!!
删除索引:
发现时间又变成了0.57s左右,
建立一个的联合索引:
ALTER TABLE
user
ADD INDEX
index_sex_last_login_area(
sex,
last_login,
area)
SELECT * FROM user WHERE area='美国ATT用户' AND sex=0 ORDER BY last_login DESC limit 30; 0.18s
SELECT * FROM user WHERE area='泰国' AND sex=0 ORDER BY last_login DESC limit 30; 0.17s
SELECT * FROM user WHERE area='台湾省台湾大宽频' AND sex=0 ORDER BY last_login DESC limit 30; 0.81s
SELECT * FROM user WHERE area='美国弗吉尼亚州' AND sex=0 ORDER BY last_login DESC limit 30; 0.01s
SELECT * FROM user WHERE area='德国奔驰汽车' AND sex=0 ORDER BY last_login DESC limit 30; 0.02s
SELECT * FROM user WHERE area='台湾省中华电信' AND sex=0 ORDER BY last_login DESC limit 30; 0.04s
SELECT * FROM user WHERE area='韩国' AND sex=0 ORDER BY last_login DESC limit 30; 0.01s
SELECT * FROM user WHERE area='拉美地区' AND sex=0 ORDER BY last_login DESC limit 30; 0.01s
SELECT * FROM user WHERE area='美国纽约(Prudential)' AND sex=0 ORDER BY last_login DESC limit 30; 0.03s
SELECT * FROM user WHERE area='印度尼西亚' AND sex=0 ORDER BY last_login DESC limit 30; 0.04s
sex怎么总是你在拖后腿啊!把你调整到索引的最后一个吧!
删除索引:
发现时间又变成了0.57s左右,
建立一个的联合索引:
ALTER TABLE
user
ADD INDEX
index_last_login_area_sex(
area,
last_login,
sex)
SELECT * FROM user WHERE area='美国ATT用户' AND sex=0 ORDER BY last_login DESC limit 30; 0.03s
SELECT * FROM user WHERE area='泰国' AND sex=0 ORDER BY last_login DESC limit 30; 0.07s
SELECT * FROM user WHERE area='台湾省台湾大宽频' AND sex=0 ORDER BY last_login DESC limit 30; 0.50s
SELECT * FROM user WHERE area='美国弗吉尼亚州' AND sex=0 ORDER BY last_login DESC limit 30; 0.02s
SELECT * FROM user WHERE area='德国奔驰汽车' AND sex=0 ORDER BY last_login DESC limit 30; 0.05s
SELECT * FROM user WHERE area='台湾省中华电信' AND sex=0 ORDER BY last_login DESC limit 30; 0.06s
SELECT * FROM user WHERE area='韩国' AND sex=0 ORDER BY last_login DESC limit 30; 0.02s
SELECT * FROM user WHERE area='拉美地区' AND sex=0 ORDER BY last_login DESC limit 30; 0.02s
SELECT * FROM user WHERE area='美国纽约(Prudential)' AND sex=0 ORDER BY last_login DESC limit 30; 0.04s
SELECT * FROM user WHERE area='印度尼西亚' AND sex=0 ORDER BY last_login DESC limit 30; 0.06s
综上所述:1.建立索引不一定能够加快查询效率如sex这种给重复次数特别多的列增加索引如sex这种会降低查询效率,具体的原因有待查找
2.给重复次数比较少的列增加u讴吟还是能够大幅度提高效率
3.给where和orderby之后的字段添加索引才会加快查询效率
4.为每一个列单独建立索引,不能将索引的效率最大化,应该使用索引合并策略,即根据查询条件,建立联合索引
5.联合索引的顺序问题:将选择性高的索引放到前面
6.根据资料建立索引意味着索引按照最左列进行排序,然后事第二列,以此类推。如(last_login ,area)就会按照last_login进行排序,然后才是area
7.根据这次的这个查询条件来说最好的索引是:ALTER TABLE
userADD INDEX
index_last_login_area(
last_login,
area)。
以上就是本文的全部内容了,是否有顺利帮助你解决问题?若是能给你带来学习上的帮助,请大家多多支持golang学习网!更多关于数据库的相关知识,也可关注golang学习网公众号。
 教你怎么快速搭建nginx+php+mysql环境
- 上一篇
- 教你怎么快速搭建nginx+php+mysql环境
- 下一篇
- 浅析mysql外键是什么?有什么作用?
-
- 会撒娇的香菇
- 这篇文章内容真是及时雨啊,很详细,写的不错,码起来,关注up主了!希望up主能多写数据库相关的文章。
- 2023-01-14 23:47:23
-
- 数据库 · MySQL | 5小时前 |
- MySQL histogram 怎样用直方图解释选择性估算
- 122浏览 收藏
-
- 数据库 · MySQL | 5小时前 | MySQL · 正则表达式 · mysql regexp_replace 正则替换 pos occurrence match_type
- MySQL REGEXP_REPLACE 怎样只替换指定次数的文本
- 426浏览 收藏
-
- 数据库 · MySQL | 5小时前 |
- MySQL JSON_TABLE 结合 JSON_KEYS 读取动态对象键名
- 368浏览 收藏
-
- 数据库 · MySQL | 5小时前 |
- MySQL multi-valued index 怎样为 JSON 数组建立多值索引
- 139浏览 收藏
-
- 数据库 · MySQL | 6小时前 |
- MySQL named window 怎样复用多个查询的窗口定义
- 226浏览 收藏
-
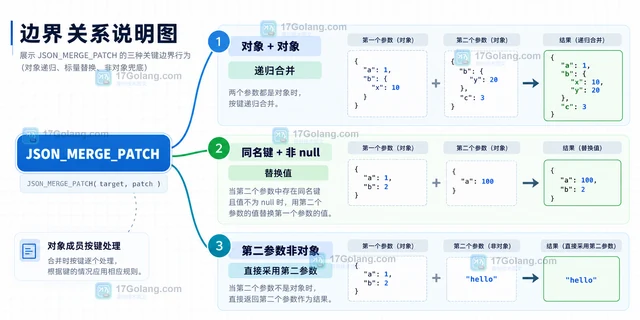
- 数据库 · MySQL | 6小时前 | MySQL · JSON · 数据库运维 · mysql JSON_MERGE_PATCH JSON null JSON_REMOVE JSON合并
- MySQL JSON_MERGE_PATCH 怎样让 JSON null 删除对象成员
- 287浏览 收藏
-
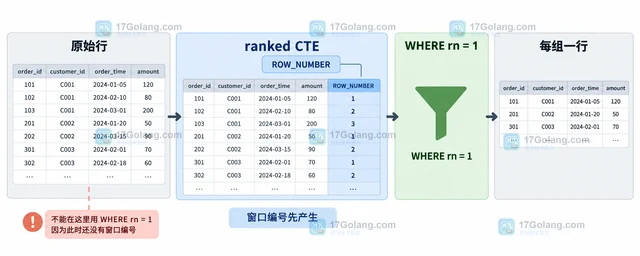
- 数据库 · MySQL | 6小时前 | MySQL · 窗口函数 ROW_NUMBER PARTITION BY 每组最新记录 MySQL window function
- MySQL window function 怎样用 ROW_NUMBER 取每组最新记录
- 123浏览 收藏
-
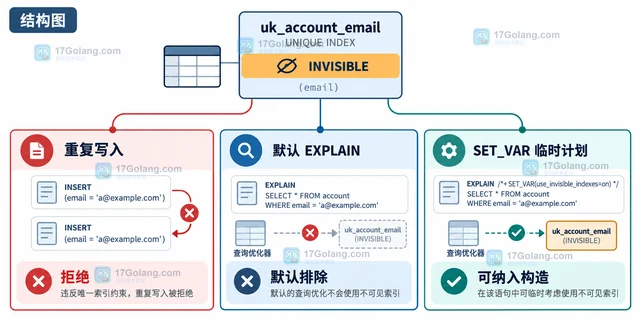
- 数据库 · MySQL | 6小时前 |
- MySQL invisible index 唯一索引设为不可见后约束还生效吗
- 335浏览 收藏
-
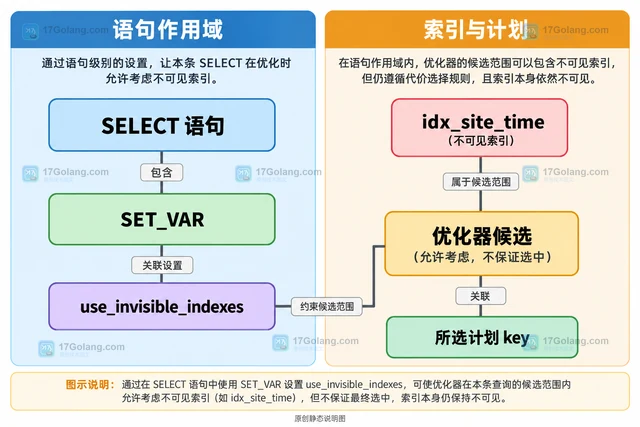
- 数据库 · MySQL | 6小时前 |
- MySQL invisible index 怎样临时让优化器使用不可见索引
- 345浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 669次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 686次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 733次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 701次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 536次使用
-
- MySQL 明明加了索引,为什么查询还是很慢?先查这 6 个点
- 2026-06-27 374浏览
-
- golang MySQL实现对数据库表存储获取操作示例
- 2022-12-22 499浏览
-
- golang 基于 mysql 简单实现分布式读写锁
- 2023-01-07 384浏览
-
- golang cache带索引超时缓存库实战示例
- 2022-12-31 234浏览
-
- 详解如何利用GORM实现MySQL事务
- 2023-01-07 184浏览


