
python爬虫之连接mysql
来源:SegmentFault
2023-01-14 15:53:50
0浏览
收藏
本篇文章主要是结合我之前面试的各种经历和实战开发中遇到的问题解决经验整理的,希望这篇《python爬虫之连接mysql》对你有很大帮助!欢迎收藏,分享给更多的需要的朋友学习~
准备工作
- 运行本地数据库服务器
mysql -u root -p
- 安装pymysql
pip install pymysql
建表
CREATE DATABASE crawls;
// show databases;
use db;

CREATE TABLE IF NOT EXISTS baiduNews('
       'id INT PRIMARY KEY NOT NULL AUTO_INCREMENT,'
       'ranking VARCHAR(30),'
       'title VARCHAR(60),'
       'datetime TIMESTAMP,'
       'hot VARCHAR(30));
// show tables;
pymysql连接数据库
db = pymysql.connect(host='localhost', port=3306, user='root', passwd='123456',
                    db='crawls', charset='utf8')
cursor = db.cursor()
cursor.execute(sql_query)
db.commit()
用python操作mysql还是比较简单的,如果有一点数据库基础的话,可以直接上手,最后一定不要忘了写commit提交,不然数据只是缓存,存不到数据库里
完整示例
爬取百度上最热的几个新闻标题,并存储到数据库,太懒了没写注释-_- (确保本地mysql服务器已经打开)
'''
Get the hottest news title on baidu page,
then save these data into mysql
'''
import datetime

import pymysql
from pyquery import PyQuery as pq
import requests
from requests.exceptions import ConnectionError

URL = 'https://wappass.baidu.com/static/captcha/tuxing.html?&logid=11151228204422475442&ak=c27bbc89afca0463650ac9bde68ebe06&backurl=https%3A%2F%2Fwww.baidu.com%2Fs%3Fwd%3D%25E7%2583%25AD%25E7%2582%25B9&ext=x9G9QDmMXq%2FNo87gjGO0P4duDYWmTLah%2FsWlJ%2B%2Fs0zRWkhrGqVqihBVl6ZY8QtPHeUkK%2FLSi82sM2wFm%2BXofRA8QipFbArBY11xRs2OUQOCyuRtUIETqejFhi48WwtWcZaw2FQi2OfC72W%2FW5HwRPw%3D%3D&signature=86adae7de4d91d6adc7c4689b7348af3×tamp=1673119049'
headers = {
    'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.77 Safari/537.36',
    'Upgrade-Insecure-Requests': '1'
}

def get_html(url):
    try:
        response = requests.get(url, headers=headers)
        if response.status_code == 200:
            return response.text
        return None
    except ConnectionError as e:
        print(e.args)
        return None

def parse_html(html):
    doc = pq(html)
    trs = doc('.FYB_RD table.c-table tr').items()
    for tr in trs:
        index = tr('td:nth-child(1) span.c-index').text()
        title = tr('td:nth-child(1) span a').text()
        hot = tr('td:nth-child(2)').text().strip('"')
        yield {
            'index':index,
            'title':title,
            'hot':hot
        }

def save_to_mysql(items):
    try:
        db = pymysql.connect(host='localhost', port=3306, user='root', passwd='123456',
                             db='crawls', charset='utf8')
        cursor = db.cursor()
        cursor.execute('use crawls;')
        cursor.execute('CREATE TABLE IF NOT EXISTS baiduNews('
                       'id INT PRIMARY KEY NOT NULL AUTO_INCREMENT,'
                       'ranking VARCHAR(30),'
                       'title VARCHAR(60),'
                       'datetime TIMESTAMP,'
                       'hot VARCHAR(30));')
        try:
            for item in items:
                print(item)
                now = datetime.datetime.now()
                now = now.strftime('%Y-%m-%d %H:%M:%S')
                sql_query = 'INSERT INTO baiduNews(ranking, title, datetime, hot) VALUES ("%s", "%s", "%s", "%s")' % (
                            item['index'], item['title'], now, item['hot'])
                cursor.execute(sql_query)
                print('Save into mysql')
            db.commit()
        except pymysql.MySQLError as e:
            db.rollback()
            print(e.args)
            return
    except pymysql.MySQLError as e:
        print(e.args)
        return

def check_mysql():
    try:
        db = pymysql.connect(host='localhost', port=3306, user='root', passwd='123456',
                             db='crawls', charset='utf8')
        cursor = db.cursor()
        cursor.execute('use crawls;')
        sql_query = 'SELECT * FROM baiduNews'
        results = cursor.execute(sql_query)
        print(results)
    except pymysql.MySQLError as e:
        print(e.args)

def main():
    html = get_html(URL)
    items = parse_html(html)
    save_to_mysql(items)
    #check_mysql()

if __name__ == '__main__':
    main()
以上就是《python爬虫之连接mysql》的详细内容,更多关于mysql的资料请关注golang学习网公众号!
版本声明
本文转载于:SegmentFault 如有侵犯,请联系study_golang@163.com删除
 使用MySQL的geometry类型处理经纬度距离问题
- 上一篇
- 使用MySQL的geometry类型处理经纬度距离问题
- 下一篇
- Mysql的基本语句操作
评论列表
-
- 清脆的柠檬
- 这篇技术文章真是及时雨啊,很详细,赞 ??,mark,关注大佬了!希望大佬能多写数据库相关的文章。
- 2023-04-16 23:50:51
查看更多
最新文章
-
- 数据库 · MySQL | 3小时前 |
- MySQL histogram 怎样用直方图解释选择性估算
- 122浏览 收藏
-
- 数据库 · MySQL | 3小时前 | MySQL · 正则表达式 · mysql regexp_replace 正则替换 pos occurrence match_type
- MySQL REGEXP_REPLACE 怎样只替换指定次数的文本
- 426浏览 收藏
-
- 数据库 · MySQL | 3小时前 |
- MySQL JSON_TABLE 结合 JSON_KEYS 读取动态对象键名
- 368浏览 收藏
-
- 数据库 · MySQL | 3小时前 |
- MySQL multi-valued index 怎样为 JSON 数组建立多值索引
- 139浏览 收藏
-
- 数据库 · MySQL | 3小时前 |
- MySQL named window 怎样复用多个查询的窗口定义
- 226浏览 收藏
-
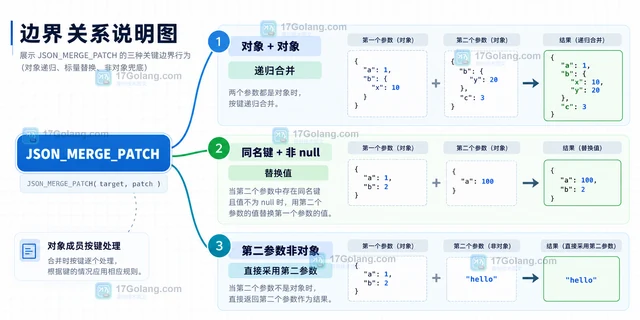
- 数据库 · MySQL | 4小时前 | MySQL · JSON · 数据库运维 · mysql JSON_MERGE_PATCH JSON null JSON_REMOVE JSON合并
- MySQL JSON_MERGE_PATCH 怎样让 JSON null 删除对象成员
- 287浏览 收藏
-
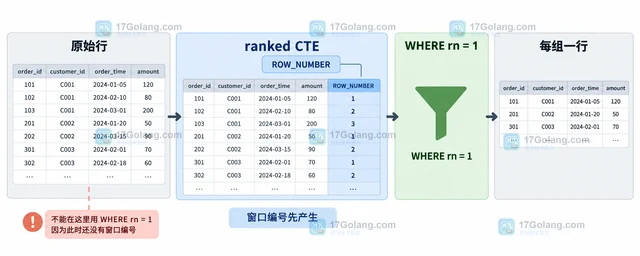
- 数据库 · MySQL | 4小时前 | MySQL · 窗口函数 ROW_NUMBER PARTITION BY 每组最新记录 MySQL window function
- MySQL window function 怎样用 ROW_NUMBER 取每组最新记录
- 123浏览 收藏
-
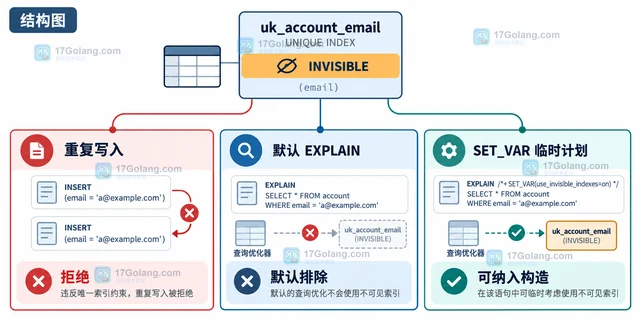
- 数据库 · MySQL | 4小时前 |
- MySQL invisible index 唯一索引设为不可见后约束还生效吗
- 335浏览 收藏
-
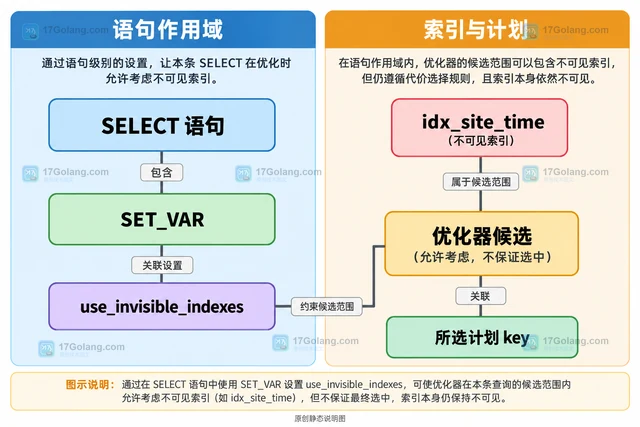
- 数据库 · MySQL | 4小时前 |
- MySQL invisible index 怎样临时让优化器使用不可见索引
- 345浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 665次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 683次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 727次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 697次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 529次使用
查看更多
相关文章
-
- MySQL 明明加了索引,为什么查询还是很慢?先查这 6 个点
- 2026-06-27 374浏览
-
- golang MySQL实现对数据库表存储获取操作示例
- 2022-12-22 499浏览
-
- golang 基于 mysql 简单实现分布式读写锁
- 2023-01-07 384浏览
-
- 详解如何利用GORM实现MySQL事务
- 2023-01-07 184浏览
-
- Go语言实现操作MySQL的基础知识总结
- 2023-01-23 265浏览


