
Netflix,但更好
“纵有疾风来,人生不言弃”,这句话送给正在学习文章的朋友们,也希望在阅读本文《Netflix,但更好》后,能够真的帮助到大家。我也会在后续的文章中,陆续更新文章相关的技术文章,有好的建议欢迎大家在评论留言,非常感谢!

免责声明:本项目与Netflix无关,仅为技术实验。
超越Netflix:构建更智能的电影推荐系统
Netflix作为流媒体巨头,拥有超过2亿用户和17000多部电影及电视节目,其推荐系统功不可没。该系统基于用户观看历史、相似节目、用户趋势和热门剧集等数据进行推荐。但如果我们能以更简便的方式复制这一功能呢?
本项目旨在构建一个简易的电影推荐系统,包含直接搜索、基于向量的推荐引擎以及AI内容推荐功能。
技术选型
本应用基于Next.js、Tailwind CSS和shadcn UI构建。项目灵感源于Tejas Kumar的DataStax电影推荐系统演讲,技术选型则借鉴了Lee Robinson的库存项目。为确保性能,我们使用Next.js的服务器端渲染(SSR)功能及图像组件进行图像预渲染和积极预取。数据存储采用Neon Cloud PostgreSQL数据库,Vercel AI SDK用于嵌入式搜索,并使用Prisma作为ORM。
数据准备
我们使用Kaggle上的开源数据集,包含8000多部电影和电视节目(CSV格式),直接导入数据库。OMDb API用于获取海报图像和IMDb评分。演示CSV文件使用cast作为列名,但在数据库中,我们使用_cast避免与数据库函数冲突。
COPY tmp_titles (show_id, title, description, director, genres, _cast, production_country, release_date, rating, duration)
FROM '/data/netflix_titles.csv'
DELIMITER ','
CSV HEADER;
为建立表间关系,我们创建了多个表,shows表作为主要数据来源:
CREATE TABLE "shows" (
    "id" SERIAL PRIMARY KEY NOT NULL,
    "title" TEXT NOT NULL,
    "poster" TEXT, -- 海报图片URL
    "description" TEXT, -- 简短描述
    "release_year" INTEGER, -- 发行年份
    "duration" TEXT, -- 时长
    "imdb_score" NUMERIC, -- IMDb评分
    "imdb_id" TEXT, -- IMDb ID
    "content_type" TEXT -- 类型 (电影或剧集)
);
接下来,创建actors表并建立与shows表的多对多关系:
CREATE TABLE "actors" (
    "id" SERIAL PRIMARY KEY NOT NULL,
    "name" TEXT NOT NULL,
    CONSTRAINT "actors_name_unique" UNIQUE("name")
);

CREATE TABLE "show_actors" (
    "show_id" INTEGER NOT NULL,
    "actor_id" INTEGER NOT NULL,
    CONSTRAINT "show_actors_show_id_actor_id_pk" PRIMARY KEY("show_id", "actor_id")
);
这使得我们可以关联节目和演员。通过递归,可以将演员链接到他们出演的节目。这通过匹配tmp_titles表中的节目和shows表,并解析_cast列来实现。
-- 将tmp_titles._cast中的演员插入actors表
WITH RECURSIVE split_cast AS (
    SELECT DISTINCT -- 去除空格并以逗号分割_cast字符串
        TRIM(UNNEST(STRING_TO_ARRAY(_cast, ','))) AS actor_name
    FROM tmp_titles
    WHERE _cast IS NOT NULL
)
INSERT INTO actors (name)
SELECT actor_name
FROM split_cast
WHERE actor_name != '' -- 跳过空字符串
ON CONFLICT (name) DO NOTHING;
类似过程应用于类别、导演和国家表。
全文搜索
为提升搜索功能,我们在shows表中添加search_text列,存储标题、描述、类型、演员、导演和类别的文本组合,方便全文搜索。我们使用PostgreSQL的pg_trgm扩展提高搜索效率。
-- 创建文本搜索扩展
CREATE EXTENSION IF NOT EXISTS pg_trgm;
-- 添加search_text列
ALTER TABLE "shows"
ADD COLUMN "search_text" TEXT;
-- 创建search_text列索引
CREATE INDEX "idx_shows_search_text_tsv" ON "shows" USING gin (to_tsvector('english', "search_text"));
迁移完成后,我们可以使用脚本填充search_text列:
// ... (代码片段,用于填充search_text列) ...
现在,我们可以使用search_text列执行全文搜索:
// ... (代码片段,用于执行全文搜索) ...
to_tsvector和to_tsquery函数用于匹配向量和查询。
基于AI嵌入的向量搜索
全文搜索功能强大,但不足以满足所有需求。我们需要支持语义搜索,用户可以根据给定标题或抽象标准查找相似节目。
Vercel AI SDK可以创建元数据的向量表示(嵌入),增强语义搜索。我们使用Mistral模型:
// ... (代码片段,使用Mistral模型生成嵌入) ...
我们定义Zod模式用于AI生成嵌入:
// ... (代码片段,定义Zod模式) ...
使用该模式,我们可以要求AI模型分析节目信息并生成元数据:
// ... (代码片段,生成元数据) ...
结果类似于《绝命毒师》的元数据:
// ... (《绝命毒师》的元数据JSON) ...
使用此元数据,我们在shows表中存储每个节目的嵌入,启用向量搜索。创建必要的扩展并添加新列:
-- 创建扩展
CREATE EXTENSION IF NOT EXISTS vector;
-- 添加embedding列
ALTER TABLE "shows"
ADD COLUMN "embedding" vector(1024);
-- 创建embedding列索引
CREATE INDEX "embeddingindex" ON "shows" USING ivfflat ("embedding" vector_cosine_ops);
然后,使用AI SDK生成并存储嵌入:
// ... (代码片段,生成并存储嵌入) ...
现在,我们可以查询最近邻:
// ... (代码片段,查询最近邻) ...
未来展望
您可以克隆项目仓库并在本地运行。实时演示链接(此处应插入链接)。您可以添加新功能,例如新的推荐类型或使用OpenAI或Gemini改进搜索。还可以扩展数据集,添加更多元数据。
总结
通过PostgreSQL、Next.js和AI驱动的嵌入,我们可以构建高效可扩展的推荐引擎。全文搜索和语义AI搜索相结合,提供更强大、个性化的体验。
参考链接
- pgvector
- pg_trgm
- Prisma
- Vercel AI SDK
- PostgreSQL中的向量搜索
- 向量与Prisma的相似性
终于介绍完啦!小伙伴们,这篇关于《Netflix,但更好》的介绍应该让你收获多多了吧!欢迎大家收藏或分享给更多需要学习的朋友吧~golang学习网公众号也会发布文章相关知识,快来关注吧!
 绿地集团官宣跨界新能源汽车行业,首个订单已签约
- 上一篇
- 绿地集团官宣跨界新能源汽车行业,首个订单已签约

- 下一篇
- 第二批长城灵魂摩托官宣14分钟售罄 售价21.88万起
-
- 文章 · 前端 | 1小时前 |
- Vite 环境 API 如何为多运行时组织构建配置
- 418浏览 收藏
-
- 文章 · 前端 | 3小时前 |
- Web Locks API 的等待请求如何支持用户主动取消
- 239浏览 收藏
-
- 文章 · 前端 | 8小时前 | javascript · AbortController AbortSignal.any AbortError TimeoutError AbortSignal reason
- AbortSignal.any 触发后怎样判断来自超时还是手动取消
- 447浏览 收藏
-
- 文章 · 前端 | 10小时前 |
- JavaScript Iterator Helpers 怎样组合惰性数据处理
- 110浏览 收藏
-
- 文章 · 前端 | 12小时前 | css ·
- CSS 容器样式查询如何根据父级状态改组件
- 120浏览 收藏
-
- 文章 · 前端 | 15小时前 | prefetch 前端性能 Speculation Rules API prerender
- Speculation Rules API 如何安全预渲染下一页
- 202浏览 收藏
-
- 文章 · 前端 | 17小时前 | javascript · 前端性能 长任务 INP优化 交互延迟 web-vitals Long Animation Frames
- INP 偏高时如何定位长任务与交互延迟
- 257浏览 收藏
-
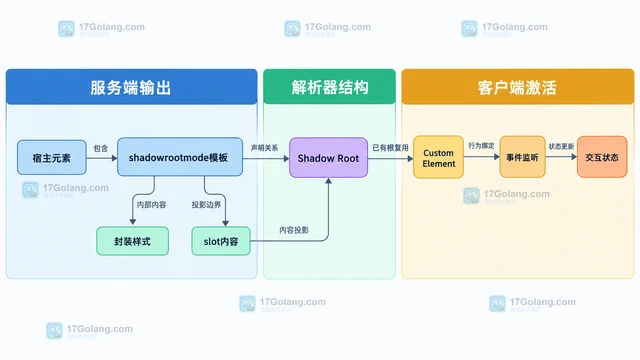
- 文章 · 前端 | 19小时前 | 前端 · Web Components 服务端渲染 shadowrootmode 声明式 Shadow DOM Custom Elements hydration
- Web Components 声明式 Shadow DOM 如何用于服务端渲染
- 315浏览 收藏
-
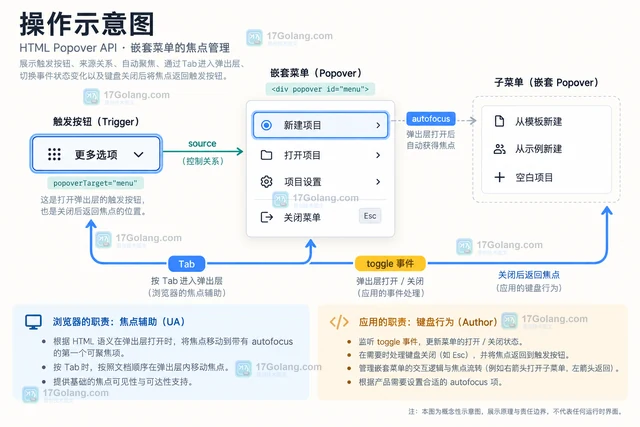
- 文章 · 前端 | 21小时前 |
- HTML Popover API 怎样处理嵌套弹层与焦点
- 356浏览 收藏
-
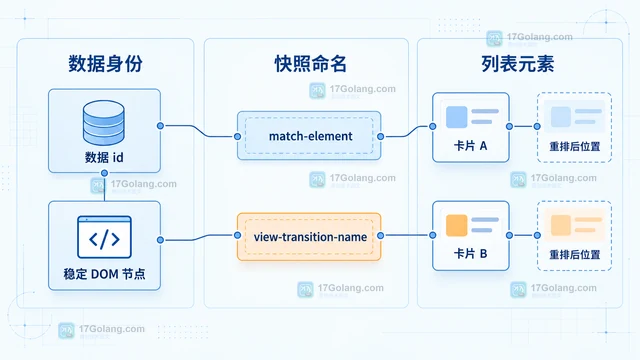
- 文章 · 前端 | 23小时前 | 前端开发 · 前端动画 View Transition API 列表重排 match-element
- View Transition API 如何为列表重排添加过渡
- 158浏览 收藏
-
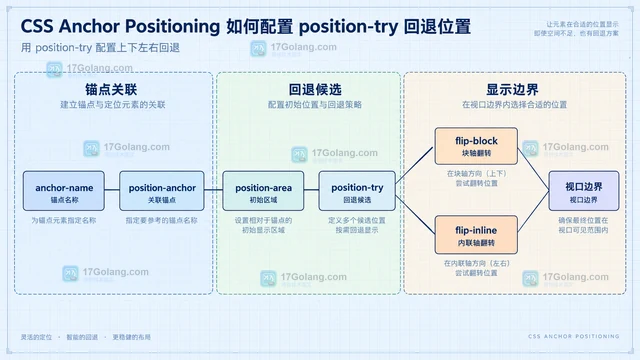
- 文章 · 前端 | 1天前 |
- CSS Anchor Positioning 如何配置 position-try 回退位置
- 234浏览 收藏
-
- 文章 · 前端 | 1天前 | 前端 · 性能优化 ·
- 前端性能预算怎么落地:图片、脚本与交互延迟阈值
- 446浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 395次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 476次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 481次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 426次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 251次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览